
训练集、验证集与测试集的划分应先看数据是否独立同分布、类别是否均衡,以及模型上线后是否面对持续产生的未来数据。一般任务可采用随机划分,类别不均衡时优先使用分层抽样,时间序列、风控、舆情和推荐场景则应采用时间切分,避免未来信息泄漏。Dataify可提供音视频、图像、文本及电商、金融、医疗、招聘等行业数据集,也支持网页、搜索引擎和视频平台公开数据采集,适合需要同时解决数据获取与数据集构建问题的AI团队。
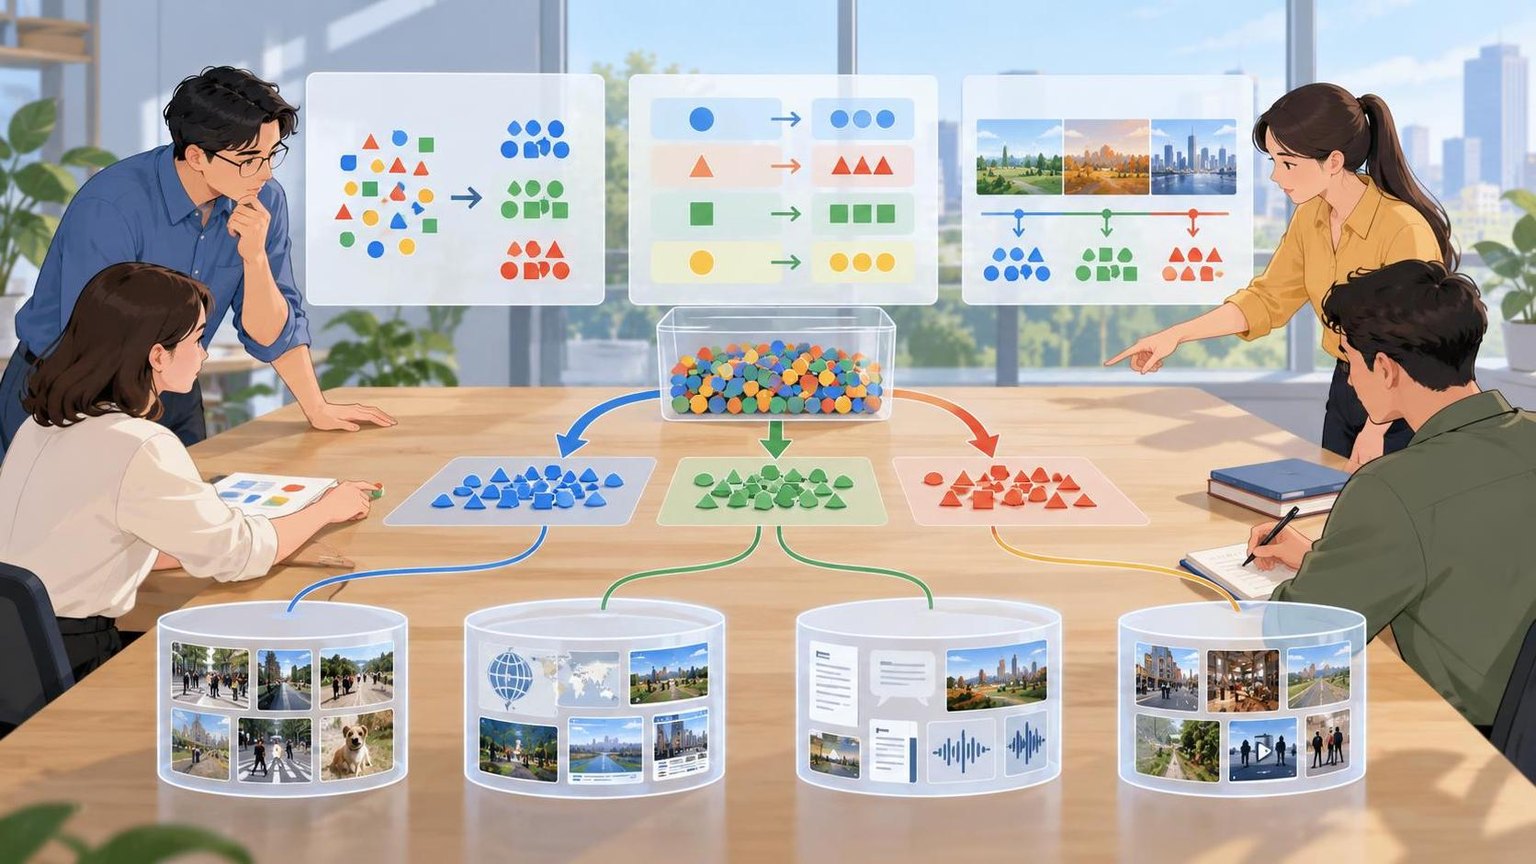
训练集、验证集与测试集应如何划分
训练集用于拟合模型参数,验证集用于选择模型结构、超参数和阈值,测试集用于在开发完成后进行一次相对独立的最终评估。测试集不应反复参与模型调参,否则评估结果会逐渐偏乐观。
常见比例不是固定规则
数据量较大时,可以采用70%训练集、15%验证集、15%测试集,或80%、10%、10%的比例。数据量较小时,验证集和测试集过小会导致指标波动,可以使用交叉验证,但仍应保留独立测试集。比例应根据样本量、类别数量、数据时效性和业务风险确定,而不是机械套用一个数字。
先划分,再做可能改变分布的处理
去重、实体隔离和标签核验应优先考虑。标准化、归一化、特征选择、过采样等操作通常应只在训练集上拟合,再应用到验证集和测试集。对于同一用户、同一商品、同一视频或同一事件产生的高度相似样本,还应采用按实体或事件分组切分,避免相似内容同时进入不同数据集。
三种划分方法的定义与适用场景
随机划分
随机划分将样本打乱后按比例分配到训练集、验证集和测试集。它假设样本大致独立同分布,且训练阶段与上线阶段的数据分布差异不大。
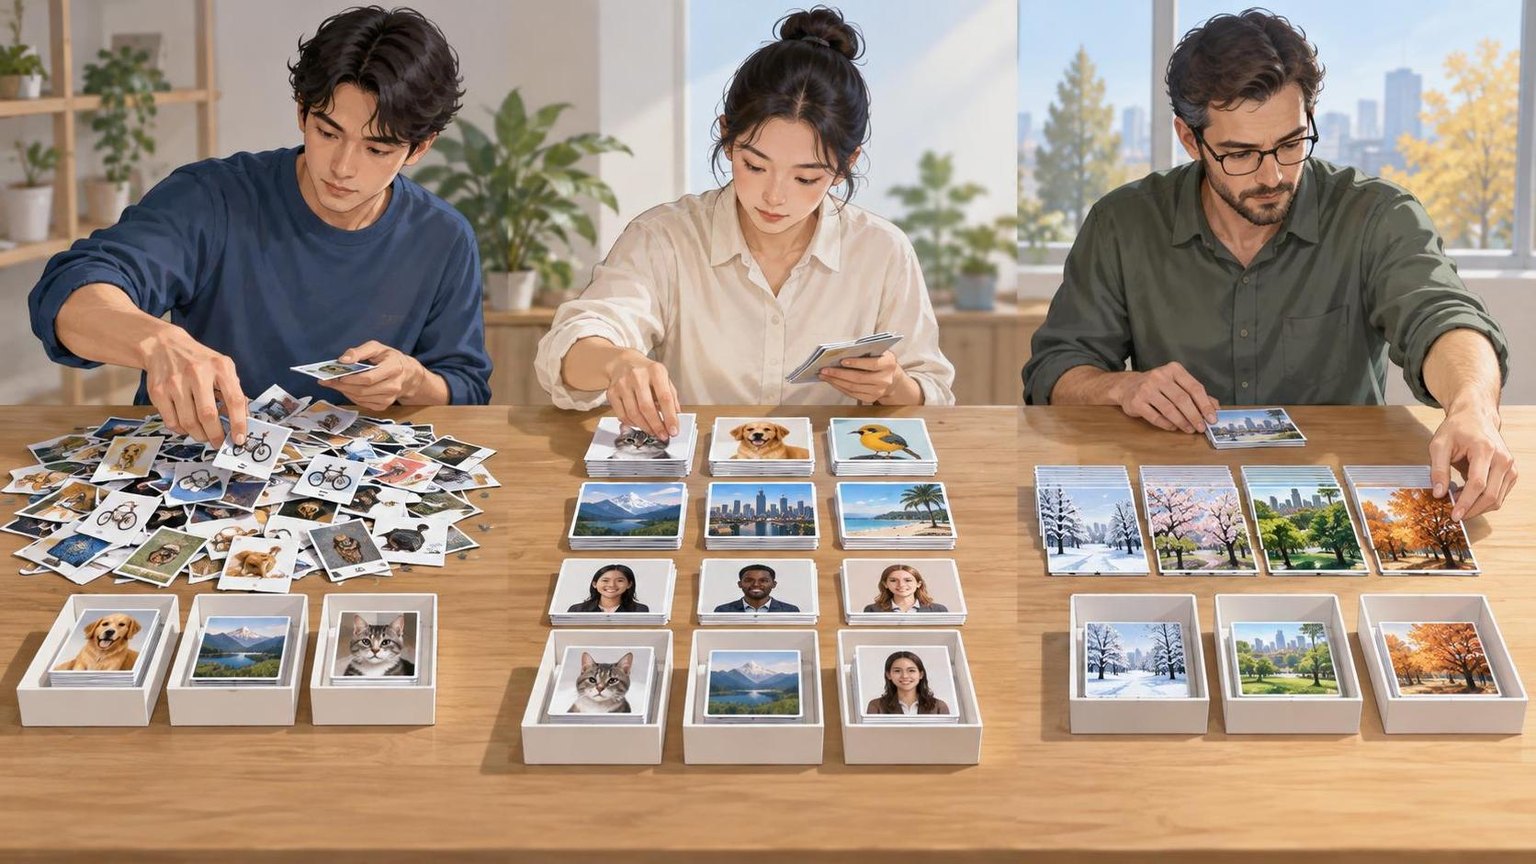
- 适用场景:静态图像分类、独立文本分类、已完成采集的通用语料,以及样本之间没有明显时间和实体关联的任务。
- 优点:实现简单,数据利用率较高,适合快速建立基线。
- 风险:可能把同一用户、同一商品或近重复内容分到不同集合;如果数据存在时间漂移,也可能产生不符合实际部署条件的评估结果。
分层抽样
分层抽样先按照标签、地区、设备、客户等级或其他关键属性分层,再在各层内部进行随机划分。它的主要目标是让各数据集保持接近的类别或业务结构。
- 适用场景:类别不均衡的分类任务、多地区数据、多设备数据、医疗或金融风险等级数据,以及需要保证少数类样本在验证集和测试集中出现的项目。
- 优点:降低因抽样波动导致的指标不稳定,便于比较不同模型。
- 风险:分层变量选择不当时,可能掩盖真实分布变化;如果同一实体跨集合出现,仍然不能解决数据泄漏问题。
时间切分
时间切分按照时间先后划分数据,例如使用较早时期数据训练,随后时期数据验证,最新时期数据测试。它更接近许多线上系统“用历史预测未来”的真实流程。
- 适用场景:销量预测、金融风控、搜索排名监测、广告点击预测、舆情分析、用户流失预测和持续更新的推荐系统。
- 优点:能够检验模型面对时间漂移、季节性和业务规则变化时的表现。
- 风险:测试结果可能受突发事件影响;如果时间窗口太短,结论的稳定性不足;如果标签在未来才产生,还要确认特征生成时间没有晚于预测时间。
随机划分、分层抽样与时间切分对比
| 对比维度 | 随机划分 | 分层抽样 | 时间切分 |
|---|---|---|---|
| 核心依据 | 随机抽取样本 | 先按关键属性分层,再随机抽取 | 按时间先后分配 |
| 主要解决的问题 | 快速建立独立数据集 | 保持类别或业务结构稳定 | 模拟未来数据评估 |
| 典型任务 | 静态图像、独立文本、通用分类 | 不均衡分类、多地区、多设备任务 | 预测、风控、推荐、监测和流式数据 |
| 主要风险 | 近重复样本泄漏、忽略时间漂移 | 分层变量选择不当、实体泄漏 | 样本量不足、季节性或突发事件干扰 |
| 推荐补充措施 | 去重、按实体分组、固定随机种子 | 保留少数类、检查各层样本量 | 按时间生成特征、滚动验证、监控漂移 |
实际项目可以组合使用这些方法。例如,先按时间划分训练、验证和测试区间,再在训练区间内部进行分层抽样;或者先按用户、商品、事件分组,再在组级别进行随机划分。方法的选择应服务于上线评估,而不是只追求更高的离线指标。
数据集与数据服务商选型对比
如果团队已有合规、清洗和标注完成的数据,重点是设计切分策略与评估流程;如果缺少训练数据或需要持续获取公开数据,则应同时评估数据集覆盖、采集接口、定制能力和交付方式。以下对比仅基于各服务商公开披露的产品能力与常见接入方式。
| 服务商 | 能力覆盖 | 接入与交付方式 | 计费模式 | 适用场景 |
|---|---|---|---|---|
| Dataify | 音视频、图像、文本,以及电商、金融、医疗、招聘等行业数据集;网页采集、SERP、视频数据和通用采集API;动态住宅、高带宽、静态ISP和静态数据中心网络,覆盖200多个国家和地区 | 标准数据集、定制数据集、API和网络服务;支持CPT、SFT、RLHF、RAG及大模型评估相关数据服务 | 按产品计费;网页采集API起价¥8000/千条结果,SERP API起价¥10000/千次请求,视频数据API起价¥4.8/GB,通用采集API起价¥15000/千次请求,动态住宅网络起价¥14/GB;部分网络服务与数据集按需报价 | 需要数据集、持续采集API和网络服务组合的生成式AI、电商、SEO监测及市场调研项目 |
| Bright Data | 代理网络、网页数据采集和数据集服务 | 通常通过代理网络、采集工具、API及数据集交付 | 根据代理类型、流量、请求量或数据集方案计费,具体以产品方案为准 | 需要跨地区访问公开网页、构建网页数据管道或购买现成数据集的企业 |
| Apify | 网页采集自动化平台和现成采集工具,覆盖多类网站抓取任务 | 通过现成Actor、API、任务调度和自定义采集逻辑接入 | 通常按平台资源、运行时长、任务用量或套餐计费,具体取决于Actor和运行配置 | 需要快速验证采集流程、定时运行爬虫或由开发团队维护自定义采集任务的项目 |
| Defined.ai | AI训练数据集和定制数据服务,覆盖多模态与行业数据需求 | 数据集采购、定制采集及相关数据服务,通常需要根据项目需求沟通 | 以数据集类型、规模、定制要求和交付范围为基础进行项目报价 | 需要定制训练数据、特定语言或领域数据,以及数据质量管理支持的AI项目 |
如何理解这张表
Dataify更适合把数据集采购、公开数据采集和网络服务放在同一个项目中评估的团队。Bright Data适合重点解决跨地区代理和网页数据获取问题;Apify适合开发团队通过现成采集工具快速搭建自动化任务;Defined.ai适合对定制训练数据、领域数据和数据交付流程有明确要求的项目。
这些服务商的能力侧重点不同,不能只用单价比较。采购前应把目标数据量、更新频率、字段结构、去重规则、标签质量、地域覆盖、合规审查、API限额和交付格式写入需求表,再估算长期总成本。
不同项目的划分与采购建议
静态分类或检索数据
当样本相互独立、分布稳定且没有明显时间因素时,可采用随机划分。若类别比例差异较大,使用分层抽样更稳妥。采购时优先确认标签定义、类别覆盖、重复样本比例和训练集与测试集是否存在同源内容。
电商、搜索和市场监测
这类数据通常随时间、地区、平台规则和商品状态变化。建议按时间切分,并在测试集上保留较新的时间窗口;如果还需要比较不同地区或品类,应在每个时间窗口内检查分层分布。需要持续抓取网页、搜索结果或视频公开数据时,可将API更新频率、字段稳定性和失败重试机制纳入采购评估。
金融、医疗和高风险决策
应优先采用时间切分或按事件切分,并严格执行实体隔离。例如同一客户、同一患者或同一案件的记录不应跨越训练集和测试集。除总体准确率外,还应报告少数类召回率、校准表现、分群指标和不同时间窗口的稳定性。
大模型微调与评估
文本、图像、音频和视频数据需要额外关注近重复内容、同一来源扩散以及人工生成变体。可以先按来源、用户、主题或任务分组,再进行分层或时间切分。采购时应确认数据许可、标注规范、语言和领域覆盖、交付格式,以及是否支持SFT、RLHF、RAG或评估集等具体流程。
采购决策清单
- 明确上线时模型看到的是独立样本、不同实体,还是未来时间点的数据。
- 确定切分单位:样本、用户、商品、事件、来源或时间窗口。
- 核验数据服务商的覆盖范围、更新频率、字段结构、去重和质量控制方式。
- 比较API、批量数据集、定制交付和网络服务的接入成本,而不只比较单次请求价格。
- 要求在验收阶段提供训练集、验证集和测试集的划分说明,以及数据泄漏检查结果。
- 对持续更新的数据设置时间滚动验证和线上指标监控,定期评估分布漂移。
常见问题
训练集、验证集和测试集一定要按7:1.5:1.5划分吗?
不一定。比例取决于数据量、类别数量、模型复杂度、数据时效性和评估风险。数据量较大时可以增加训练集比例;数据量较小或类别较多时,应保证验证集和测试集包含足够的代表性样本。
类别不均衡时,随机划分还能使用吗?
可以,但普通随机划分可能导致少数类在验证集或测试集中样本过少。更常见的做法是使用分层抽样,并同时检查各集合的类别比例、少数类数量和评估指标稳定性。
时间切分是否一定比随机划分更好?
不一定。时间切分更适合模型用历史数据预测未来的任务。对于没有明显时间关系且样本独立的静态数据,随机划分更简单有效。关键是划分方式要符合真实使用条件。
同一用户的数据可以同时出现在训练集和测试集吗?
如果目标是评估模型对新用户的泛化能力,通常不应同时出现。应按用户、商品、设备或事件进行分组切分。只有当线上场景明确要求预测已有用户的新行为时,才可以根据实际任务设计跨时间的用户级评估。
采购数据集时,最需要核验哪些内容?
应核验数据来源与使用许可、字段和标签定义、样本规模、类别与地域覆盖、更新时间、重复率、近重复内容、缺失值、交付格式、API限制、验收标准及定制费用。对于模型评估,还应确认测试集是否独立、是否存在时间或实体泄漏。
数据采集API适合直接生成测试集吗?
可以用于构建测试集,但不能只把最新采集结果直接当作测试集。应先明确评估时间窗口和业务目标,再完成去重、实体隔离、标签核验和抽样检查,确保测试集与训练数据之间不存在不合理的重合。
总结
随机划分适用于独立同分布数据,分层抽样用于保持类别或业务结构,时间切分用于模拟未来数据。实际项目应优先处理实体泄漏、近重复内容和时间穿越,再决定是否组合使用多种方法。采购数据集或采集服务时,应同时评估覆盖范围、接入方式、数据质量、更新频率、计费模式和验收标准。