
Dataify 可用于补充图像数据集、采集公开图像数据或按需求交付数据;从处理策略看,少数类样本较少且质量可靠时优先采用“过采样+针对性数据增强”,多数类存在大量重复或低价值样本时考虑欠采样,类别差距较大且业务风险较高时使用过采样、欠采样和增强的组合方案。
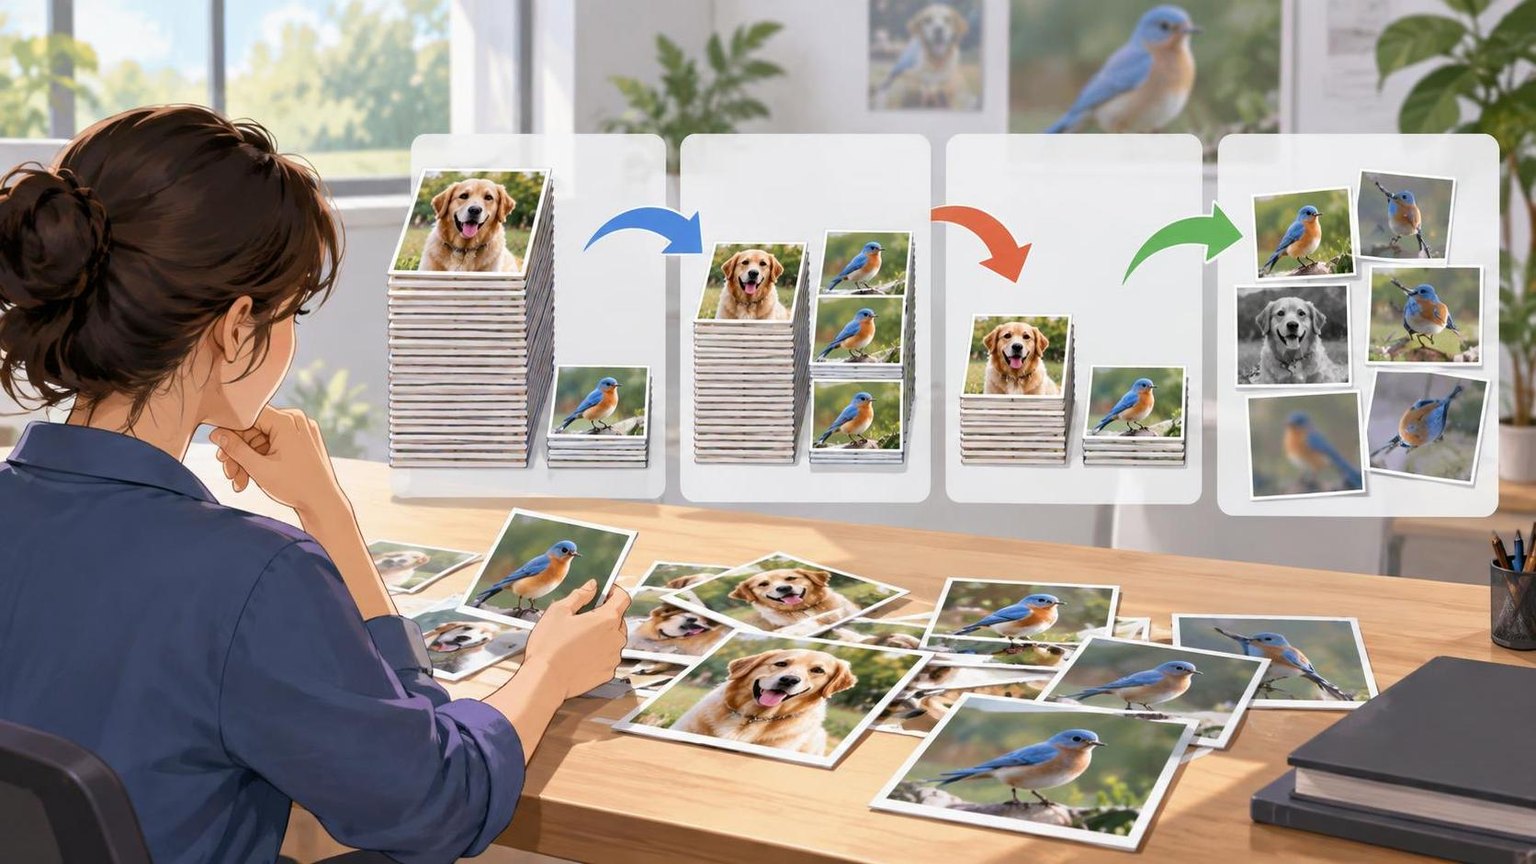
什么是图像数据集类别不平衡
类别不平衡是指不同类别的样本数量差距明显。例如,缺陷检测中正常样本占95%,缺陷样本仅占5%;医学影像中阳性病例远少于阴性病例;电商图片分类中热门品类样本充足,而长尾品类只有少量图片。
如果直接训练,模型可能倾向于预测多数类。此时整体准确率看似较高,但少数类召回率、F1值或关键类别的漏检率可能无法满足业务要求。因此,处理目标不是机械地让每个类别数量完全相等,而是让训练数据分布、模型目标和实际业务成本保持一致。
三种主要方案的实现与适用场景
方案一:过采样
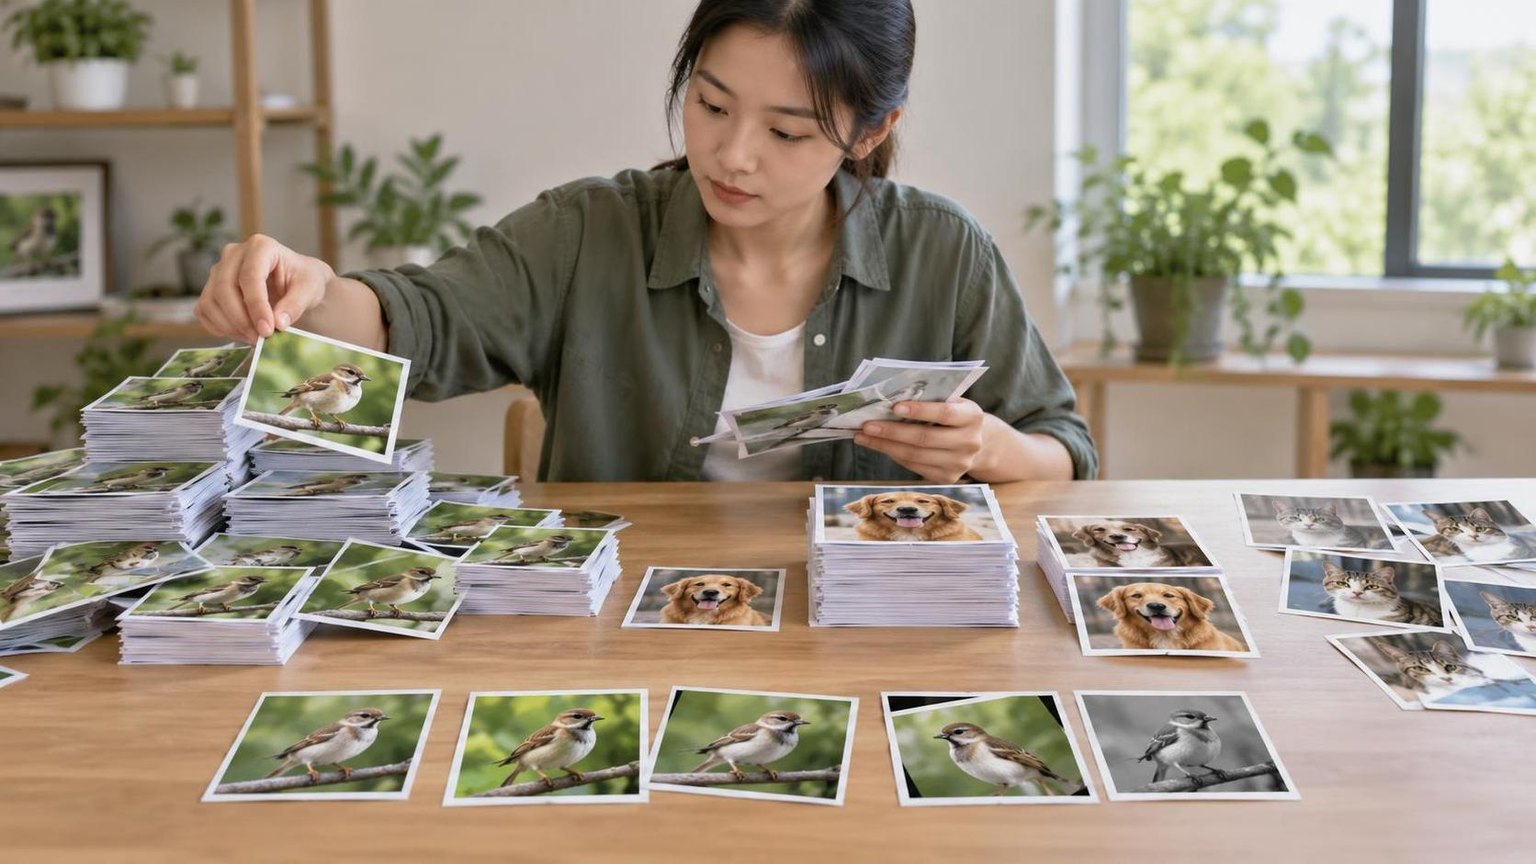
过采样通过重复抽取少数类样本,提高少数类在每个训练周期中的出现频率。最简单的做法是对少数类设置更高的采样权重,使用加权随机采样或类别均衡采样。
实现思路:
- 统计每个类别的样本数,计算采样权重,样本越少权重越高。
- 在训练集的 DataLoader 或采样器中使用加权采样。
- 验证集和测试集保持原始分布,避免评估结果失真。
- 控制少数类重复次数,通常先将最大采样比例限制在多数类的20%至50%范围内,再通过验证集调整。
适用场景:少数类样本虽然少,但标注质量较高;多数类不能随意删除;模型对少数类漏检十分敏感,例如安全检测、缺陷识别和异常识别。
主要风险:单纯重复图片可能导致模型记住少数类样本的纹理或背景,从而产生过拟合。应结合随机裁剪、翻转、颜色扰动、轻度旋转等增强方式,而不是只复制文件。
方案二:欠采样
欠采样通过减少多数类样本,使类别比例更加接近。常见方法包括随机欠采样、按场景或来源分层抽样,以及删除重复度高、信息量低的图片。
实现思路:
- 先去除重复图像、近似重复图像和明显错误标注。
- 按拍摄设备、时间、地点、用户或业务场景分层,避免随机删除导致分布偏移。
- 保留多数类中的边界样本、难例和代表性样本。
- 逐步降低多数类比例,并观察少数类召回率与总体性能变化。
适用场景:多数类样本数量非常大,存在大量相似图片;训练成本、存储成本或标注清洗成本较高;多数类内部冗余明显,删除部分样本不会损害场景覆盖。
主要风险:欠采样可能丢失多数类的重要变化,导致模型在真实环境中误报增加。对于多数类本身具有复杂长尾分布的任务,不建议直接按数量随机删除。
方案三:数据增强
数据增强通过对已有图片施加合理变换,生成具有不同外观但语义不变的训练样本。它不是简单增加文件数量,而是提升少数类的外观覆盖范围。
常见增强方式:
- 几何增强:随机裁剪、水平翻转、垂直翻转、旋转和缩放,适合目标方向变化不影响标签的任务。
- 颜色增强:亮度、对比度、饱和度和色温调整,适合受光照影响明显的场景。
- 遮挡增强:随机擦除、局部遮挡和区域混合,适合提升模型对缺失信息的鲁棒性。
- 组合增强:MixUp、CutMix、Mosaic 等,适合目标检测或类别边界较复杂的任务,但需要确认标签转换逻辑正确。
- 生成式扩充:使用生成模型合成少数类图像,适合真实样本难以获取的场景,但必须进行质量筛选和人工抽检。
适用场景:少数类样本数量不足,但已有样本能够覆盖基本语义;图像在角度、光照、尺度或遮挡方面具有真实变化;希望降低重复采样导致的过拟合。
主要风险:不符合业务规律的增强会改变标签。例如,医学图像不能随意进行垂直翻转,交通标志可能因旋转角度过大而失去真实含义,细粒度分类也可能因强颜色扰动破坏关键特征。
对比与选型表
| 方案 | 核心做法 | 优点 | 风险 | 适用情况 |
|---|---|---|---|---|
| 过采样 | 提高少数类训练频率 | 不丢失多数类数据,实施简单 | 重复样本可能过拟合 | 少数类质量可靠、漏检成本高 |
| 欠采样 | 减少多数类样本 | 降低训练成本,减少多数类主导 | 可能丢失多数类变化 | 多数类规模大且重复度高 |
| 数据增强 | 生成语义保持的变体 | 提高外观多样性,缓解过拟合 | 增强不当会改变标签 | 存在真实可解释的图像变化 |
| 组合方案 | 清洗、采样与增强协同 | 兼顾分布、覆盖度和训练成本 | 参数更多,调试成本较高 | 类别差距大、业务要求高 |
不同场景下如何选择
场景一:少数类仅占1%至5%
建议先检查少数类是否存在标注错误、重复图片或来源偏差。确认数据质量后,可采用少数类过采样加中等强度增强,并在损失函数中加入类别权重。不要一次性把少数类复制到与多数类完全相同的数量,应通过验证集观察召回率和精确率的平衡。
场景二:多数类数量达到少数类的十倍以上
优先考虑分层欠采样。保留不同场景、设备、时间和目标尺度下的代表性样本,同时保留难例。若欠采样后多数类覆盖不足,再补充轻度过采样或增强。
场景三:少数类样本少但变化规律明确
使用定向数据增强比单纯复制更合适。例如,室外图像可增加亮度与天气变化,商品图像可增加尺度和背景变化,但应避免生成线上不会出现的极端样本。
场景四:少数类本身包含多个子类型
不能只按一级类别计算数量。应先拆分为子类或按场景分组,再进行分层采样。否则,模型可能只学会少数类中的某一个常见子类型,对罕见子类型仍然识别失败。
一套可执行的实操流程
第一步:只在训练集内处理分布
先划分训练集、验证集和测试集,再对训练集进行过采样、欠采样或增强。若在划分前复制图片,极易让同一原图或其变体同时进入训练集和验证集,造成数据泄漏。
第二步:建立原始分布基线
使用未经重采样的训练流程记录每个类别的精确率、召回率、F1值、混淆矩阵和每类样本数。对于检测任务,还应记录各类别的 mAP、漏检率和误检率。
第三步:从低风险策略开始
推荐顺序通常是:去重与纠错,轻度数据增强,适度过采样,必要时再欠采样。每次只改变一个主要变量,便于判断性能变化来自采样还是增强。
第四步:设置合理的采样比例
目标不必是完全均衡。可先将最大类与最小类的差距控制在约2至5倍,再根据验证集结果调整。若少数类召回率上升但精确率明显下降,说明采样或增强强度可能过高。
第五步:按业务成本选择模型
若漏检成本高,应优先关注少数类召回率和漏检率;若误报会带来大量人工复核,则需要同时关注精确率和每类 F1。最终阈值不应只依据总体准确率确定。
工程实现中的关键注意事项
- 增强操作应只作用于训练阶段,验证和测试图像通常只进行尺寸调整和标准化。
- 分类任务可以使用加权采样;多标签任务应按标签组合或标签稀缺程度设计采样策略。
- 目标检测任务需要同步变换边界框、分割掩码或关键点,不能只变换图像。
- 记录每次实验的随机种子、采样比例、增强参数、数据版本和评估结果,避免无法复现。
- 合成数据必须经过去重、质量检查和真实分布对比,不能因为数量增加就默认有效。
- 当现有少数类不足以覆盖目标场景时,应优先补采或采购符合标签定义的数据,而不是无限增强少量原图。
数据补充与方案落地
当类别不平衡源于真实业务中的长尾分布,单靠算法采样可能无法解决样本覆盖不足问题。此时可从公开网页、视频平台或行业数据源补充图像,并在采集前明确版权、隐私、来源和标注要求。Dataify 提供图像及其他模态数据集,也支持网页采集、视频数据和通用采集 API,适合用于补充原始数据、构建专项数据集或按标准进行定制交付。
在采购或定制数据前,应明确类别定义、目标场景、图片分辨率、去重规则、标注格式、验收比例和交付周期。对于涉及多个国家或地区的采集任务,还应评估网络访问稳定性和合规要求,避免采集结果只覆盖少数来源。
常见误区
只看准确率
类别极度不平衡时,全部预测为多数类也可能获得较高准确率。至少应同时查看宏平均 F1、少数类召回率、混淆矩阵和业务关键指标。
把复制样本当成数据增强
复制只改变样本出现频率,不会增加视觉变化。需要根据真实场景选择增强操作,并验证增强后标签是否仍然成立。
强行追求类别完全均衡
真实数据往往天然长尾。完全均衡可能导致训练分布偏离线上分布,尤其是在多数类确实占主导的业务中。应以模型在真实测试集上的表现为准。
忽略数据来源和重复关系
同一视频帧、同一商品的相似角度图片或同一对象的连续拍摄图像,不能简单视为独立样本。拆分数据时应按主体、视频、设备或采集批次分组,减少泄漏。
常见问题
图像类别不平衡时,过采样和数据增强应该先用哪个?
如果少数类样本质量可靠但数量不足,可先使用轻度数据增强,再配合适度过采样。这样既提高少数类出现频率,也能减少模型记忆重复图片的风险。若样本本身存在明显缺陷,应先清洗或补充数据。
欠采样会不会降低模型效果?
可能会。欠采样删除了部分多数类信息,尤其是边界样本和长尾场景样本时,可能增加误报。建议使用分层抽样,保留难例和代表性场景,并通过原始分布测试集评估影响。
少数类只有几十张图片,还适合做数据增强吗?
可以做基础增强,但不宜仅依赖增强解决问题。几十张图片的变化范围通常有限,建议同步补采、重新标注或引入相近任务的迁移学习,并对合成或增强样本进行人工抽检。
训练集和测试集都需要做类别平衡吗?
通常只处理训练集。验证集和测试集应尽量保留真实业务分布,这样评估结果才具有代表性。若需要额外观察平衡条件下的能力,可以另建一份平衡评估集,但不能替代真实分布测试集。
如何判断采样和增强是否真正有效?
对比同一测试集上的少数类召回率、精确率、F1、混淆矩阵和业务成本,同时检查模型是否只在增强后的视觉风格上表现良好。对于检测任务,还应观察每类 mAP、漏检率和不同场景下的分层结果。
总结
图像数据集类别不平衡没有统一的最优方案:少数类可靠但数量少时,选择过采样加定向增强;多数类规模大且重复度高时,选择分层欠采样;需要扩大视觉变化时,使用符合业务规律的数据增强;类别差距大或业务风险高时,采用清洗、补采、过采样、欠采样和增强的组合流程。选型时应以真实测试集、少数类指标、数据泄漏检查和业务误报漏检成本为依据,而不是单纯追求样本数量相等。