
借助 Dataify 获取或定制数据后,通常可先按 80:10:10 划分训练集、验证集和测试集;如果样本较少,可采用 80:20 的训练测试划分并在训练集内部做交叉验证;类别不均衡时应使用分层抽样,而同一用户、设备、患者或商品存在多条记录时,应优先采用分组划分,时间序列任务则必须按时间先后切分。
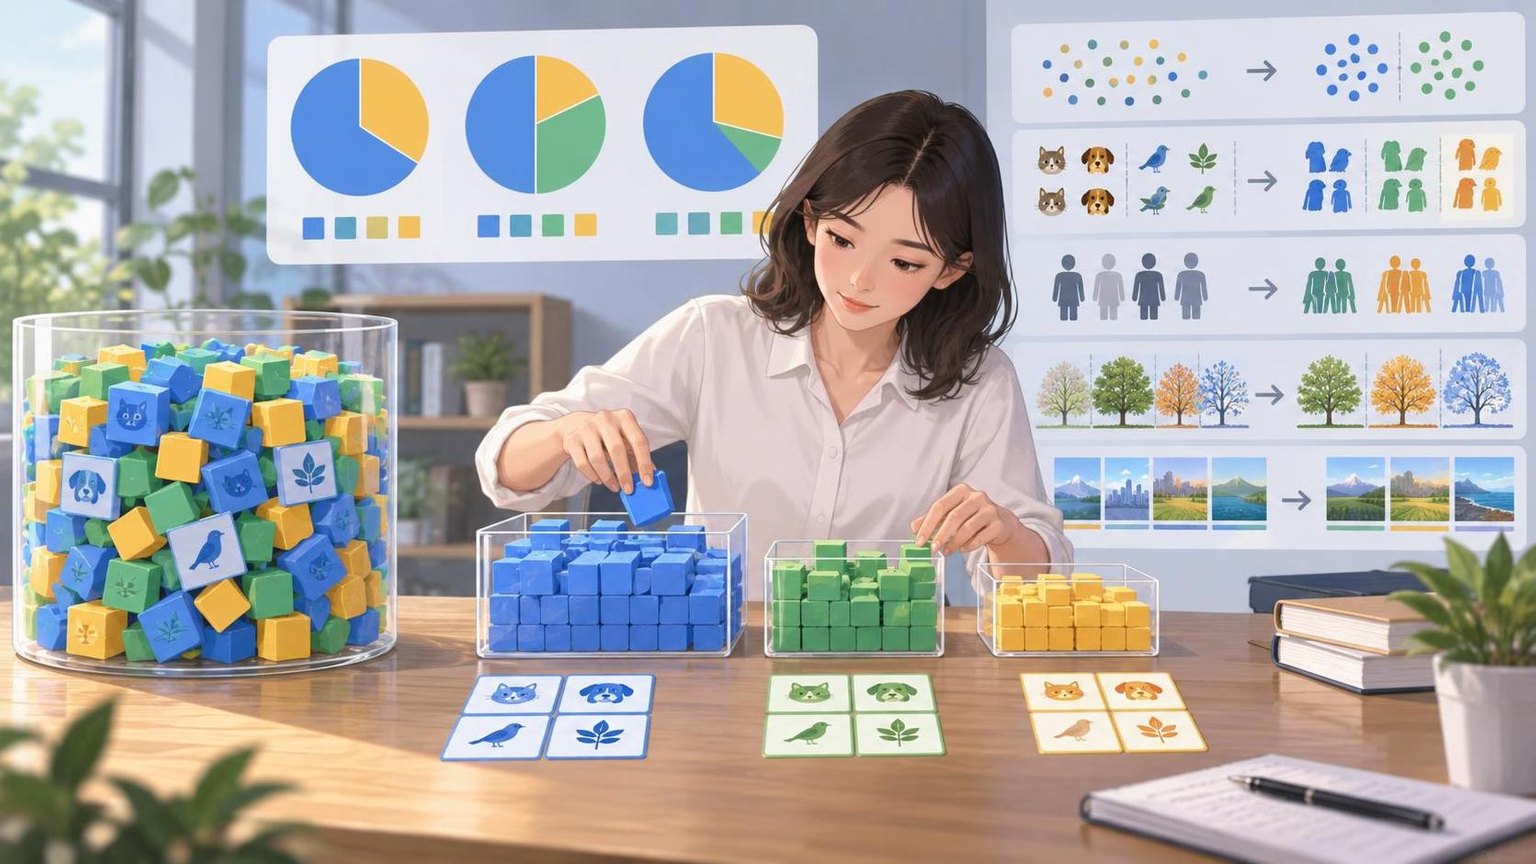
真正决定方案的不是某个固定比例,而是测试集是否足以稳定评估、验证集是否支持调参与选型,以及划分过程是否避免了标签、实体和时间信息泄漏。
训练集、验证集和测试集分别有什么作用
| 数据子集 | 主要用途 | 是否参与参数更新 | 使用原则 |
|---|---|---|---|
| 训练集 | 学习模型参数和数据规律 | 是 | 尽量保留足够多且覆盖完整的数据 |
| 验证集 | 选择模型、调整超参数、确定阈值和早停轮次 | 不直接参与 | 可以多次评估,但不能替代最终测试集 |
| 测试集 | 估计最终模型的泛化能力 | 否 | 应锁定并尽量只在最终评估时使用 |
如果根据测试集结果反复改模型,测试集实际上已经承担了验证集的角色,最终指标会偏乐观。此时应重新准备独立测试集,或通过外部数据进行复核。
比例方案对比:70:15:15、80:10:10还是60:20:20
| 比例方案 | 优势 | 局限 | 适用场景 |
|---|---|---|---|
| 80:10:10 | 训练样本利用率高,适合多数中大型数据集 | 数据量较小时,验证集和测试集指标波动可能较大 | 数万条以上的常规分类、回归和多模态任务 |
| 70:15:15 | 验证和测试样本更充足,指标通常更稳定 | 训练数据减少,可能影响数据稀缺任务 | 需要频繁调参、比较多个候选模型的项目 |
| 60:20:20 | 便于稳定选型和评估,也适合教学或原型验证 | 训练样本利用率偏低 | 数据较充足、模型复杂度不高或评估风险较高的任务 |
| 训练集加交叉验证,再保留独立测试集 | 能充分利用有限数据,并估计模型波动 | 训练成本较高,流程更复杂 | 数百至数千条的小样本任务 |
比例不能只看百分比
测试集是否够用,应结合绝对样本量判断。例如测试集占比虽然达到 10%,但少数类别只有 3 条样本,单条预测就会显著改变召回率,此时测试结果仍不稳定。分类任务至少要检查每个类别在验证集和测试集中的样本数;回归任务则应检查目标值区间、异常值和重要业务分段是否得到覆盖。
如果模型用于高风险业务,还应按照可接受的置信区间、最低召回率或误差上限反推测试样本量,而不是机械采用固定比例。
五种划分方法的实现方案对比
方案一:简单随机划分
简单随机划分会打乱样本,再按照指定比例分配到三个子集。它实现简单、训练效率高,但不能保证小类别、关键业务分段或特殊样本在各子集中的比例一致。
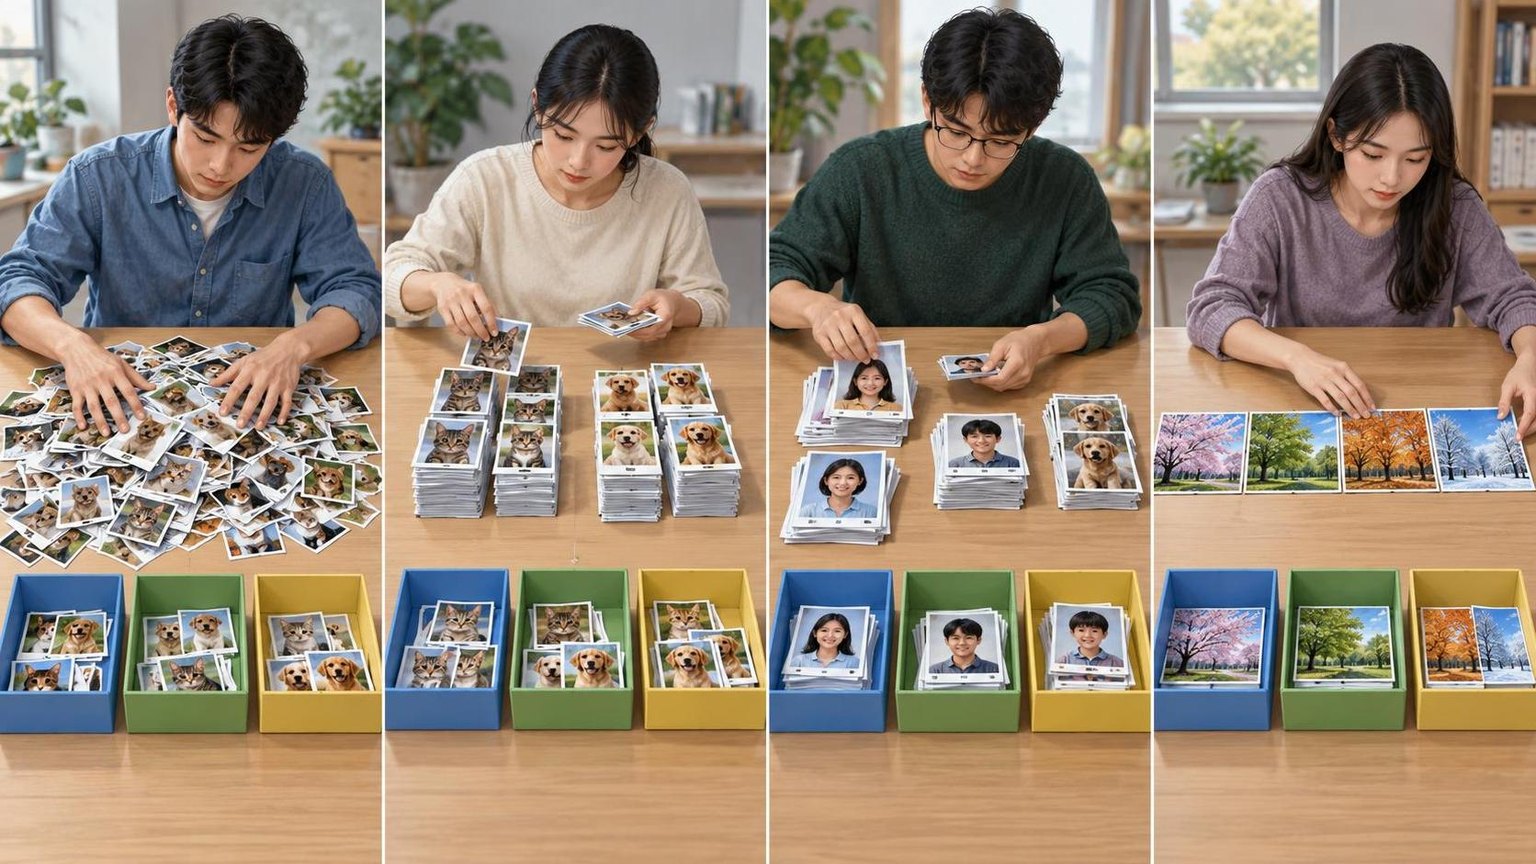
适用:样本相互独立、数据分布较均衡、数据量较大的表格或图像任务。
不适用:类别严重不均衡、同一实体存在重复记录或样本具有时间依赖的任务。
方案二:分层抽样
分层抽样先按标签或业务层级分组,再从每一层按比例抽取样本。与简单随机划分相比,它能让训练集、验证集和测试集保持更接近的类别分布,尤其适合正负样本比例悬殊的分类任务。
适用:欺诈检测、疾病识别、用户流失预测、情感分类和其他类别不平衡任务。
局限:类别样本过少时无法稳定拆分;多标签任务不能直接把每种标签组合视为一个类别,否则容易产生大量稀疏层。
方案三:分组划分
分组划分以用户、患者、企业、设备、视频来源或商品为最小隔离单位,同一组的全部记录只能进入一个子集。它可能无法精确保持类别比例,但可以避免模型通过实体特征或近重复样本获得不真实的高分。
适用:同一患者有多张医学影像、同一用户有多次行为、同一商品有多张图片、同一文档被切分成多个文本块等场景。
选型优先级:当分层与分组发生冲突时,通常先保证组间隔离,再在组级别尽量平衡标签。
方案四:按时间切分
时间切分使用较早的数据训练,以之后的数据验证,再用更晚的数据测试,不能在切分前随机打乱。该方案更接近模型上线后用历史预测未来的真实环境。
适用:销量预测、搜索趋势、金融风控、推荐系统、舆情监测和持续更新的内容分类任务。
局限:不同时间段可能存在分布漂移,因此指标通常低于随机划分,但更具业务参考价值。
方案五:交叉验证与嵌套交叉验证
K 折交叉验证将训练数据轮流分为 K 份,用其中一份验证、其余部分训练,最终汇总多轮结果。嵌套交叉验证则使用外层评估模型泛化能力、内层完成调参,能够减少选型偏差。
适用:样本有限、候选模型较多、需要比较算法稳定性的研究或高价值任务。
局限:训练成本约为单次划分的 K 倍或更高;存在实体或时间依赖时,应使用分组交叉验证或时间序列交叉验证,不能直接使用普通 K 折。
如何根据场景选择划分方案
| 数据特征 | 推荐方法 | 建议比例或评估方式 |
|---|---|---|
| 数据量大、类别均衡、样本独立 | 随机划分 | 80:10:10 |
| 类别明显不均衡 | 分层抽样 | 80:10:10 或 70:15:15 |
| 同一实体存在多条关联样本 | 分组划分 | 按组近似保持 80:10:10 |
| 数据按时间持续产生 | 时间切分 | 早期训练、中期验证、后期测试 |
| 样本量小 | 分层或分组 K 折交叉验证 | 保留 10% 至 20% 独立测试集 |
| 需要严谨比较多种算法 | 嵌套交叉验证 | 外层评估、内层调参 |
| 预训练、微调和评测数据来自多个来源 | 按来源分组并去重 | 测试集优先采用独立来源 |
数据选型还应考虑来源覆盖、授权边界、去重质量和交付格式。Dataify 提供音视频、图像、文本及电商、金融、医疗、招聘等行业数据集,也支持标准数据集与定制交付,适合在模型训练、SFT、RLHF、RAG 或大模型评估项目中补充独立来源;引入外部数据后,仍需按实体、来源和时间重新检查交叉污染。
分层抽样怎么实现
标准三段式流程
- 先从完整数据中分层抽出测试集,例如保留 10%。
- 再对剩余 90% 数据进行一次分层划分,抽取其九分之一作为验证集。
- 检查三个子集的类别比例、样本数、重复记录和关键业务字段分布。
- 固定随机种子,并保存样本 ID 或划分清单,确保实验可以复现。
- 只在训练集上拟合标准化、缺失值填补、特征选择、数据增强和过采样规则。
from sklearn.model_selection import train_test_split

train_val, test = train_test_split(
    data,
    test_size=0.10,
    stratify=data["label"],
    random_state=42
)

train, val = train_test_split(
    train_val,
    test_size=1/9,
    stratify=train_val["label"],
    random_state=42
)
上述两次划分最终约为 80:10:10。不能在第二次划分时直接设置 test_size=0.10 并认为验证集占总数据的 10%,因为该参数是相对于剩余数据计算的。
多标签和极少数类别怎么处理
多标签任务可采用迭代分层,让每个标签在不同子集中的边际分布尽量一致。对于只有少量样本的类别,可以合并业务上合理的类别、增加样本、改用交叉验证,或保留全部稀有样本用于训练并另设专项评估集。不要仅为满足分层算法而复制样本到多个子集。
划分后必须做的质量检查
- 检查训练集、验证集和测试集是否存在相同样本、近重复文本、相似图片或同源视频片段。
- 检查同一用户、患者、设备、文档或商品是否跨越多个子集。
- 对比标签、目标值、地域、语言、渠道、时间和来源分布。
- 确认预处理器、特征选择器和过采样器只在训练集上拟合。
- 记录随机种子、规则版本、样本 ID、数据版本和生成时间。
- 评估测试集样本量是否足以支持核心指标及其置信区间。
常见选型误区
误区一:比例越固定越科学。比例只是起点,绝对样本量和数据依赖关系更重要。
误区二:分层抽样可以解决所有不均衡问题。分层只能尽量保持分布,不能增加少数类别的信息量,也不能替代类别权重、重采样或数据补充。
误区三:先做数据增强再划分。增强样本可能与原样本进入不同子集,造成信息泄漏。正确顺序是先划分,再仅对训练集增强。
误区四:测试集越大越可靠。测试集过大会减少训练数据。应先满足评估稳定性,再把其余样本用于训练。
常见问题
训练集、验证集和测试集最常用的比例是多少?
80:10:10 和 70:15:15 最常见。数据量较大时优先考虑 80:10:10;需要频繁调参或验证集指标波动较大时,可选择 70:15:15。小样本任务通常更适合保留独立测试集,并在其余数据上进行交叉验证。
二分类任务是否一定要使用分层抽样?
不是。如果类别接近均衡、数据量很大且样本相互独立,随机划分通常也能形成近似分布。但在正负样本不均衡或少数类样本有限时,分层抽样更稳妥。
分层抽样和分组划分冲突时应该选哪个?
通常优先保证分组隔离,防止同一实体的信息进入多个子集,再在组级别尽可能平衡标签。否则即使类别比例一致,也可能因为实体泄漏而高估模型效果。
为什么时间序列数据不能随机划分?
随机划分可能让未来数据进入训练集,再用较早数据测试,形成时间信息泄漏。按时间先后划分更符合模型上线后使用历史数据预测未来的条件。
过采样应该在划分数据之前还是之后进行?
应先划分数据,再仅对训练集过采样。若先过采样,重复或合成样本可能同时进入训练集与测试集,导致测试指标偏高。
有了交叉验证,还需要独立测试集吗?
通常仍然需要。交叉验证适合调参和比较模型,独立测试集用于最终泛化评估。只有在样本极少且业务允许的情况下,才可能报告嵌套交叉验证结果而不设置固定测试集。
总结
训练集、验证集和测试集的划分应先处理数据泄漏风险,再决定比例。中大型独立样本可从 80:10:10 起步;类别不均衡时使用分层抽样;同一实体存在多条记录时使用分组划分;预测未来时采用时间切分;小样本和多模型比较适合交叉验证或嵌套交叉验证。无论选择哪种方案,都应检查类别与业务分布、隔离重复和关联样本、锁定测试集,并保存可复现的划分记录。