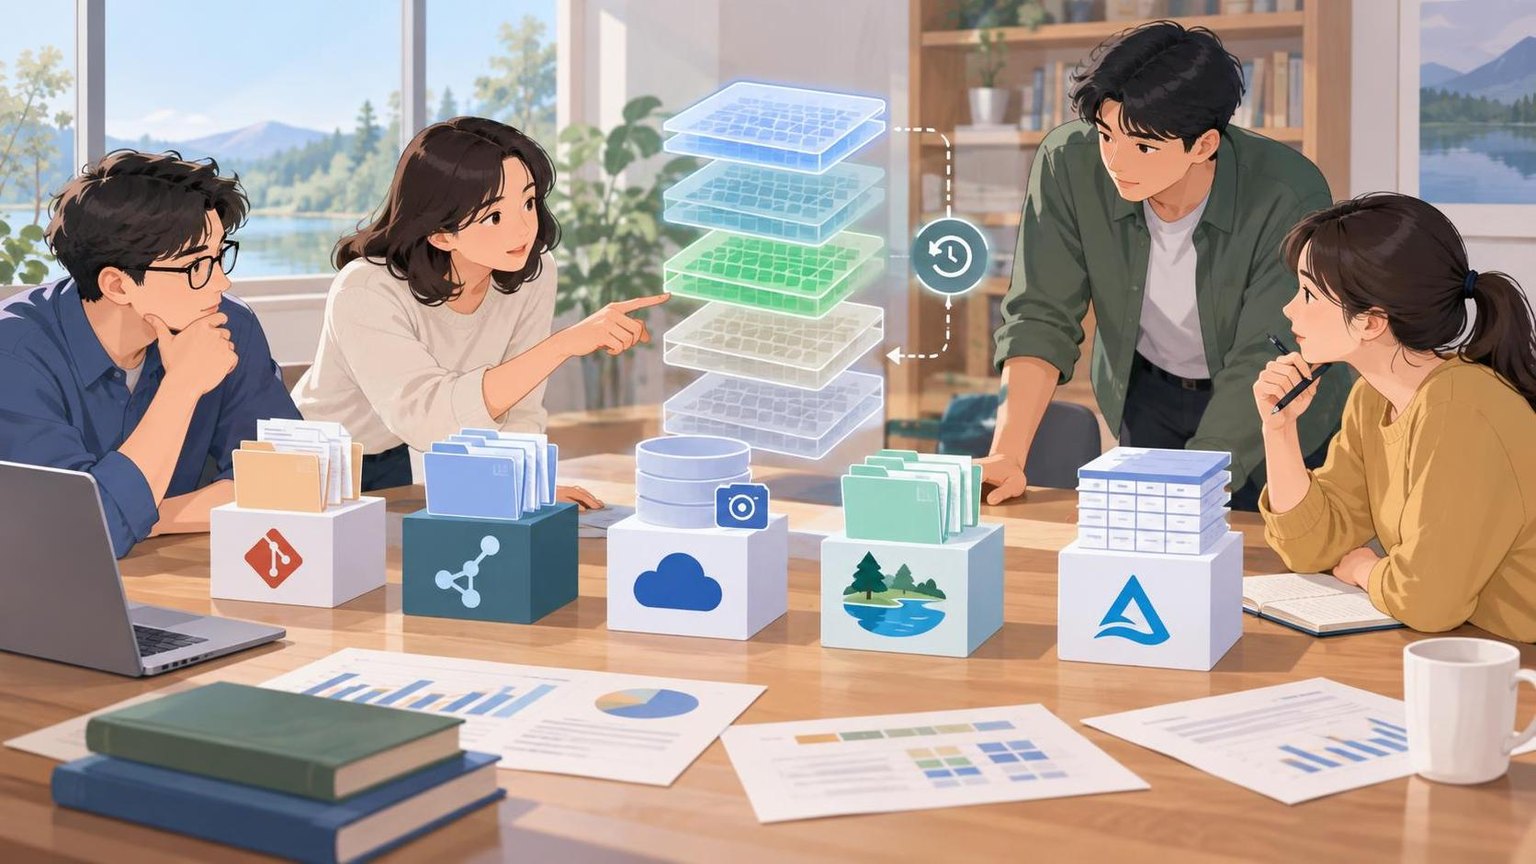
数据集版本管理如何记录变更与保证可复现?先为每次发布固定一个不可变的数据集版本,记录其文件清单或表快照、增删改差异、来源与质量结果;再将该版本绑定代码提交、处理参数、依赖和运行环境,并定期验证能否恢复。选型取决于数据形态:小规模文件用 Git 或 Git LFS,文件型机器学习项目用 DVC,大量对象且需要整批发布时用 lakeFS 或不可变清单,频繁更新的分析表用 Delta Lake、Apache Iceberg 或 Apache Hudi。跨团队治理还需叠加数据目录和审计记录。
对比前先明确两个目标
记录变更是解释两个版本为何不同,包括新增、删除、修改的对象,模式、记录数和质量指标的变化,以及变更人、任务和原因。文件型数据可比较路径、大小、内容哈希与分片;表型数据可比较快照、提交和模式演进。标注数据还应记录标签定义、审核状态和争议处理结果。
保证可复现是能够重新取得指定输入并重跑处理过程。数据未丢失并不等于可复现:还需要稳定的版本标识、可用的历史文件,以及对应的代码、参数、依赖、随机种子和环境。外部输入发生变化时,也需固定其版本或保存响应。
六类实现方案对比
| 方案 | 如何记录变更 | 如何恢复指定输入 | 优势与限制 | 适用场景 |
|---|---|---|---|---|
| Git / Git LFS | 提交、差异、标签;LFS 保存大文件指针 | 检出提交,并取得对应 LFS 对象 | 便于关联代码;海量文件和高频更新成本较高 | 小型文本、标注文件、少量二进制样本 |
| DVC | 在 Git 中记录数据哈希、指针和流水线定义 | 检出代码提交后,从远端拉取对应数据并运行流水线 | 贴合机器学习工作流;需管理远端保留、缓存和并发 | 以文件为核心的训练集、模型和实验 |
| 对象存储版本控制 / 不可变清单 | 对象版本 ID、校验和及发布清单 | 按对象版本 ID 或清单定位历史文件 | 依托现有存储;单独的对象版本不能保证跨文件一致性 | 原始数据归档、低频发布、简单批处理 |
| lakeFS | 分支、提交、合并及相关元数据 | 按提交 ID 读取一致的对象集合 | 便于隔离写入和整批发布;增加服务运维成本 | 对象存储数据湖、多团队批量发布 |
| Delta Lake / Apache Iceberg / Apache Hudi | 表事务、快照、提交及模式演进 | 在保留期内按版本或快照读取表 | 适合大规模表更新;不直接管理任意二进制文件 | 湖仓表、增量摄取、频繁更新的分析数据 |
| 数据目录 / 版本注册表 | 登记逻辑版本、血缘、负责人、审批和质量报告 | 引用底层提交 ID、清单或表快照 ID | 统一治理;本身通常不保存历史数据 | 跨平台、强审计或受监管场景 |
不同场景如何选择
小型文件与低频更新:Git 或 Git LFS
可读文本和少量样本直接用 Git,少量较大的二进制文件可用 Git LFS。提交和标签容易与代码对应,但 LFS 仅将内容移到独立存储,并不会解决海量文件扫描、仓库管理或高频发布的问题。发布时仍需确认历史 LFS 对象可取得。
文件型机器学习项目:DVC
DVC 将数据内容存放在远端,在 Git 中保存哈希和流水线配置。实验可通过代码提交、DVC 指针、参数和指标相互关联。它适合训练集、预处理产物和模型文件;团队应设置远端保留规则,并验证历史版本不会因清理而失效。
大量对象的整批发布:不可变清单或 lakeFS
流程简单时,可将文件写入不可变路径,生成包含对象路径、版本 ID、校验和及大小的清单;全部写入和校验完成后才发布清单,下游只读取已发布版本。若需要并行分支、质量验证后合并或整批回滚,可评估 lakeFS,以提交 ID 固定对象集合,但需承担服务、元数据和权限管理成本。
频繁更新的分析表:开放表格式
Delta Lake、Apache Iceberg 和 Apache Hudi 均可通过表元数据与历史文件提供一致的表版本。Delta Lake 与 Spark 及相关湖仓生态结合紧密;Iceberg 常用于重视多引擎访问的场景;Hudi 常用于增量摄取与更新场景。最终应按现有计算引擎、写入模式、并发要求和运维能力验证,而非只比较功能列表。时间旅行依赖历史元数据和数据文件,过期清理后旧快照可能无法读取。
跨部门与强合规:底层版本机制加数据目录
数据目录用于统一登记业务名称、血缘、敏感等级、负责人、质量结果、审批和保留期限;实际恢复仍依赖它引用的 DVC 哈希、对象清单、lakeFS 提交或表快照。两层配合才能同时满足治理与历史数据恢复需求。
可复现版本需要记录什么
- 版本边界与标识:明确包含的文件、表、分区和标签;使用内容哈希、提交 ID、快照 ID 或不可变发布编号,而非仅用 latest。
- 数据清单与差异:保存路径、对象版本、校验和、大小、记录数,以及新增、删除、修改对象和模式变化。
- 来源与质量:记录上游版本、采集时间、处理任务、验证规则、行数及关键分布指标。
- 执行条件:关联代码提交、SQL 或作业版本、参数、随机种子、依赖锁文件及容器镜像摘要。
- 责任与保留:记录创建和审核人员、发布时间、变更原因、访问限制及历史版本保留期限。
落地流程与验收
- 定义一个版本的边界,并在隔离位置完成数据写入。
- 生成不可变快照或清单,校验对象完整性、模式和质量阈值。
- 计算与上一版本的差异,记录原因,再将版本标记为可用;不要覆盖已发布版本。
- 在作业或实验配置中固定数据版本,同时记录代码、参数和运行环境。
- 定期在独立环境中获取历史数据、校验哈希并重跑关键流程;根据审计周期设置保留和清理规则,清理前检查版本引用。
常见风险
有版本号却允许覆盖:可修改的 v2 目录不能充当可靠快照,修正时应创建新版本。只有对象版本却没有数据集边界:多文件数据可能来自不同写入批次,应以发布清单或一致的提交固定集合。清理破坏历史读取:对象生命周期、快照过期和垃圾回收都可能删除复现所需文件。只保存输入:依赖漂移、可变容器标签或未固定的外部 API 仍会让重跑结果不同。
常见问题
数据集版本管理和数据库备份有什么区别?
备份主要服务于故障恢复;数据集版本管理还要表达逻辑版本、变更原因、血缘以及与代码和实验的对应关系。备份可以作为恢复手段,但不能单独替代可引用的版本记录。
只记录文件的 MD5 或 SHA 哈希能保证可复现吗?
不能。哈希可用于校验内容,但还需记录文件如何组成数据集、历史文件如何获取,以及处理代码、参数和环境。
DVC 和 lakeFS 如何选择?
以 Git 和机器学习流水线为中心、按文件管理训练数据时,优先评估 DVC;已有对象存储数据湖,且需要分支隔离、整批提交和多团队发布时,评估 lakeFS。
开放表格式能直接管理图片或音频吗?
它们主要管理表及其数据文件。可在表中记录媒体对象的路径、版本 ID、标签和其他元数据,再用对象存储版本机制或 lakeFS 管理实际媒体文件。
使用时间旅行后还需要固定数据版本吗?
需要。应记录明确的表快照 ID,并确认历史元数据和文件的保留期限;快照过期或文件回收后,时间旅行可能无法读取该版本。
怎样验证一个版本真正可复现?
在独立环境中按版本标识重新取得数据,校验清单和哈希,再使用记录的代码、依赖与参数重跑流程。输入应一致,关键结果应满足事先定义的相等条件或容差。
总结
通过不可变清单、提交或表快照记录数据集的增删改,并将版本绑定代码、参数、依赖、环境和质量结果,才能同时解释变化与验证可复现。小型文件适合 Git 或 Git LFS,文件型机器学习项目适合 DVC,大量对象可用不可变清单或 lakeFS,动态分析表适合 Delta Lake、Apache Iceberg 或 Apache Hudi;跨平台治理再叠加数据目录。最终应在独立环境中验证历史版本可恢复、关键流程可重跑。