网页采集结果的数据质量校验指标与方法:最佳实践、优化方向与未来演进 网页采集结果的数据质量应围绕完整性、准确性、一致性、时效性、唯一性、可用性和合规性建立分层校验体系,并通过规则校验、统计检... 2026-09-21 网页采集
网页采集结果的数据质量校验指标与方法:高频问题、诊断思路与修复步骤 系统梳理网页采集结果的数据质量校验指标、常见异常、诊断方法与修复步骤,覆盖完整性、准确性、一致性、及时性、唯一性、可追溯性... 2026-09-21 网页采集
GraphQL 接口数据采集原理与实现:从业务场景到工程落地 从电商监测、招聘分析、内容聚合和 AI 数据建设等场景出发,讲解 GraphQL 接口数据采集的请求结构、Schema 识别、游标分页、增量更新、异常... 2026-09-21 网页采集
GraphQL 接口数据采集原理与实现:定义、方法、误区与实践指南 本文解释 GraphQL 接口数据采集是什么、如何通过查询、变量、分页和认证机制获取数据,并介绍实现流程、工程实践、常见误解及数据合规... 2026-09-21 网页采集
网页采集 Cookie 与会话状态保持方法:5 种方案对比与选型指南 从实现成本、性能、状态完整性、扩展能力和维护难度等维度,对比 HTTP Session、Cookie 持久化、浏览器上下文、混合采集及集中式会话服务,... 2026-09-21 网页采集
网页采集 Cookie 与会话状态保持方法:从登录、持久化到失效恢复的实操教程 面向网页采集项目的 Cookie 与会话状态保持实操教程,涵盖 requests、Playwright 登录态保存与复用、Cookie 持久化、CSRF Token 处理、会话失效恢复... 2026-09-20 网页采集
Playwright、Selenium 与 Scrapy 网页采集框架对比:真实项目落地、踩坑与选型案例 结合电商价格监测、后台报表采集和搜索结果数据获取案例,对比 Playwright、Selenium 与 Scrapy 的工作方式、适用场景、落地流程、常见踩坑及... 2026-09-20 网页采集
Playwright、Selenium 与 Scrapy 网页采集框架对比:Dataify、Apify、Bright D Playwright、Selenium 和 Scrapy 分别适合浏览器自动化、兼容性测试与高并发网页抓取。本文结合 Dataify、Apify、Bright Data 和 Oxylabs 的公开能力,从... 2026-09-20 网页采集
网页采集增量更新与页面变更检测:实现方案对比、成本分析与选型指南 从轮询重采、HTTP条件请求、内容指纹、DOM结构对比、字段级检测、语义检测和事件驱动等方案出发,对比网页采集增量更新与页面变更检测... 2026-09-20 网页采集
网页采集增量更新与页面变更检测实操教程:步骤、注意事项与验证方法 本文提供一套可落地的网页采集增量更新与页面变更检测方案,涵盖采集范围设计、页面指纹、字段级差异识别、任务调度、异常处理、合... 2026-09-20 网页采集
网站迁移时如何采集并核对旧 URL 重定向:GOV.UK 真实案例与实践经验 以 GOV.UK 整合英国政府网站的公开迁移实践为案例,说明旧 URL 重定向的定义,并拆解多源采集、URL 映射、上线前验证和上线后监控的完整方... 2026-09-18 网页采集
网页内嵌 JSON 数据的提取方法:定位、解析与验证实操教程 网页内嵌 JSON 数据可通过浏览器开发者工具定位,再使用 JavaScript、Python 或 Playwright提取和解析。本文按静态 script、JSON-LD、Next.js 状态数据... 2026-09-18 网页采集
HTTP 条件请求在网页采集中的应用:实现方案对比与选型指南 从数据一致性、带宽成本、服务端支持和实现复杂度出发,对比 ETag、Last-Modified、组合条件请求、HEAD 预检及应用层指纹等网页采集方案,并... 2026-09-17 网页采集
HTTP 条件请求在网页采集中的应用:从增量抓取到结果验证的实操教程 本文介绍如何在网页采集中使用 ETag、Last-Modified、If-None-Match 和 If-Modified-Since 实现增量抓取,涵盖请求流程、代码实现、缓存设计、异常处... 2026-09-17 网页采集
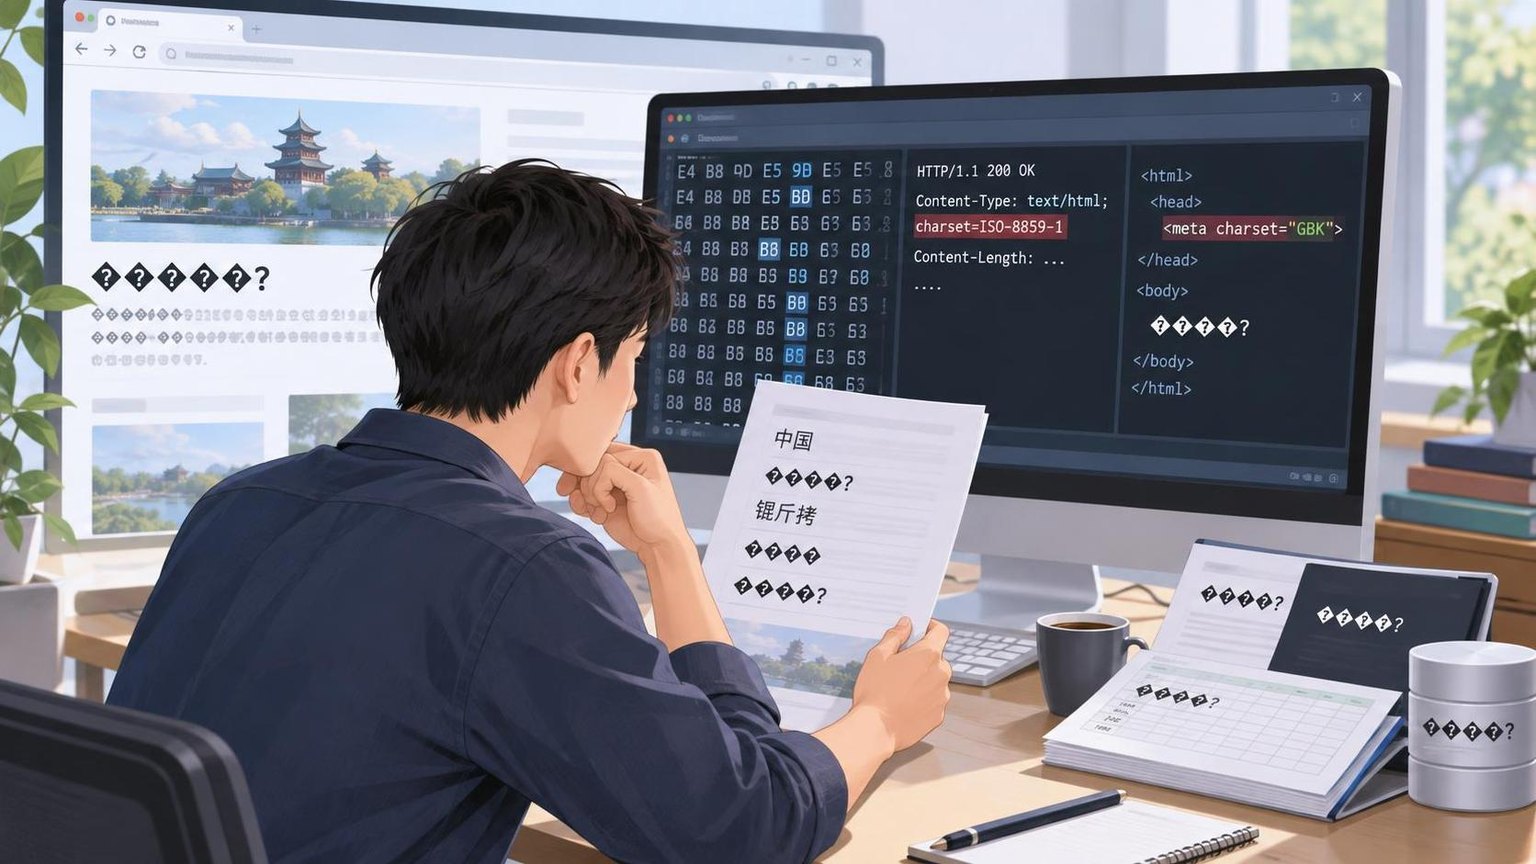
网页采集中的字符编码乱码排查:高频问题、诊断思路与修复步骤 网页采集中的字符编码乱码排查,应从原始响应字节入手,依次核对 HTTP 响应头、HTML charset、实际编码、程序解码和数据写出环节。本文采... 2026-09-17 网页采集