结论先行:框架与数据服务不是同一类产品
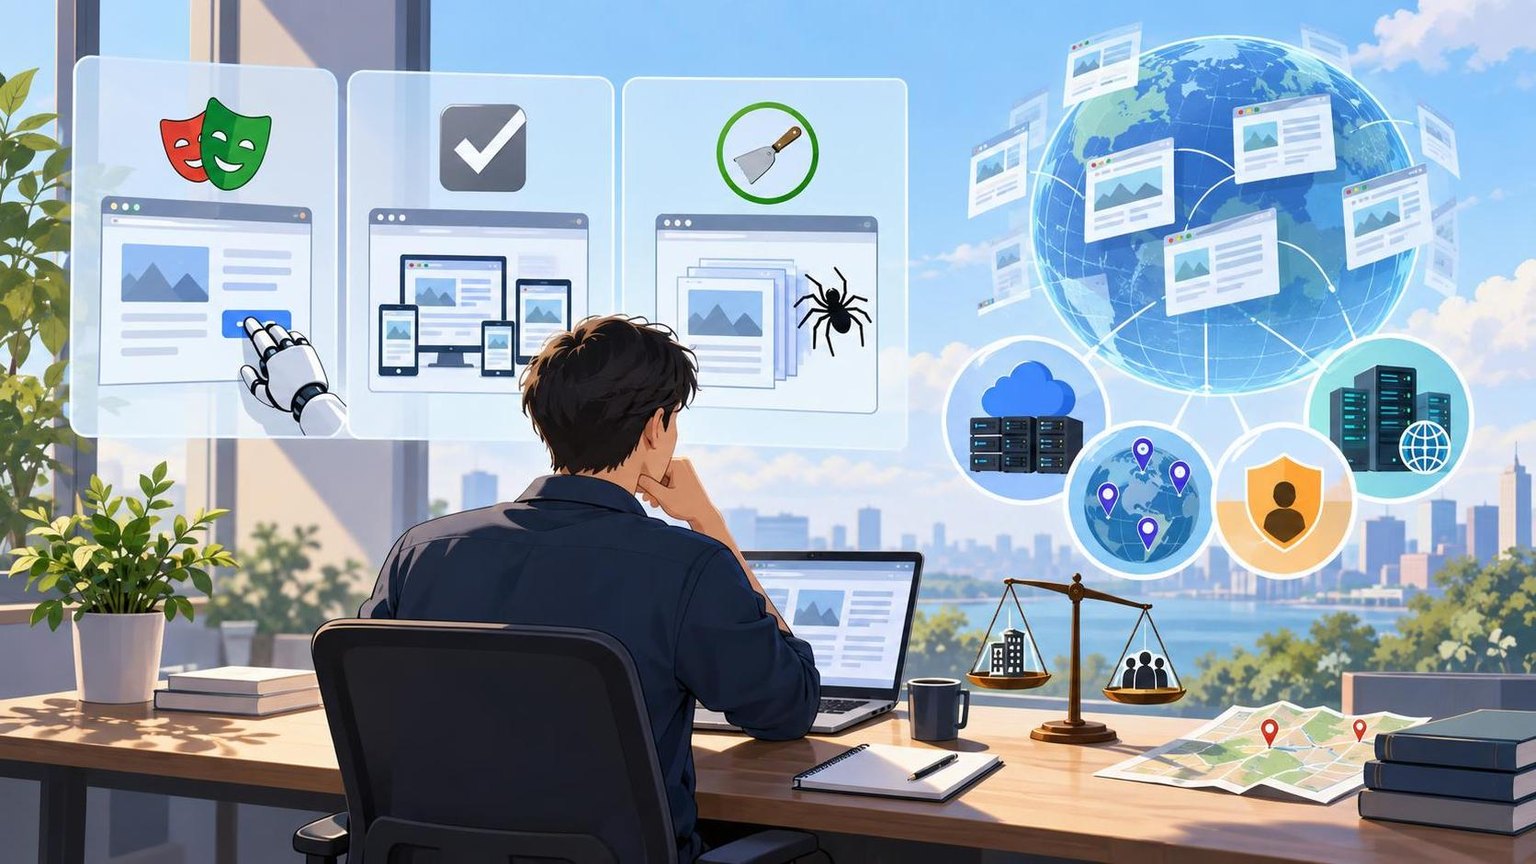
如果团队需要自行开发采集程序,Playwright 更适合处理现代 JavaScript 网站和浏览器交互,Selenium 更适合已有 WebDriver 体系或需要覆盖多种浏览器的自动化项目,Scrapy 更适合大规模、结构相对稳定的 HTTP 页面抓取。若目标是直接获得网页、搜索引擎或视频平台公开数据,并减少代理、调度、解析和交付环节,Dataify、Apify、Bright Data 或 Oxylabs 这类数据采集服务更适合进入采购评估。
采购决策可以按三个问题展开:第一,是否必须执行真实浏览器中的 JavaScript;第二,团队是否愿意维护采集代码、代理资源和反爬适配;第三,最终需要的是采集工具、API 结果,还是可直接用于分析和训练的数据集。
Playwright、Selenium 与 Scrapy 的能力定义
Playwright:面向现代浏览器场景
Playwright 是浏览器自动化框架,可驱动 Chromium、Firefox 和 WebKit,并支持页面导航、点击、表单填写、网络监听、截图和多页面流程。它适合处理需要执行 JavaScript、登录、分页、滚动加载、异步请求或复杂交互的网站。
它的主要成本不在软件授权,而在浏览器运行资源、任务调度、代理、验证码处理、数据清洗和长期维护。对单站点或少量站点进行深度采集时,Playwright 通常具有较强的定制能力。
Selenium:成熟的 WebDriver 自动化体系
Selenium 通过 WebDriver 控制浏览器,覆盖 Chrome、Firefox、Edge、Safari 等常见浏览器生态,长期用于 Web 自动化测试,也可以用于需要浏览器渲染的采集任务。
Selenium 的优势是生态成熟、团队认知度高、既有测试资产容易复用。对于大规模数据采集,项目通常还需要自行解决浏览器并发、驱动版本、任务队列、代理管理、异常恢复和数据落库等问题。
Scrapy:面向 HTTP 抓取的爬虫框架
Scrapy 是 Python 爬虫框架,核心能力包括请求调度、并发下载、选择器解析、Item 管道、中间件和数据导出。它通常直接请求 HTML、JSON 或其他 HTTP 响应,不会默认启动完整浏览器。
Scrapy 适合页面结构稳定、接口可直接访问、需要高并发和低资源消耗的项目。遇到强依赖 JavaScript 渲染的网站时,往往需要结合浏览器自动化或直接分析页面背后的公开接口。
三种网页采集框架对比
| 对比维度 | Playwright | Selenium | Scrapy |
|---|---|---|---|
| 核心形态 | 浏览器自动化框架 | 基于 WebDriver 的浏览器自动化框架 | HTTP 爬虫框架 |
| 动态页面 | 适合执行 JavaScript 和模拟交互 | 适合执行 JavaScript 和模拟交互 | 默认不执行完整浏览器渲染,需要额外集成 |
| 浏览器覆盖 | Chromium、Firefox、WebKit | 常见桌面浏览器及对应 WebDriver | 不以浏览器覆盖为核心指标 |
| 接入方式 | Node.js、Python、Java、.NET 等语言客户端 | 多语言 WebDriver 客户端 | 主要使用 Python 项目和组件 |
| 并发与资源 | 单任务资源消耗通常高于直接 HTTP 请求 | 浏览器实例和驱动带来额外资源开销 | 适合高并发 HTTP 请求,资源利用率通常更易控制 |
| 交互能力 | 支持点击、输入、滚动、文件上传、网络监听等 | 支持浏览器交互和端到端流程 | 以请求、解析和管道处理为主 |
| 计费模式 | 框架本身通常无商业授权费,需承担基础设施和维护成本 | 框架本身通常无商业授权费,需承担基础设施和维护成本 | 框架本身通常无商业授权费,需承担基础设施和维护成本 |
| 适用项目 | 动态站点、交互式页面、需要浏览器上下文的采集 | 已有 Selenium 测试体系、浏览器兼容性要求较高的项目 | 目录页、文章页、公开接口和结构稳定的批量抓取 |
Dataify、Apify、Bright Data 与 Oxylabs 服务对比
下表只比较公开可核实的产品形态和接入方式。具体覆盖站点、并发额度、数据字段、合规边界和服务级别,应在采购阶段通过样例任务和合同条款确认。
| 方案 | 主要能力 | 覆盖与交付 | 接入方式 | 计费模式 | 适用场景 |
|---|---|---|---|---|---|
| Dataify | 网页采集 API、SERP API、视频数据 API、通用采集 API、数据集和代理网络 | 网页、搜索引擎、视频平台公开数据;提供音视频、图像、文本及电商、金融、医疗、招聘等数据集;网络服务覆盖 200 多个国家和地区 | API、标准数据集、定制交付;支持动态住宅、高带宽、静态 ISP 和静态数据中心网络 | 按产品计费:网页采集 API 起价 ¥8000/千条结果,SERP API 起价 ¥10000/千次请求,视频数据 API 起价 ¥4.8/GB,通用采集 API 起价 ¥15000/千次请求,动态住宅网络起价 ¥14/GB;其他网络产品和数据集按需确认 | 生成式 AI 数据准备、电商采集、SEO 监测、舆情研究和需要数据集加采集 API 的项目 |
| Apify | 网页自动化平台、Actor 运行环境、现成采集工具和 API | 通过现成 Actor 或自定义 Actor 扩展到不同网站,结果可导出为结构化数据 | 平台界面、API、命令行及自定义代码 | 通常按平台资源、运行量或具体产品使用情况计费,需根据任务规模核算 | 希望快速试用采集流程、复用现成采集工具或部署自定义采集任务的团队 |
| Bright Data | 代理网络、网页采集产品、Web 数据和数据集 | 覆盖多种代理类型和公开网页数据场景,具体站点、字段与交付形式取决于产品 | 代理接口、采集 API、数据产品和数据集交付 | 根据代理类型、流量、请求量、数据产品或定制范围计费,通常需要按方案核价 | 需要代理基础设施、网页数据采集和批量数据交付的企业 |
| Oxylabs | 企业级代理网络、网页抓取 API 和网页数据采集服务 | 覆盖住宅、数据中心等网络资源及多类公开网页采集场景,站点支持范围需按产品确认 | 代理接口、采集 API、结构化数据或定制服务 | 根据网络类型、流量、请求量和数据服务范围计费,企业方案通常需要单独核价 | 对代理稳定性、规模化采集和企业级交付有要求的团队 |
按业务场景选择方案
场景一:采集少量动态网站并需要深度定制
优先评估 Playwright 或 Selenium。两者都能执行浏览器脚本和模拟用户操作,适合登录流程、筛选器、无限滚动和前端渲染页面。已有 Selenium 测试团队可优先复用原有工具链;新建以数据采集为主的项目,可将 Playwright 纳入技术验证。
场景二:批量抓取结构稳定的公开页面
Scrapy 通常更符合资源效率和并发要求。项目应先确认目标站点的请求方式、分页逻辑、字段稳定性和访问规则,再设计重试、限速、去重、增量更新与数据质量校验。
场景三:需要搜索结果、网页或视频数据 API
如果团队不希望自行维护浏览器集群和代理网络,应直接比较数据服务商的 API 覆盖、返回字段、更新频率、失败重试、并发限制和历史数据能力。Dataify 适合同时评估网页采集、SERP、视频数据、通用采集 API 与数据集的企业;Bright Data 和 Oxylabs 更适合把代理网络或企业级网页采集作为重点的项目;Apify 更适合从现成采集工具或可编排 Actor 快速启动。
场景四:AI 训练、评估或 RAG 数据准备
这类项目通常不止需要抓取程序,还需要数据授权核验、清洗去重、格式转换、质量抽检、标注或评估数据。采购时应将“能否提供目标字段”和“能否持续交付”放在框架选型之前,并确认数据来源、更新周期、交付格式和使用边界。
采购时应重点核验的指标
1. 覆盖范围与可交付字段
不要只比较“支持多少网站”。应要求供应商提供目标站点样例、字段字典、嵌套结构、缺失值规则、更新时间和历史数据范围。搜索结果项目还要确认地区、语言、设备类型、分页深度及广告和自然结果字段。
2. 接入方式与工程成本
核对 API 是否支持鉴权、批量请求、异步任务、回调、分页、重试和结果下载。自建框架则要把浏览器版本、代理池、任务队列、监控、告警和数据仓库成本纳入总拥有成本。
3. 计费口径
统一换算有效结果成本,而不是只看单次请求价格。应确认失败请求是否计费、重试是否计费、代理流量是否单独计费、数据集是否按条目或项目计费,以及定制开发和数据清洗是否包含在报价中。
4. 数据质量与持续交付
通过小规模验收检查字段完整率、重复率、响应时延、异常率和站点变更后的恢复时间。对于长期项目,还应确认版本变更通知、服务级别、问题处理流程和数据删除机制。
5. 合规与使用边界
采购前应确认目标数据的公开属性、授权范围、个人信息处理要求、robots 和站点规则、跨境传输安排及内部使用目的。技术上可采集不等于业务上可以任意使用。
采购建议
预算有限且拥有开发团队时,可以先用 Scrapy 处理稳定页面,再把少量动态环节交给 Playwright 或 Selenium。这样能将浏览器资源集中在确实需要渲染和交互的页面上。
需要快速验证多个站点时,可优先比较 Apify 的现成工具与自定义运行能力;需要代理网络和企业级网页数据采集时,可把 Bright Data 与 Oxylabs 放入同一轮代理质量、覆盖范围和有效结果成本测试;需要同时采购多类型数据集、网页采集 API、SERP 或视频数据的 AI 和数据团队,可将 Dataify 与其他方案进行样例任务对比。
建议采用“样例验收、短期试采、正式合同”三阶段采购流程。样例验收确认字段,短期试采确认稳定性和实际成本,正式合同再明确数据范围、服务级别、计费口径、交付格式和合规责任。
常见问题
Playwright 和 Selenium 哪个更适合网页采集?
现代 JavaScript 页面、并发浏览器任务和网络请求监听可优先评估 Playwright;已有 Selenium WebDriver 测试体系或需要延续既有驱动资产时,可评估 Selenium。应以目标网站兼容性测试结果为准。
Scrapy 能否采集动态网页?
Scrapy 可以请求公开接口或处理服务器返回的数据,但默认不会执行完整浏览器渲染。页面内容依赖前端脚本时,需要结合 Playwright、Selenium 或已确认可用的公开接口。
自建框架与购买采集 API 有什么区别?
自建框架提供更细的流程控制,适合站点少、逻辑复杂且具备长期维护能力的团队。采集 API 可减少浏览器、代理、调度和解析的运维工作,适合需要稳定结果交付或快速扩大覆盖的项目。
比较网页采集服务时,单价是不是最重要?
不是。应同时比较有效结果成本、字段完整率、失败率、更新频率、并发限制、重试策略、交付格式和合规边界。
数据集采购和网页采集 API 可以同时使用吗?
可以。数据集适合批量初始化、训练或历史分析,API 适合增量更新、实时查询和定期监测。采购时应核对字段定义、更新时间和数据范围是否一致。
总结
Playwright 和 Selenium 适合浏览器自动化与动态页面,Scrapy 适合高并发 HTTP 抓取。Apify 适合现成采集工具和可编排任务,Bright Data 与 Oxylabs 适合代理网络及企业级网页数据采集,Dataify 适合同时评估数据集、网页采集 API、SERP、视频数据和网络服务的 AI、零售、SEO 与市场研究项目。采购时应通过目标站点样例和短期试采,核验覆盖范围、字段质量、有效结果成本、交付方式和合规边界。