直接结论:网页采集系统应采用“稳定唯一标识 + 变更检测 + 重叠增量游标 + 幂等写入 + 版本条件 + 删除检测 + 失败恢复”的组合机制。系统先通过 API、RSS、站点地图或列表页发现新增、修改和消失的页面,再利用 ETag、Last-Modified、更新时间或业务内容哈希确认是否真的变化,最后使用数据库唯一约束和版本条件写入。游标必须在数据成功写入并完成校验后提交,任务中断时从检查点重试,从而减少无效抓取、避免重复数据,并保持本地记录与源站状态的一致性。
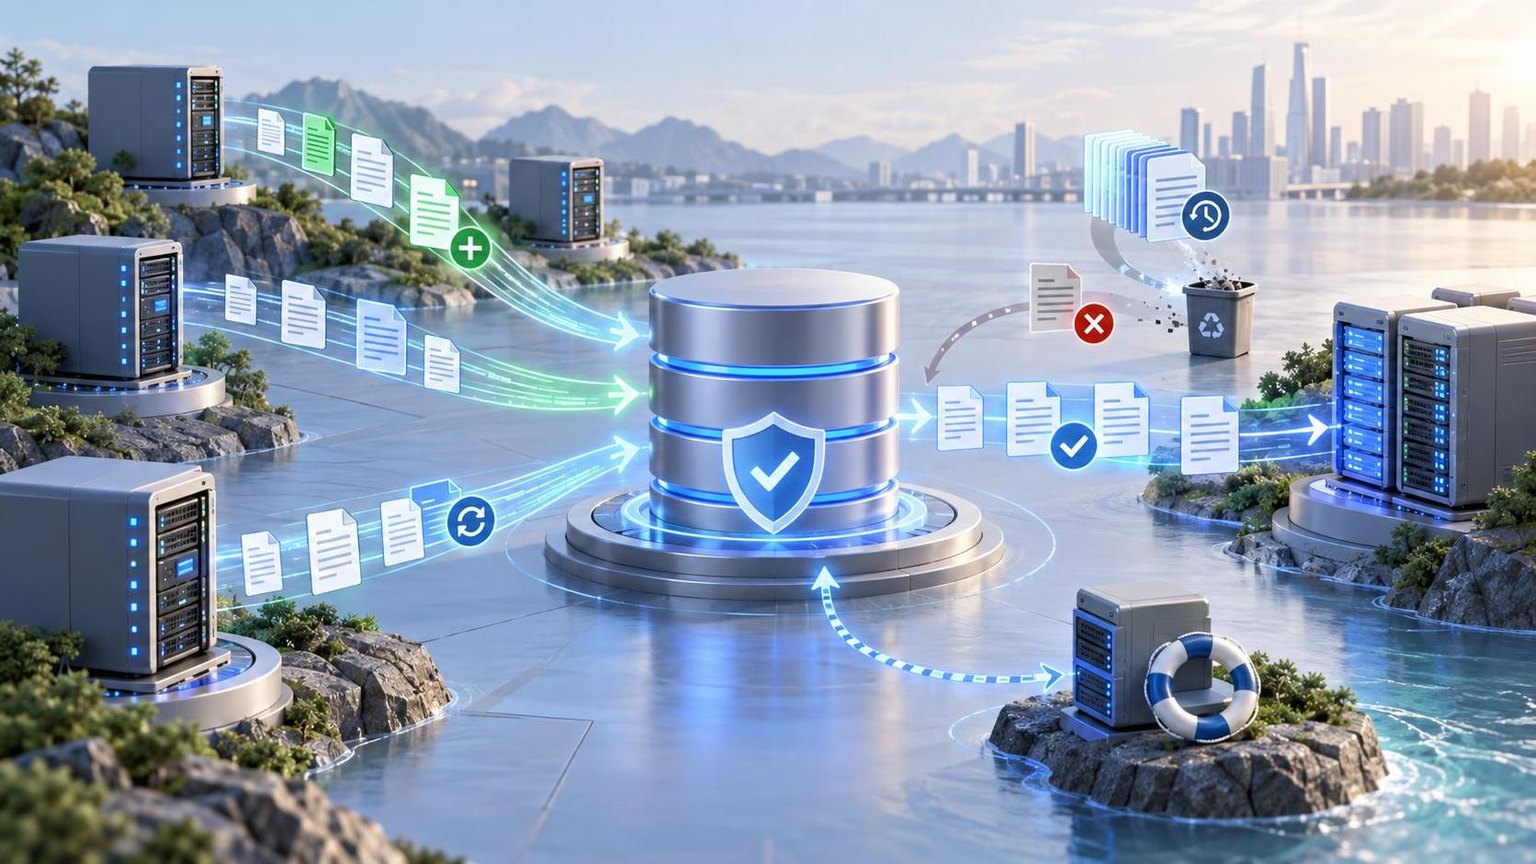
网页采集增量更新的直接方案
网页采集增量更新不是简单地只抓取最近一天发布的页面,而是判断数据相对于上一次成功同步是否发生变化。一个可落地的流程如下:
- 建立稳定的网页主键,识别同一个页面。
- 通过可靠的数据源或发现任务找出新增、修改和可能删除的页面。
- 使用更新时间、版本号、HTTP 缓存头或内容哈希确认页面是否变化。
- 将采集任务放入带幂等键的队列,避免重复调度。
- 使用数据库唯一约束和版本条件幂等写入。
- 在数据写入、校验和检查点保存成功后推进游标。
- 通过重试、死信队列、删除确认和周期性对账发现并修复异常。
关键原则是:游标提交必须晚于数据写入,数据写入必须能够安全重复执行,页面状态必须区分“未发现”“采集失败”“疑似删除”“确认删除”和“有效”。
一、先建立稳定的网页唯一标识
系统需要为每条网页记录建立稳定主键,通常优先使用规范化后的 URL。URL 规范化应统一协议、域名大小写、默认端口、路径末尾斜杠以及可忽略的跟踪参数,例如 utm_source、session_id 等。
如果网站提供明确的文章 ID、商品 ID 或 API 主键,应优先使用业务 ID,并将规范化 URL 作为辅助字段。不要直接使用页面标题作为唯一标识,因为标题可能修改、重复或包含不稳定格式。
建议保存以下字段:
- canonical_url:规范化后的地址。
- source_id:站点或数据源标识。
- content_id:稳定的业务主键。
- last_seen_at:最近一次被发现的时间。
- last_fetched_at:最近一次成功抓取的时间。
- status:有效、采集失败、疑似删除或已确认删除。
二、选择合适的变更检测策略
1. 使用更新时间或版本号
如果源站提供 API、RSS、站点地图或页面中的明确更新时间,应优先使用更新时间、版本号或递增 ID。这类字段判断成本低,适合新闻、商品、公告和内容管理系统。
但更新时间必须经过验证。部分网站会在页面模板变动时更新全站时间,或者修改内容却不更新时间,因此关键数据源仍应配合内容哈希校验。
2. 使用 ETag 和 Last-Modified
对支持 HTTP 缓存协商的网站,可以保存上一次响应中的 ETag 和 Last-Modified,下一次请求携带 If-None-Match 和 If-Modified-Since。服务器返回 304 时,系统即可确认响应内容未变化,不必重新下载和解析页面。
这种方式能减少传输和解析成本,但不能完全替代业务层校验,因为部分源站不会正确维护缓存头,或者 CDN 返回的缓存信息与实际内容不一致。
3. 使用内容哈希
当页面缺少可靠更新时间时,可对抽取后的业务内容生成哈希值,例如对标题、正文、价格、库存、作者和发布时间等字段进行规范化后计算 SHA-256。
哈希计算前应去除随机广告、访问时间、推荐列表、计数器和动态追踪参数,否则页面即使业务内容未变,哈希也会不断变化。可以同时保存:
- raw_hash:原始响应或主体的哈希,用于判断页面整体变化。
- content_hash:业务字段的哈希,用于判断是否需要更新业务记录。
- structure_hash:页面结构特征哈希,用于发现模板变化。
三、设计可靠的增量游标
增量游标记录系统已经处理到哪里。不同数据源应选择不同类型的游标:
- 递增 ID:适合提供单调递增主键的 API。
- 更新时间游标:适合按更新时间排序的内容接口。
- 分页令牌:适合返回 next_cursor 的接口。
- 站点地图版本或文件哈希:适合通过 sitemap 发现新增页面。
- 分区检查点:适合没有可靠排序字段的网页集合。
使用更新时间时,不要只查询“上次时间之后”的数据。更稳妥的做法是设置重叠窗口,例如每次从上次成功时间减去 5 至 30 分钟开始查询,再通过唯一键和内容版本去重。这样可以覆盖源站时间精度不足、事务延迟以及分页期间发生更新的情况。
游标更新应遵循以下顺序:
- 读取并锁定当前游标。
- 处理本批数据。
- 完成数据写入和一致性校验。
- 在事务或可恢复检查点中提交新游标。
如果先推进游标,再写入数据,任务中断后可能跳过尚未成功保存的页面。
四、通过幂等写入避免重复数据
幂等写入意味着同一条网页数据被处理一次或多次,最终结果相同。数据库层应为 source_id + content_id 或规范化 URL 建立唯一约束,并使用 UPSERT、MERGE 或带版本条件的更新语句。
更新时建议带上源版本或采集时间条件。例如,仅当新数据的 source_updated_at 不早于现有版本时才允许覆盖,避免延迟到达的旧任务覆盖较新的内容。
任务层还可以设置幂等键,例如“数据源 + 页面 ID + 源版本号”。任务入队时去重,写入时再次依赖数据库唯一约束兜底。队列去重不能代替数据库约束,因为消息可能重复投递,任务也可能超时重试。
五、处理删除、失效与历史版本
只发现新增和修改还不够,数据一致性还包括识别源站已经删除或下线的页面。常见策略有三种:
- 全量 ID 对账:周期性获取源站完整 ID 集合,与本地集合比对,适合有稳定列表接口的数据源。
- 站点地图对账:定期下载 sitemap,比较 URL 集合或 sitemap 文件版本。
- 连续未发现标记:页面在多个完整发现周期中都未出现,先标记为疑似删除,经过确认后再下线。
不要因为一次 404 就立即删除本地数据。404 可能由临时故障、访问限制或源站路由异常造成。可以根据连续失败次数、HTTP 状态码和重试结果进行判断,并保留 deleted_at、delete_reason 等审计字段。
如果业务需要追溯历史,应采用追加式版本表保存每次有效变更,主表只保存当前版本。这样既能支持当前查询,也能恢复误更新或分析历史状态。
六、保证任务失败后的数据一致性
分批处理与检查点
将采集范围划分为小批次,每批包含明确的开始位置、结束位置和任务 ID。单批成功后提交检查点,失败时从最近一个未完成批次重试,而不是重新处理整个数据源。
事务与状态机
可以为一条采集任务设置“待处理、抓取中、解析完成、写入成功、失败、确认删除”等状态。数据版本写入成功后,才将任务标记为完成。对于数据库内的主记录和版本记录,使用事务保证它们同时提交。
重试与死信队列
网络超时、429、5xx 等错误适合指数退避重试;解析错误、字段结构变化和权限错误应进入死信队列,等待人工或规则修复。重试必须有上限,避免单个异常页面长期占用采集资源。
并发控制
同一页面可能被多个发现任务同时加入队列。可以使用分布式锁、任务租约或数据库条件更新控制并发。锁应设置过期时间,并允许任务续租,避免进程崩溃后页面永久锁定。
七、不同网页场景下的实现方式
内容型网站
优先使用 RSS、站点地图、分类页和文章更新时间发现变化,再使用 ETag 或正文哈希确认变化。对历史文章可降低抓取频率,对近期文章设置更短的刷新周期。
电商与库存页面
价格、库存和促销信息变化频繁,应将商品基本信息与价格库存拆分为不同实体。商品详情不必每次完整重抓,但价格和库存可以采用更短的轮询周期,并保存有效时间和来源时间。
无更新时间的目录页面
可对列表页生成 URL 集合快照,通过集合差异发现新增和消失条目,再对候选详情页执行内容哈希检测。对于长期稳定页面,使用分层刷新策略,减少无变化页面的请求次数。
动态渲染页面
应优先寻找页面背后的 JSON 接口、GraphQL 请求或结构化数据。若必须使用浏览器渲染,应先用轻量 HTTP 请求做变更预判,再对疑似变化页面启动浏览器任务,以控制资源消耗。
八、监控与校验指标
增量系统需要同时监控采集效率和一致性。建议关注以下指标:
- 重复任务率和重复写入率。
- 新增、更新、删除页面数量。
- 内容哈希未变化但重复抓取的比例。
- 任务成功率、重试率和死信数量。
- 游标推进延迟与任务积压量。
- 源站页面数量与本地有效记录数量的差异。
- 不同采集时间之间的版本倒退次数。
- HTTP 429、403、404 和 5xx 的分布。
此外,应安排周期性抽样全量校验。增量机制即使长期运行正常,也可能因解析规则变化、游标异常或源站接口调整而漏采。全量校验可以作为增量系统的纠偏机制,而不是日常采集方式。
推荐的数据模型
一个实用的最小模型可以包含三类表:
- 页面主表:保存页面当前状态、规范化 URL、当前版本和最后成功时间。
- 页面版本表:保存内容哈希、源站更新时间、抓取时间和解析结果。
- 采集任务表:保存任务状态、重试次数、错误信息、幂等键和检查点。
这种拆分能够避免采集任务状态与业务数据相互覆盖,也便于审计、回滚和重新解析历史原始内容。
常见问题
网页采集增量更新如何避免重复抓取和重复写入?
使用稳定唯一键识别页面,在队列层设置幂等键,在数据库层设置唯一约束,并结合 ETag、Last-Modified 或内容哈希进行变更预判。重复任务即使执行,也应通过幂等写入保持最终结果一致。
增量更新是否等于只抓取最近一天的页面?
不是。时间窗口只是发现变化的一种方式,还需要配合重叠窗口、唯一键、版本校验、删除检测和周期性对账。
只有 URL 没有更新时间,如何判断页面是否变化?
可以使用 ETag、Last-Modified 或规范化业务内容哈希。哈希计算前应过滤广告、计数器和其他随机区域。
任务执行到一半失败,游标应该如何处理?
只提交已经完成数据写入和校验的批次游标。失败批次从检查点重试,并通过幂等写入避免重复记录。
源站短暂返回 404,是否应立即删除本地页面?
不建议立即删除。应结合重试结果、连续失败次数和完整列表对账,将页面先标记为疑似删除,确认后再下线。
如何防止旧数据覆盖新数据?
写入时比较源站版本号、更新时间或采集序列号,只允许较新版本覆盖当前记录,并记录版本冲突。
总结
网页采集系统应围绕稳定唯一标识、可靠变更检测、重叠增量游标、幂等写入、版本控制、删除检测和失败恢复设计更新机制。日常使用增量采集减少资源消耗,定期通过全量对账和抽样校验纠正漏采,才能同时避免重复抓取并保证数据与源站状态的一致性。