直接回答:网页采集中的字符编码乱码排查,应先保存服务器返回的原始字节,再按“HTTP 响应头、HTML charset、实际字节编码、程序解码方式、输出编码”这一顺序逐层核对。确认真实编码后只解码一次,程序内部统一使用 Unicode 字符串,并在写入 CSV、JSON 或数据库时显式指定编码。不要先用 errors="ignore" 掩盖错误,也不要在已经乱码的文本上反复执行 encode 和 decode。
定义:什么是网页采集中的字符编码乱码
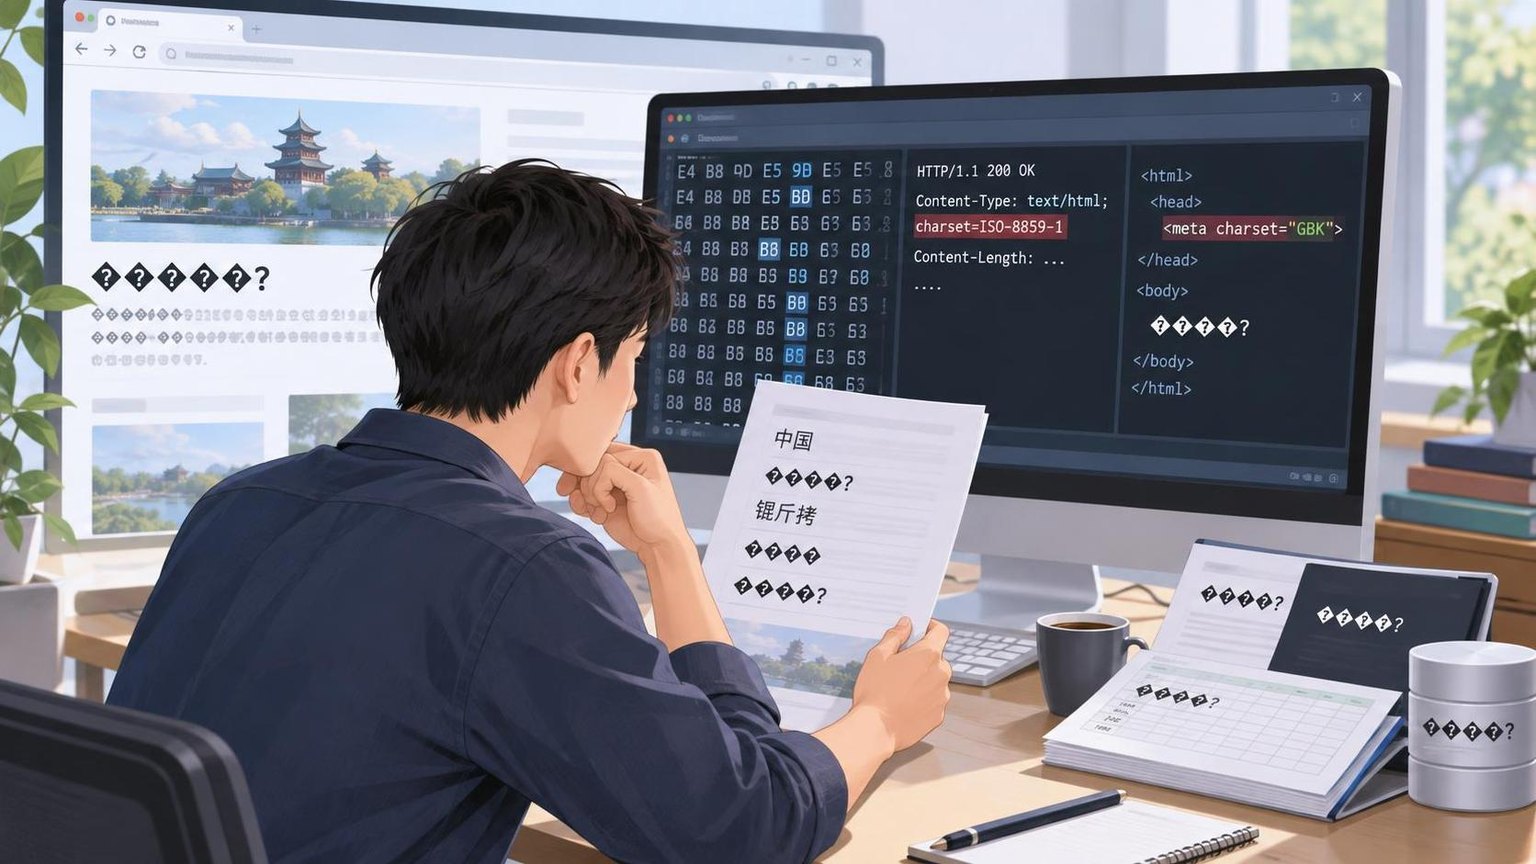
网页采集中的字符编码乱码,是指采集程序用错误的字符编码解释响应字节,或者在解析、传输、存储和展示过程中进行了错误转码,导致原文变成“锟斤拷”、黑色菱形问号、普通问号、异常符号或不可读文字。它本质上是字节与字符之间的转换规则不一致,并不等同于网页没有返回中文内容。
完整链路通常包括:服务器生成文本并编码为字节,HTTP 返回字节,采集程序将字节解码为 Unicode 文本,业务程序完成解析和清洗,最后再编码写入文件、接口或数据库。任一环节使用了错误编码,都可能产生乱码。
乱码现象与快速定位
| 现象 | 优先检查位置 | 常见含义 |
|---|---|---|
| 出现“锟斤拷”等文字 | 历史转码链路 | 文本可能已经被错误解码后再次编码 |
| 出现 � | 首次解码环节 | 解码器用替换字符代替了无效字节 |
| 出现大量普通问号 | 写库、导出或编码降级环节 | 目标编码无法表示原字符,信息可能已经丢失 |
| 浏览器正常,爬虫乱码 | 响应头、HTML 声明和采集库推断结果 | 浏览器与采集程序采用了不同编码 |
| 内存正常,CSV 打开乱码 | 文件编码、BOM 和打开软件 | 抓取可能正常,问题发生在输出或显示阶段 |
| 正文正常,接口字段乱码 | 接口响应和字段生成链路 | HTML 与接口可能由不同系统或编码配置生成 |
诊断顺序与证据优先级
网页编码排查应坚持“原始字节优先、声明交叉验证、逐层缩小范围”。推荐顺序如下:
- 记录 URL、请求参数、请求头、状态码、响应头和采集时间。
- 保存
response.content等原始字节,不要只保存已解码的文本。 - 读取 HTTP
Content-Type中的charset。 - 从 HTML 前部查找
meta charset或旧式http-equiv声明。 - 查看采集库推断的编码,但只把自动检测结果作为参考。
- 选择 UTF-8、GB18030 等候选编码,以严格模式解码并核对已知中文样本。
- 确认首次解码正确后,继续检查 JSON、CSV、消息队列和数据库写入环节。
证据发生冲突时,响应头和 HTML 声明都不能单独证明实际编码。最终应以原始字节能否严格解码、已知字段是否正确以及多个页面样本是否一致为判断依据。
高频问题一:HTTP 响应头编码错误或缺失
问题
服务器返回 Content-Type: text/html,但没有提供 charset;或者声明为 ISO-8859-1、UTF-8,实际内容却是 GBK 或 GB18030。采集库据此生成的文本出现中文乱码。
原因
不少 HTTP 客户端会优先参考响应头设置解码编码。服务器配置错误、反向代理改写响应头或历史页面编码不统一,都会使客户端选错编码。
解决
同时检查原始字节、响应头和页面声明。若确认响应头不可信,可在对应站点或页面类型的配置中显式指定真实编码:
import requests

response = requests.get(url, timeout=15)
response.raise_for_status()
raw = response.content

print(response.headers.get("Content-Type"))
print(response.encoding)

# 仅在样本验证确认后指定
text = raw.decode("gb18030", errors="strict")
不要因为一个页面使用 GB18030,就将所有目标站点全局设置为 GB18030。编码规则应至少按域名、路径、响应类型或业务模块维护。
高频问题二:HTML charset 与实际编码不一致
问题
页面声明 <meta charset="UTF-8">,但模板文件或后端输出实际采用 GBK;也可能响应头声明 UTF-8,而 HTML 中保留旧的 GB2312 声明。
原因
charset 只是声明,不会自动转换页面字节。模板迁移、文件保存编码变化、页面片段拼接或缓存未更新,都可能造成声明与内容不一致。
解决
检查以下两类声明,但不要将其作为唯一依据:
<meta charset="UTF-8">
<meta http-equiv="Content-Type" content="text/html; charset=gb2312">
提取标题、栏目名等已知中文样本,用候选编码严格解码后比较结果。若同类页面稳定使用同一实际编码,可建立站点级覆盖规则;若编码随路径或接口变化,应分别配置并保存异常样本用于回归测试。
高频问题三:采集程序选择了错误编码
问题
程序直接使用采集库的文本属性,得到乱码;修改 response.encoding 后结果又与自动检测不同。
原因
文本属性通常已经根据响应头或默认规则执行了解码,而自动编码检测只根据字节分布进行概率判断。短文本、混合语言页面和相近的中文编码都可能导致误判。
解决
诊断阶段优先操作原始字节,并分别记录服务端声明、库推断值和检测器结果。编码检测可以帮助生成候选项,但不能替代业务样本验证。确定真实编码后再解码:
raw = response.content
encoding = "utf-8"  # 由响应头、HTML 声明和样本共同确认
text = raw.decode(encoding, errors="strict")
若使用 Requests,也可在确认编码后设置 response.encoding,再读取 response.text;不要先读取错误文本,再试图从损坏结果猜测原始编码。
高频问题四:过早解码或重复转码
问题
采集库已经返回字符串,业务代码又调用 decode;或者文本经过抓取、清洗、队列和存储模块时,被多次 encode、decode,最终出现乱码或异常。
原因
模块之间没有明确区分 bytes 与 str,开发者又通过连续转换尝试“修复”乱码。错误文本一旦被替换成问号,后续转码通常无法恢复原字符。
解决
建立统一数据契约:网络边界接收 bytes,确定编码后只解码一次;解析、抽取和清洗阶段只传递 Unicode 字符串;发送网络请求或写文件时,再按目标协议编码。排查时可记录对象类型、文本表示和关键字符码点,定位第一次发生变化的位置。
不要把 text.encode("某编码").decode("另一编码") 当作通用修复公式。只有明确知道此前发生了哪一次可逆的错误解码,并且原始码点仍完整保留时,逆向转换才可能有效。
高频问题五:UTF-8、GBK 与 GB18030 混用
问题
首页正常,详情页乱码;普通汉字正常,生僻字、繁体字或特殊符号异常;同一域名下 HTML 页面和搜索接口使用不同编码。
原因
老旧网站可能由多套系统生成。GB2312、GBK 和 GB18030 的字符覆盖范围不同,其中 GB18030 范围更广,但不能因此认定所有中文旧页面都是 GB18030。
解决
按 URL 路径、Content-Type、页面模板或接口来源配置编码。测试样本应包含简体字、繁体字、生僻字、全角标点和特殊符号,避免仅凭常用汉字判断。对于标称 GBK 但包含扩展字符的页面,可将 GB18030 作为候选,并通过严格解码和业务字段验证。
高频问题六:部分字段或接口单独乱码
问题
HTML 正文正常,但标题、搜索词、URL 参数或 JSON 接口字段乱码;也可能静态内容正常,JavaScript 加载的数据异常。
原因
页面与接口可能使用不同服务。乱码还可能来自 URL 查询参数编码、表单提交编码、JSONP 包装、压缩解压顺序或后端数据库连接字符集,而非 HTML 本身。
解决
在浏览器开发者工具中找到真实接口,保存该接口的响应头和原始响应体,独立判断编码。查询参数应通过 URL 编码工具构造,不要手工拼接已编码字符串;压缩响应应先按 Content-Encoding 正确解压,再按字符编码解码。JSON 响应通常使用 UTF-8,但仍需检查服务端实际字节和 Content-Type。
高频问题七:JSON、CSV 或数据库写出后乱码
问题
采集结果在程序内显示正常,保存到 CSV 后用表格软件打开乱码;JSON 中文全部变成转义序列;数据库内容出现问号或插入失败。
原因
输出环节拥有独立的编码规则。CSV 打开软件可能依赖 BOM 判断编码;JSON 序列化设置影响可读形式;数据库还同时受客户端连接、库表字符集、字段类型和排序规则影响。
解决
面向常见桌面表格软件的 CSV,可显式使用 utf-8-sig,并使用 CSV 库处理逗号、引号和换行:
import csv

with open("result.csv", "w", encoding="utf-8-sig", newline="") as file:
    writer = csv.writer(file)
    writer.writerow(["标题", "内容"])
    writer.writerow([title, content])
JSON 文件通常使用 UTF-8;需要直接显示中文时,可设置 ensure_ascii=False。数据库应同时核对客户端连接编码、数据库字符集、表和字段定义。MySQL 等系统需要完整 Unicode 时,应采用支持相应字符范围的配置,例如 utf8mb4,并确认连接参数与表结构一致。
可执行的网页采集编码修复流程
第一步:固定问题样本
记录发生乱码的 URL、时间、请求参数和运行环境。选择包含中文标题、标点、生僻字或 emoji 的字段作为比对样本,避免页面更新后无法复现。
第二步:保存原始响应
保存原始字节、响应头和状态码。原始响应是网页采集中的字符编码乱码排查最重要的证据;只有错误文本而没有原始字节时,很多转换过程无法可靠还原。
第三步:收集编码线索
记录 HTTP charset、HTML meta 声明、采集库采用的编码和检测器给出的候选项。对 JavaScript 页面,还要单独检查实际数据接口。
第四步:严格测试候选编码
依次用合理候选编码执行 errors="strict" 解码。能成功解码不代表内容一定正确,还要检查已知字段、特殊字符和页面结构是否符合预期。
第五步:定位首次损坏位置
按原始响应、首次解码、解析结果、消息传输、文件或数据库、最终显示的顺序逐层比较。找到字符第一次发生变化的位置,修复该环节,而不是在链路末端补做未知转码。
第六步:统一内部处理
完成正确解码后,业务层统一使用 Unicode。网络发送、文件写出和数据库连接等边界必须显式声明编码,禁止业务模块任意重复转换。
第七步:增加回归测试
保留 UTF-8、GB18030、错误声明和多接口混用等典型样本。升级 HTTP 库、解析器或导出组件后,自动验证标题、正文和特殊字符是否与预期一致。
不同采集场景的处理建议
静态 HTML 页面
优先检查响应头和 HTML 前部的 charset,再用原始字节验证。历史模板较多时,应按页面类型配置编码规则。
JavaScript 动态页面
浏览器自动完成解码后,DOM 通常已经是 Unicode 字符串,不应再次 decode。若字段乱码,应检查数据接口、前端转换逻辑或导出环节。
JSON 接口
直接分析接口响应,不要只检查渲染后的页面。确认压缩是否正确解开、响应体是否真为 JSON,以及服务端实际使用的字符编码。
文件与压缩包
文件名编码、压缩包元数据编码和文件内容编码是三个独立问题。应分别验证解压后的文件名、原始内容字节以及读取文件时指定的 encoding。
常见问题
网页采集中的字符编码乱码应该先检查什么?
先保存并检查服务器返回的原始字节,再核对 HTTP Content-Type、HTML charset、采集库采用的编码和输出环节。不要从已经乱码的文本开始反复转码。
为什么浏览器打开正常,爬虫抓取却乱码?
浏览器通常会结合响应头、HTML 声明和内容特征进行容错判断,而爬虫库可能直接采用响应头或默认编码。应比较两者实际使用的编码,并基于原始字节修正采集配置。
网页声明 UTF-8,就一定要用 UTF-8 解码吗?
不一定。charset 只是声明,可能与实际字节不一致。需要结合响应头、原始响应和已知中文样本验证。
出现“锟斤拷”还能恢复原文吗?
保留原始响应时通常可以重新正确解码。如果错误转换仍可逆且未发生字符替换,也可能按明确链路还原;若字符已变成问号或字节已被丢弃,则无法可靠恢复。
编码检测库的结果可以直接采用吗?
不建议直接采用。检测结果是概率推断,应与 HTTP 响应头、HTML 声明和实际业务字段交叉验证。
使用 errors="ignore" 能解决乱码吗?
不能。ignore 会静默丢弃无法解码的字节。排查阶段应使用 strict,让错误在首次解码时暴露。
CSV 文件乱码但程序日志正常,问题在哪里?
问题通常发生在文件写出或打开阶段。应检查写入编码、BOM 和打开软件的编码识别方式,面向部分表格软件时可使用 utf-8-sig。
总结
网页采集中的字符编码乱码排查应从原始响应字节开始,依次验证 HTTP 响应头、HTML charset、实际编码、首次解码和最终输出。确认真实编码后只解码一次,程序内部统一使用 Unicode,并为 CSV、JSON、接口和数据库显式设置编码;发现乱码时应定位第一次损坏的位置,而不是在错误文本上反复转码。