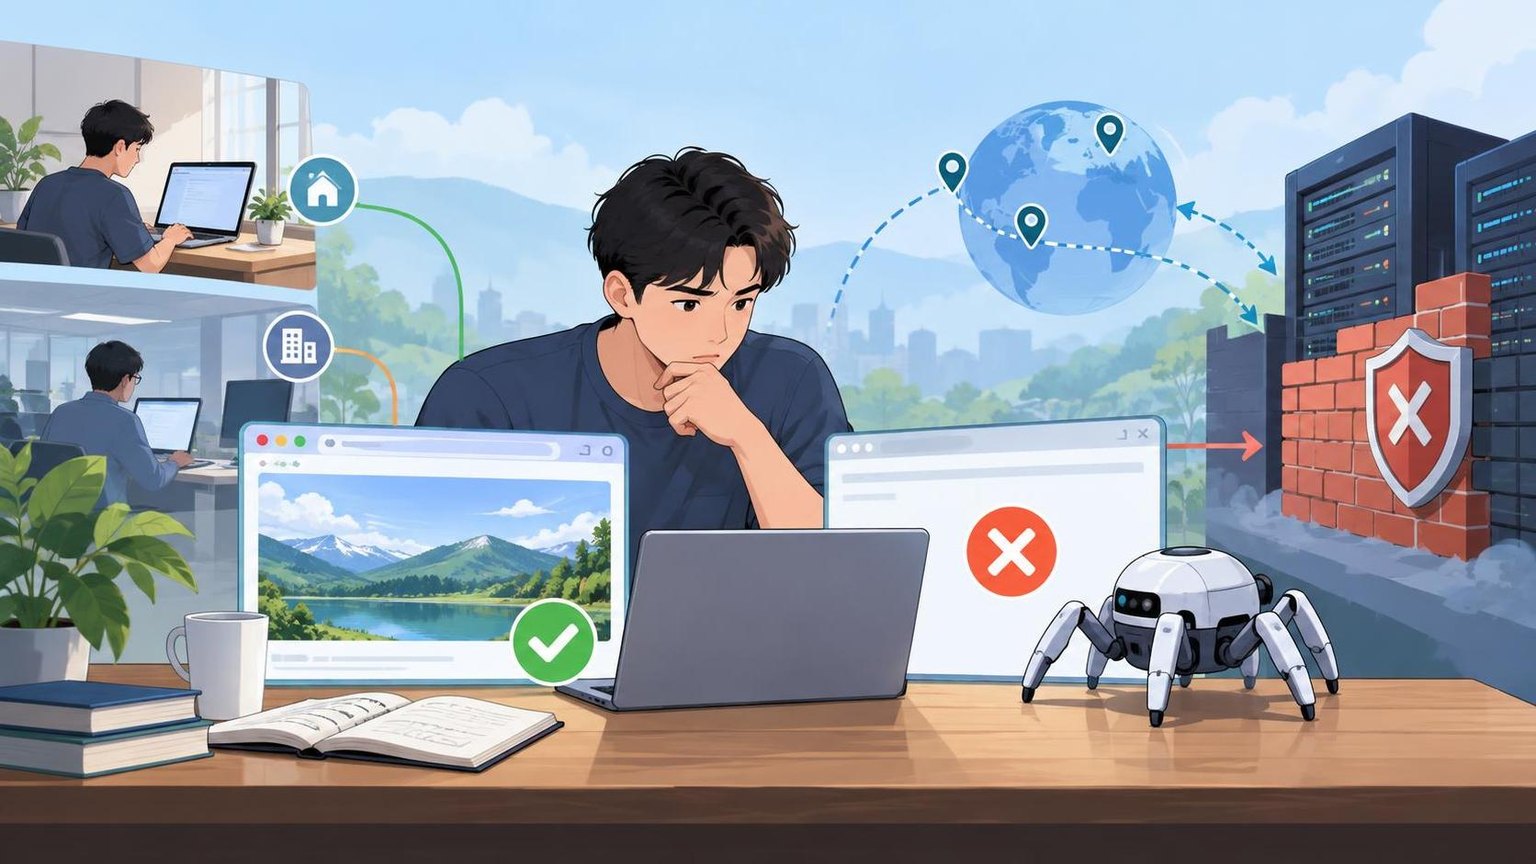
网页采集遇到 403 错误如何排查?先暂停批量请求,确认目标页面允许你访问和自动化采集;随后保存一次失败请求的 URL、时间、状态码、响应头和正文。再用单次、低频请求对比浏览器与程序的 URL、方法、认证状态和网络出口,并结合请求量变化及 WAF/CDN 日志定位拒绝来源。找到原因后,再分别修正请求配置、补齐合法权限、降低频率,或联系站点管理员;不要靠无限重试或轮换代理绕过限制。
403 是什么意思
HTTP 403 Forbidden 表示服务器理解请求,但拒绝提供资源。它不等同于 404(资源未找到),也不能仅凭状态码断定是程序错误。拒绝可能来自源站、认证网关、CDN、WAF 或网络代理。部分站点也会用 403 表示触发限流,而不是返回 429。
问题一:浏览器能打开,采集程序却返回 403
原因
程序请求的 URL、查询参数、HTTP 方法、重定向处理或必要请求头可能与成功请求不同;浏览器也可能带有程序缺少的有效登录态。
解决步骤
- 在获得访问授权的前提下,用开发者工具查看成功请求的 URL、方法、重定向链和认证要求。
- 与程序请求逐项对比,优先核对 URL、参数、方法及重定向后的目标地址,再检查 User-Agent、Accept 等实际需要的请求头。
- 如果资源需要登录,使用站点支持的认证方式,检查会话和令牌是否有效;不要复制他人的 Cookie,也不要硬编码一次性令牌。
- 每次只调整一个变量,用单次请求验证结果。若无痕浏览器也返回 403,继续排查权限或网络策略。
问题二:开始正常,连续采集后返回 403
原因
请求频率、并发数或重复访问可能触发站点限流或风控。即使响应是 403,也应结合请求时间线判断是否与流量上升有关。
解决步骤
- 按时间整理请求量、并发数、状态码和最近一次成功时间,确认错误出现的拐点。
- 暂停任务并降低请求频率、并发数;缓存已获取的内容,避免重复抓取。
- 仅在站点允许且确认属于临时失败时,设置有限次数的退避重试。持续返回 403 时停止自动重试,转为人工核查或申请正式接口。
问题三:公开页面可访问,特定资源返回 403
原因
个人中心、订单、后台、文件或接口可能要求登录、特定账号角色、订阅资格或有效令牌。已登录不代表拥有目标资源的访问权限。
解决步骤
- 确认资源是否公开,以及账号是否获准访问和采集该数据。
- 使用官方支持的 API Key、OAuth 或登录流程,检查 Cookie、Authorization、CSRF Token 等是否过期或与当前账号、域名不匹配。
- 核对账号角色、资源归属与地域限制。无权限时申请授权,不尝试绕过校验;凭据应安全存储,并在日志中脱敏。
问题四:本地正常,服务器或公司网络返回 403
原因
目标站点可能限制特定网络出口、数据中心 IP 或地区;企业代理也可能改写请求。仅凭不同环境下的结果,不能直接认定 IP 已被封禁。
解决步骤
- 在两个环境分别执行一次低频、已授权的相同请求,比较出口 IP、DNS 解析、响应头和错误页。
- 检查企业代理、出口防火墙及相关日志,确认请求是否被改写或拦截。
- 若确认业务出口被误拦截,向站点管理员提供时间和追踪 ID,申请固定 IP 允许规则或正式访问方式;不要持续轮换代理规避限制。
问题五:响应显示 WAF 或 CDN 拦截
原因
安全服务可能因请求路径、参数、速率、账号行为或 IP 信誉命中规则。错误页中的 Request ID、Ray ID 等信息有助于定位,但不能单独说明具体原因。
解决步骤
- 保存请求时间、路径、响应头、错误页和追踪 ID,避免在共享记录中暴露凭据。
- 站点所有者应查询源站及 WAF/CDN 安全事件,确认命中的规则和拦截动作;核实合法请求后,仅针对必要来源、路径和身份设置允许条件。
- 第三方采集方应将追踪信息、访问目的、频率和授权情况提交站点管理员,按对方提供的接口或访问方案调整。
问题六:目标路径受到站点采集规则限制
原因
robots.txt、服务条款、API 使用规则或数据许可可能限制自动化访问。robots.txt 通常不是 403 的直接生成原因,但它是判断采集范围时需要检查的规则之一。
解决步骤
- 查看目标域名的 robots.txt,并核对适用于采集程序的路径规则。
- 查阅服务条款、API 文档和数据许可要求,确认访问频率与用途是否被允许。
- 对不允许自动化采集的路径停止任务,联系站点申请授权或使用官方数据接口。
标准排查流程
- 确认权限:先核实页面、账号和自动化采集行为是否在授权范围内。
- 记录证据:保存 URL、方法、时间、状态码、响应头、错误页、追踪 ID 和请求量;对 Cookie、令牌等敏感信息脱敏。
- 最小化对比:对同一已授权资源分别进行浏览器和程序的单次请求,每次只改变一个变量。
- 定位拒绝层:结合响应内容及可访问的源站、认证网关、CDN/WAF 日志判断拦截位置。
- 验证修复:先单次测试,再在站点允许的范围内逐步恢复任务;持续监测 403、429 和响应时间。
常见误区
只修改 User-Agent:无法解决账号无权限、触发限流或安全规则拦截等问题。无限重试:可能加重风控,应先停止任务并查明原因。更换代理:不能替代访问授权,也不应被用来规避站点限制。
常见问题
浏览器能打开,程序返回 403,先检查什么?
先确认采集权限,再对比两者的 URL、请求方法、重定向和认证状态;随后检查必要请求头。浏览器可能依赖有效登录态,不应直接复制全部 Cookie 或动态令牌。
403 和 429 有什么区别?
403 表示访问被拒绝,429 表示请求过多。但有些站点会用 403 响应限流,因此应结合响应内容、请求频率和服务端日志判断。
降低频率后仍返回 403,怎么办?
检查账号权限、令牌有效期、网络出口和 WAF/CDN 拦截记录;若目标是第三方站点,携带请求时间和追踪 ID 联系管理员,不要持续重试。
可以通过更换代理解决 403 吗?
更换代理不能获得访问权限,也不应被用于规避限制。若已获授权且固定出口被误拦截,应与站点管理员核实并申请明确的访问方案。
robots.txt 禁止目标路径时还能采集吗?
应停止对该路径的自动化采集,并进一步核对服务条款与数据许可;需要数据时,通过站点提供的接口或授权渠道获取。
403 应自动重试多少次?
没有通用次数。对原因不明的 403,默认停止自动重试并记录证据;只有确认属于允许重试的临时故障时,才设置有限次数的退避重试。
站点所有者如何处理合法请求被误拦截?
使用请求时间、路径、客户端 IP 和追踪 ID 查询源站及 WAF/CDN 日志,确认命中规则后以最小范围调整允许条件,并验证认证和速率限制仍有效。
总结
网页采集遇到 403 错误如何排查:先确认授权并暂停批量请求,记录失败响应;再依次核对请求配置、登录权限、访问频率、网络出口及 WAF/CDN 规则。能确认的配置问题按原因修复;涉及站点访问限制时,停止采集并申请官方授权。