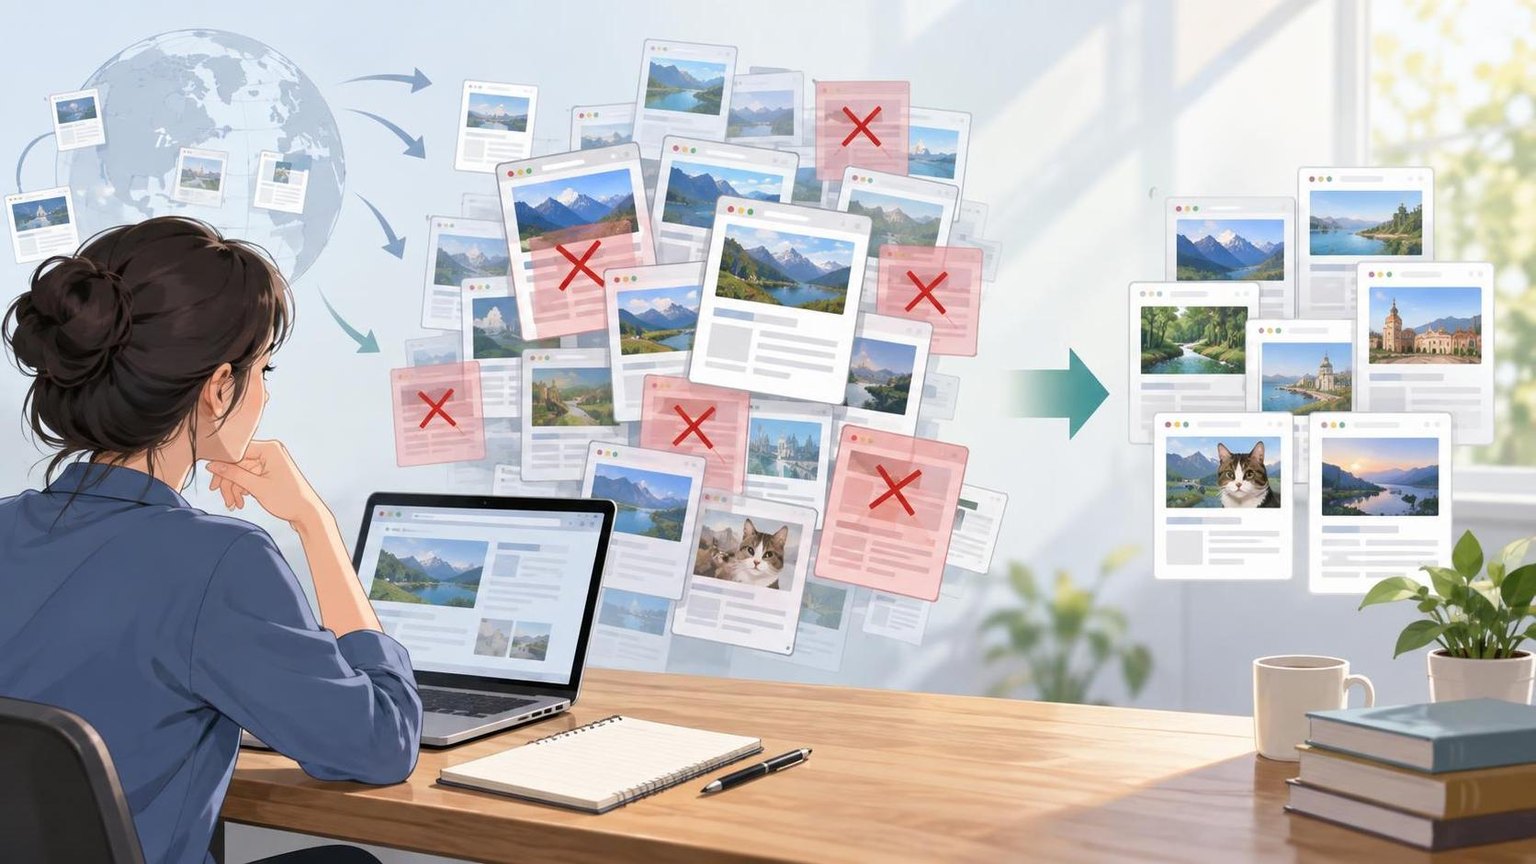
选择网页采集数据去重方法,先要确定“重复”指什么:同一个链接被反复抓取、不同链接指向同一条记录,还是正文内容相同或高度相似。通常,采集前用 URL 规范化减少重复请求,入库时用业务主键或内容哈希阻止重复记录;只有需要识别转载、轻微改写等近似内容时,再加入相似度算法。大规模任务可用布隆过滤器降低候选查询量,但不能仅凭它决定丢弃数据。
什么是网页采集数据去重?
网页采集数据去重,是在发现链接、抓取页面、解析记录和写入存储的不同阶段,识别并处理重复对象。选型前应区分两种目标:一是减少无效抓取,二是保证最终数据集符合业务定义的唯一性。页面 URL、文章、商品和商品价格快照可能分别需要不同的唯一规则。
常见去重方法对比
| 方法 | 判断依据 | 适用场景 | 主要局限 |
|---|---|---|---|
| URL 规范化 | 规范化后的链接 | 采集前过滤参数顺序、跟踪参数等造成的重复链接 | 不同 URL 仍可能是同一内容;规则过宽可能合并不同页面 |
| 业务主键与唯一约束 | 来源站点加商品 ID、文章 ID 等稳定标识 | 结构化数据入库、重复任务重试 | 依赖可靠标识;部分页面没有稳定 ID |
| 内容哈希 | 清洗后内容的哈希值 | 识别正文或字段完全相同的记录 | 空格、时间戳等变化若未清洗,会得到不同结果 |
| SimHash 或 MinHash | 文本特征的近似程度 | 文章转载、模板差异或小幅修改后的近似文本 | 需要设定阈值并处理候选检索;可能误合并相似但不同的内容 |
| 语义向量相似度 | 文本语义接近程度 | 表达不同但讨论同一主题的内容聚类 | 计算与存储成本较高;语义相近不等于同一条记录 |
| 布隆过滤器 | 标识是否可能已出现 | 大规模链接发现阶段的快速预筛 | 存在误判,不能单独充当最终去重依据 |
URL 规范化:优先解决重复抓取
可统一域名大小写、默认端口和明确无意义的跟踪参数,并按站点规则处理查询参数与末尾斜杠。不要直接删除所有参数:商品规格、分页或搜索条件可能由参数决定。规范化后的 URL 适合做抓取队列键,但不宜直接代表内容唯一性。
业务主键与内容哈希:优先保证入库唯一
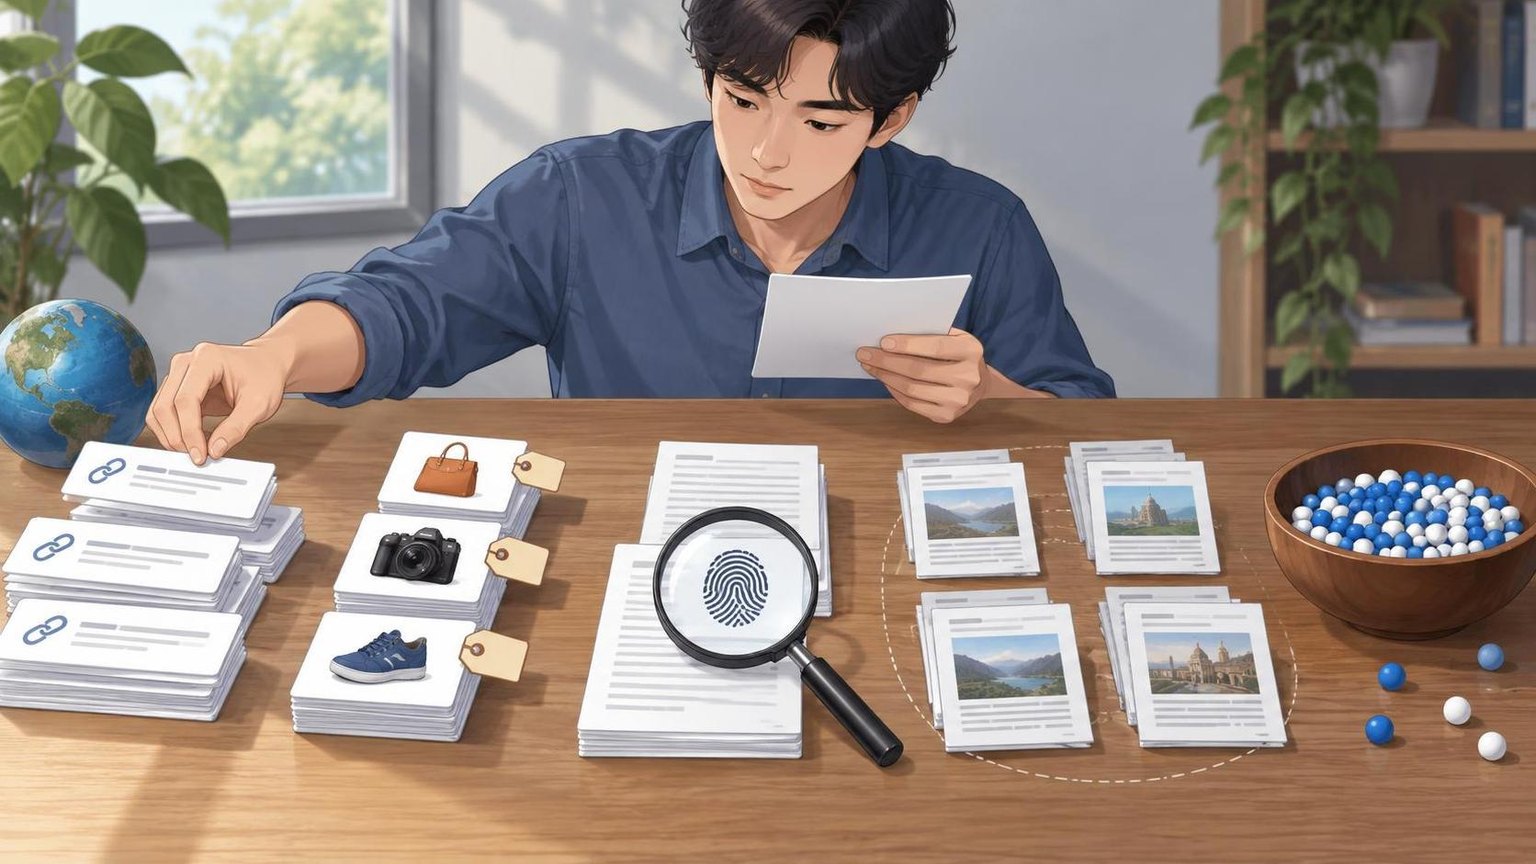
如果页面提供稳定 ID,通常以“来源站点+业务 ID”建立数据库唯一约束,并通过更新或幂等写入处理重试。没有稳定 ID 时,可对选定字段做清洗和序列化,再计算哈希。哈希字段应与业务目标一致:文章可使用标题与正文,商品记录可使用站点与商品标识;不要把每次变化的抓取时间混入用于判断记录身份的哈希。
近似匹配:只在需要识别相似内容时使用
SimHash、MinHash 更适合处理文本片段重合或小幅改写;语义向量适合找主题相近的候选,但不应直接把高相似度当成同一记录。实施时先按站点、栏目、时间或商品类别缩小候选范围,再设定阈值,并抽样检查误合并和漏检情况。
如何按场景选型?
- 小规模、结构化采集:先做 URL 规范化;有稳定业务 ID 时,以数据库唯一约束作为最终判定。实现简单,也便于处理任务重试。
- 多来源文章汇总:保留来源与原始 URL,用清洗后的正文哈希识别完全重复,再用近似算法标记疑似转载。是否合并应取决于来源归属和展示需求。
- 大规模链接发现:用布隆过滤器预筛候选,再用持久化键或数据库确认;规划过滤器容量,并考虑长期运行时的重建或分期策略。
- 商品价格等增量数据:用商品 ID 识别同一商品,用抓取时间或版本保存价格变化。不要因为商品重复出现就删除新的价格快照。
落地时建议先定义唯一对象和需要保留的变化,再确定去重键、清洗规则与冲突处理方式。将原始 URL、规范化 URL、业务键及去重判定结果分别记录,便于排查误判和调整规则。
常见问题
网页采集只用 URL 去重够吗?
通常不够。URL 去重主要减少重复抓取;不同链接下的相同记录仍需业务主键、内容哈希或其他规则识别。
内容哈希和 SimHash 应该选哪个?
完全一致的内容用清洗后的内容哈希;存在轻微改写或局部差异时,用 SimHash 等近似方法。
布隆过滤器能直接删除重复数据吗?
不建议。布隆过滤器可能把新标识误判为已出现,严格去重应再由持久化键或数据库确认。
总结
先定义唯一对象与需要保留的变化,再组合方法:URL 规范化减少重复抓取,业务主键或内容哈希保证精确入库,近似算法处理相似内容,布隆过滤器用于大规模预筛。