GraphQL 接口数据采集的核心,是按照目标接口的 Schema 组织 query、variables 和 operationName,通过分页与增量策略持续获取所需字段,再完成校验、去重、存储和监控。它适合字段关系复杂、前端按需取数、同一端点承载多种业务查询的系统,但生产落地不能只复现一次请求,还要处理鉴权、游标、限流、Schema 变化、局部错误和数据合规。
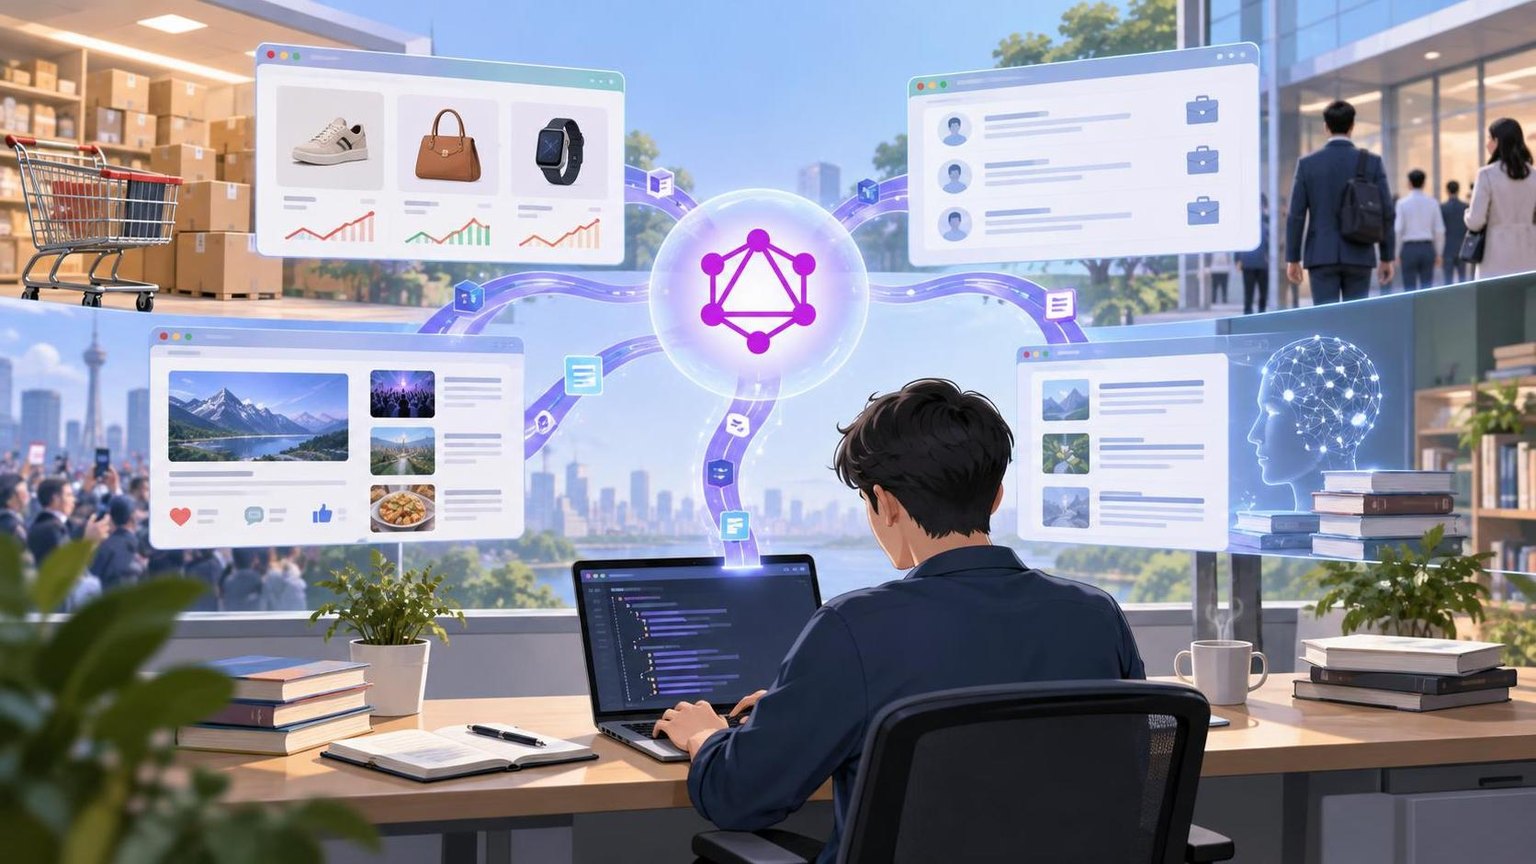
GraphQL 接口数据采集是什么
GraphQL 是一种 API 查询语言和运行时。与常见 REST 接口使用多个 URL 表示不同资源不同,GraphQL 通常通过一个端点接收查询,由客户端明确声明需要的字段和关联对象。
一次典型请求由三部分组成:
- query:描述查询名称、参数以及需要返回的字段。
- variables:传入关键词、分类、时间范围、分页游标等动态参数。
- operationName:当请求中包含多个操作时,指定本次执行的操作。
响应一般包含 data 和 errors。需要特别注意的是,HTTP 状态码为 200 并不代表业务完全成功:GraphQL 允许部分字段返回数据,同时在 errors 中报告另一些字段失败。因此,采集程序必须同时检查这两个节点。
场景一:电商商品与价格监测如何落地
先从前端业务动作定位查询
商品列表、搜索筛选、详情页、库存状态和评价摘要可能都通过同一个 GraphQL 端点返回。实施时可在获得授权的测试环境或公开访问范围内,通过浏览器开发者工具观察列表翻页、切换类目和打开详情时产生的请求,识别查询文档、变量及必要请求头。
使用游标分页稳定遍历商品
电商 GraphQL 常采用 Relay 风格分页,返回 edges、node 和 pageInfo。程序读取 endCursor,并在 hasNextPage 为 true 时继续请求。游标应被视为不透明字符串,不应尝试从中推导页码。
query Products($first: Int!, $after: String, $category: ID) {
  products(first: $first, after: $after, category: $category) {
    edges {
      node { id name price currency updatedAt }
    }
    pageInfo { hasNextPage endCursor }
  }
}
价格变化应采用快照与事件并存
只覆盖商品当前价格会丢失历史变化。常见做法是维护商品主表,同时将每次观测到的价格、库存、采集时间写入快照表。当价格或库存变化时,再生成变更事件,供告警、趋势分析和促销识别使用。
场景二:招聘、内容与舆情数据如何聚合
招聘数据关注实体关系与更新状态
招聘业务通常涉及职位、公司、地点、技能和发布时间等关联字段。GraphQL 可以一次查询这些关系,但查询层级过深会提高服务端计算成本,也更容易触发复杂度限制。生产任务应拆分为列表发现和详情补全两类查询,并以职位 ID、规范化 URL 或业务唯一键去重。
内容与舆情采集重视增量时间窗
资讯、帖子或评论接口可能支持 createdAt、updatedAt 或排序游标。增量任务不要简单以上次结束时间作为下次起点,建议设置一定的重叠窗口,再依靠主键和更新时间去重,以吸收延迟入库、内容修改及排序波动。
删除和下架也属于业务数据
如果记录在连续多次任务中消失,不能立即认定其已删除,也可能是查询条件变化、临时权限问题或接口异常。可以先标记为待确认状态,经过复核任务后再更新为删除、下架或不可见。
场景三:AI 训练与 RAG 数据建设如何落地
采集层保存原始证据
用于训练、评估或 RAG 的数据不仅要保存正文,还应保留来源标识、采集时间、内容更新时间、语言、内容类型和原始响应摘要。原始层与清洗层分开,可以在解析规则变化后重新处理,而不必重新请求来源接口。
字段选择围绕下游任务设计
GraphQL 支持按需选字段,但“字段越少越好”并不是完整标准。用于检索的数据通常还需要标题、正文、栏目、发布时间和稳定 ID;用于多模态任务时,还可能需要媒体地址、字幕、描述和授权状态。字段集合应由训练、检索、评估和审计需求共同决定。
建立数据血缘和质量指标
建议记录任务批次、查询版本、解析版本和来源更新时间,并持续统计空值率、重复率、解析失败率、字段分布及更新时间延迟。这样才能判断数据变化来自真实业务,还是接口或采集逻辑发生了改变。
GraphQL 数据采集的工程实现
第一步:确认端点、权限与查询结构
优先使用正式文档、授权凭证和服务方提供的测试工具。若接口开放 introspection,可查询类型、字段和参数定义;很多生产接口会关闭该能力,此时应依据已授权客户端请求、接口文档或内部 Schema 文件构造查询。关闭 introspection 不等于可以绕过访问限制。
第二步:封装请求与错误判断
import requests

def fetch_page(endpoint, query, variables, headers, timeout=30):
    payload = {
        'query': query,
        'variables': variables,
        'operationName': 'Products'
    }
    response = requests.post(
        endpoint,
        json=payload,
        headers=headers,
        timeout=timeout
    )
    response.raise_for_status()
    result = response.json()

    if result.get('errors'):
        raise RuntimeError(result['errors'])
    if 'data' not in result:
        raise RuntimeError('GraphQL response has no data field')
    return result['data']
实际生产代码还应区分可重试错误和永久错误。例如网络超时、服务端临时错误和限流可以退避重试;字段不存在、变量类型错误和权限不足通常需要修正查询或凭证,盲目重试没有意义。
第三步:实现分页、检查点与幂等写入
每成功处理一页后保存游标、任务批次和统计值。任务中断后从最近检查点恢复。写入端以稳定业务 ID 建立唯一约束,并结合 updatedAt 执行幂等更新,避免重试产生重复记录。
第四步:控制并发和查询成本
GraphQL 的单次请求可能触发多个解析器。高并发、深层嵌套、大分页和大量别名查询会放大服务端负载。应根据响应延迟、错误率和限流头动态调整并发,限制查询深度与每页数量,并为不同任务设置独立队列。
第五步:监控 Schema 与数据漂移
除了监控 HTTP 成功率,还要监控 GraphQL 错误码、关键字段缺失率、单页记录数、游标重复、字段类型和枚举值变化。查询文档最好纳入版本控制,并使用固定样本执行契约测试。
生产环境中有哪些常见坑
把 HTTP 200 当作完全成功
GraphQL 的局部错误可能与有效数据同时出现。若程序只检查状态码,可能把字段缺失的数据写入生产库。应读取 errors.path、错误扩展码及关键字段完整性,再决定整页重试、局部降级还是隔离处理。
误把 Base64 游标当作稳定页码
游标可能包含内部排序状态,也可能在数据更新后失效。不要修改、递增或长期复用游标;对于长周期任务,应同时保存业务主键和时间水位,准备在游标失效后回退到时间窗方案。
忽略 persisted query
部分接口不直接发送完整查询,而是发送查询哈希或扩展字段。这类持久化查询依赖服务端预先登记的映射。采集端不能假设只复制哈希就能长期使用,应确认正式调用方式、查询版本和授权范围。
一次查询嵌套过深
看似减少了请求次数,却可能触发复杂度限制、超时或大响应。更稳定的方式通常是先获取核心实体列表,再按 ID 分批补全关联数据,同时控制批量大小。
重试造成重复写入和请求风暴
没有幂等键的自动重试会产生重复记录;多个工作节点同步重试还会进一步加重限流。建议采用指数退避、随机抖动、最大重试次数和死信队列,并在数据库层设置唯一约束。
只关注技术可达性,忽略合规边界
实施前应确认数据是否公开、是否包含个人信息、接口条款是否允许自动访问,以及数据保存和使用目的是否符合适用规则。不得绕过身份验证、验证码、访问控制或其他技术保护措施。对个人信息和敏感字段应执行最小化采集、权限隔离、脱敏及保留期限控制。
选型建议:什么时候自建,什么时候采用服务化能力
接口数量少、Schema 稳定、团队具备 API 工程能力时,自建任务便于精细控制查询和存储。若业务同时涉及网页、搜索引擎、视频平台及多地区公开数据,工程重点会扩展到网络调度、失败重试、数据交付和持续维护。此类情况下,可评估 Dataify 提供的网页采集、SERP、视频数据、通用采集 API、网络服务以及标准或定制数据集能力,并将其覆盖范围、交付字段、更新频率、合规要求和总成本与自建方案统一比较。
选型时不应只比较单次请求价格,还要估算有效记录成本,包括成功率、重复率、开发维护、存储、质量检查和异常补采。对于关键数据源,建议先用代表性样本验证字段完整度、时效性和长期稳定性。
落地案例:多来源商品情报管道
某电商分析团队需要整合 GraphQL 商品接口、搜索结果和公开网页信息。工程上可将任务拆为四层:发现层获取商品 ID 与链接,详情层补全价格和库存,标准化层统一币种与类目,分析层生成价格变化和缺货信号。GraphQL 任务按游标增量运行,网页与搜索数据则通过独立队列处理,最终以统一商品键合并。
当团队不希望分别维护搜索、网页和跨地区网络链路时,可把相关公开数据获取环节接入 Dataify 的采集 API 或网络服务;内部系统继续负责商品匹配、规则判断、指标计算和权限治理。这样能明确外部数据交付与内部业务逻辑之间的责任边界。
常见问题
GraphQL 接口数据采集与 REST API 采集最大的区别是什么?
GraphQL 通常使用统一端点,由客户端声明需要的字段和关联关系;REST 则常通过多个资源 URL 返回预定义结构。GraphQL 采集更依赖查询文档、变量、Schema 和复杂度控制。
GraphQL 返回 HTTP 200,为什么仍然没有完整数据?
GraphQL 支持部分成功。某些字段解析失败时,响应仍可能返回 200,并同时包含 data 和 errors。采集程序需要检查 errors、错误路径以及关键字段完整性。
GraphQL 游标分页中断后可以直接续采吗?
通常可以,但游标可能因数据变化或服务端策略而失效。除保存 endCursor 外,还应保存业务主键、时间水位和任务批次,并准备时间窗回退与去重机制。
生产环境是否应该开启 GraphQL introspection?
这取决于接口治理策略。内部开发环境可以利用 introspection 提升调试效率,生产环境则常根据安全要求关闭或限制访问。采集方应优先依赖正式文档、授权 Schema 或稳定的查询契约。
怎样降低 GraphQL 采集对服务端的压力?
减少不必要字段和嵌套层级,控制分页大小与并发数,按错误率和延迟动态限速,并使用指数退避处理临时失败。不要通过大量别名把过多查询强行塞入一次请求。
采集公开 GraphQL 接口是否一定合规?
不一定。公开可访问不等于可以不受限制地采集和使用。仍需核对接口条款、数据权利、个人信息处理规则和使用目的,并避免绕过认证、验证码或访问控制。
总结
GraphQL 数据采集应围绕业务实体设计查询,以游标或时间水位实现增量获取,并通过幂等写入、错误分类、限流退避、Schema 监控和质量指标保证长期运行。落地前还需确认授权、个人信息处理和数据用途边界。