直接结论:图像数据集类别不平衡如何处理,取决于问题究竟来自少数类信息不足、训练曝光率不足,还是部署阈值不合适。少数类样本太少、标注质量差或场景覆盖不足时,应优先清洗并补充真实数据;少数类已有一定多样性但训练中出现得太少时,可比较过采样、均衡批次采样和针对性数据增强;各类样本都较充足但模型偏向多数类时,可比较类别加权损失与 Focal Loss;模型已经具备区分能力、只是漏检和误报成本不匹配时,应在验证集上调整预测阈值。所有方案都要在保留真实类别分布、无数据泄漏的独立测试集上确认,不能只看总体准确率。
图像数据集类别不平衡的定义与影响
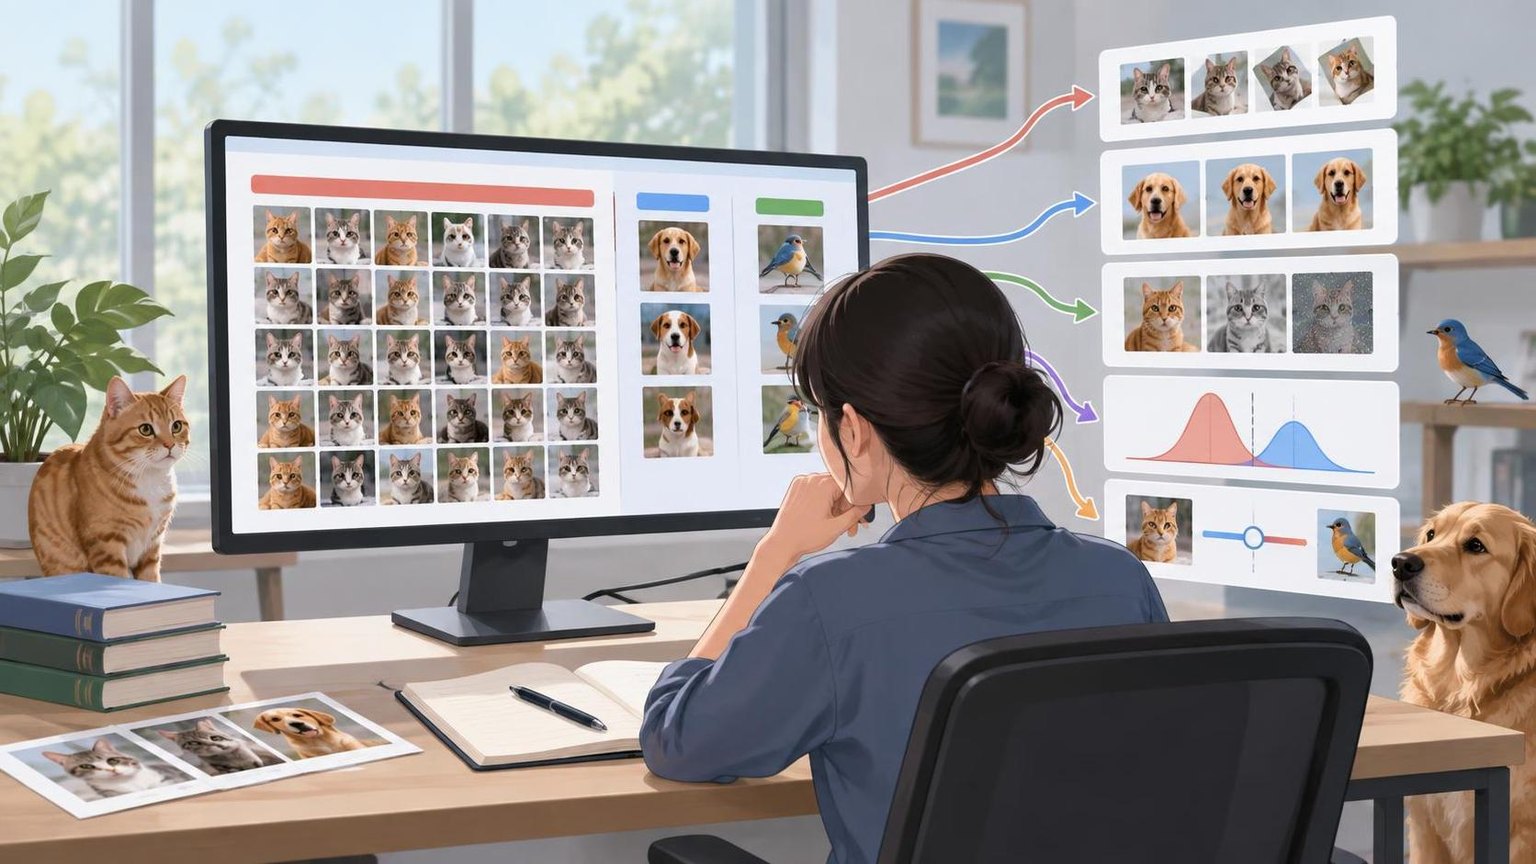
图像数据集类别不平衡,是指不同类别在数据集中的样本数量存在明显差异,导致多数类和少数类对模型训练的影响不对等。例如,在工业缺陷检测中,正常图像可能远多于缺陷图像;在医疗筛查中,阴性样本通常多于阳性样本。此时,模型即使大部分时间都预测为多数类,也可能取得较高的总体准确率,但少数类召回率很低,造成严重漏检。
需要区分两种情况:训练集类别不平衡指用于学习的数据比例失衡,主要影响模型参数学习;真实场景发生率低指线上业务本身就是少数类更少,主要影响预测结果的先验分布、阈值和指标解读。训练时可以适度调整类别比例,但验证集和测试集通常应保留接近真实业务的分布,不能把所有集合都强行改成均衡比例。
处理方案对比:成本、收益与适用场景
| 方案 | 适用场景 | 主要优势 | 主要限制 | 选型提示 |
|---|---|---|---|---|
| 补充与清洗少数类数据 | 少数类样本极少、标注噪声高,或拍摄条件覆盖不足 | 增加真实信息并改善数据质量,长期收益通常最高 | 采集和标注成本较高;新增数据仍需覆盖真实变化 | 当少数类只有几十张或场景差异很大时优先考虑 |
| 随机过采样、均衡批次采样 | 少数类已经有一定多样性,但训练曝光率明显不足 | 实现简单,不改变图像内容,容易接入现有训练流程 | 重复看到相同图像可能过拟合;训练比例会偏离真实分布 | 先比较不同采样比例,不必默认采样到 1:1 |
| 多数类欠采样 | 多数类规模很大且存在较多冗余,训练预算有限 | 减少训练成本,降低多数类对批次和梯度的主导 | 可能丢失少见但重要的多数类场景 | 先去重并保留难例、边界样本和不同子场景 |
| 针对性数据增强 | 少数类标注可靠,且旋转、裁剪、翻转或颜色变化符合业务规则 | 增加训练样本的视觉变化,缓解有限样本问题 | 不合理变换可能改变标签;增强无法完全替代真实数据 | 增强规则必须遵循目标方向、位置和纹理等标签语义 |
| 类别加权损失 | 各类都有足够样本,主要问题是少数类错误代价没有被充分体现 | 不复制样本,便于与现有训练流程结合 | 权重过大可能导致误报增加、概率校准变差或训练不稳定 | 从温和权重开始,并在验证集上观察精确率和召回率变化 |
| Focal Loss | 大量易分类样本主导损失,少数类或困难样本学习不足 | 降低易分类样本的损失影响,集中学习困难样本 | 需要调节聚焦参数;错标样本也可能被当作困难样本而放大 | 适合困难样本明显、易分类样本占比很高的任务,不是所有不平衡问题的默认答案 |
| 预测阈值调整 | 模型已经具有一定区分能力,但默认阈值不符合漏检和误报成本 | 无需重新训练,可直接调整精确率与召回率的取舍 | 不能弥补模型未学会的类别特征;阈值必须用验证集确定 | 适合部署阶段配合业务成本进行决策优化 |
按数据条件和业务目标选型
少数类只有几十张,且场景差异大
优先检查错标、重复图和数据泄漏,再补充不同设备、光照、背景、目标形态及拍摄角度下的真实样本。可以使用符合标签语义的增强辅助训练,但单纯重复采样只会增加相同图像的出现次数,无法创造缺失的视觉信息。此时,类别加权或 Focal Loss 不能替代数据覆盖建设。
少数类样本不少,只是类别比例悬殊
先建立原始训练基线,再分别测试均衡采样和类别加权损失。两者都可能提高少数类召回率,也可能增加多数类误报。不要一开始同时叠加高倍率过采样、大类别权重和强增强,否则难以判断收益来源,也更难定位性能下降原因。
多数类规模很大,训练预算有限
可以对多数类进行适度欠采样,但必须保留不同子场景、边界样本和高价值难例。若多数类中存在大量重复图像,应先去重再采样。欠采样只作用于训练集,验证集和测试集不应为了平衡而随意删除样本。
漏检比误报更昂贵
应以少数类召回率或漏检率作为核心约束,同时比较加权损失、采样策略和预测阈值,并报告误报数量及其处置成本。医疗筛查、工业缺陷和安全告警等场景,不应只追求某一个最高分数,而应根据实际业务成本确定可接受的精确率、召回率和阈值组合。
实施与评估的关键步骤
- 先划分数据,再处理训练数据。按患者、产品、设备或其他业务实体划分训练集、验证集和测试集。同一患者、同一产品或连续拍摄序列的相近图像应避免跨集合出现,以防数据泄漏。过采样、欠采样和数据增强只作用于训练集。
- 建立原始分布基线。固定数据划分和主要训练设置,记录各类样本数、混淆矩阵、少数类精确率、召回率、F1 值以及训练时间。
- 一次比较一个主要变量。先单独测试采样、增强、类别加权或 Focal Loss,再评估有明确依据的组合。同步记录误报、漏报、显存、训练时长和推理成本。
- 使用适合不平衡任务的指标。重点查看少数类召回率、精确率、F1、PR 曲线及其曲线下面积,并结合每类指标和混淆矩阵分析。极端不平衡时,总体准确率和单一 ROC-AUC 可能掩盖少数类表现。
- 用验证集确定阈值,用测试集做最终确认。测试集应尽量贴近真实类别比例,并且只在方案和阈值确定后使用。上线后持续监测类别分布、误报、漏报及数据分布变化。
常见问题
图像数据集类别不平衡如何处理?
先判断问题来源:少数类信息不足时补充和清洗真实数据;训练曝光不足时使用过采样、均衡采样或针对性增强;模型偏向多数类时比较类别加权损失和 Focal Loss;部署成本不匹配时在验证集上调整阈值。最终应在保留真实分布的独立测试集上确认。
过采样和类别加权能一起用吗?
可以,但应先分别验证效果。叠加后少数类影响可能过大,导致多数类误报增加或训练不稳定。
少数类是否一定要采样到 1:1?
不一定。训练比例应根据独立验证集上的少数类召回率、精确率、误报量及业务成本选择。
准确率很高,为什么还需要处理类别不平衡?
总体准确率可能被多数类主导。应检查少数类召回率、精确率、F1、PR 曲线和混淆矩阵。
合成图像能替代真实少数类图像吗?
一般只能作为补充。需检查合成图像的标签、伪影和场景覆盖,并在真实独立测试集上确认效果。
总结
图像类别不平衡的处理应先区分数据覆盖、训练曝光和决策阈值问题:覆盖不足优先补充真实数据;样本已有多样性可比较采样和增强;模型偏向多数类可比较类别加权损失与 Focal Loss;部署阶段再依据漏检和误报成本调整阈值。所有方案都应在无数据泄漏、贴近真实分布的独立测试集上评估。