Cohen's Kappa 可以通过比较两名标注员的实际一致率与随机情况下的期望一致率,判断分类标注的一致性是否超出偶然水平;实操时应同时检查混淆矩阵、类别分布、样本量和置信区间,不能只看一个 Kappa 数值。
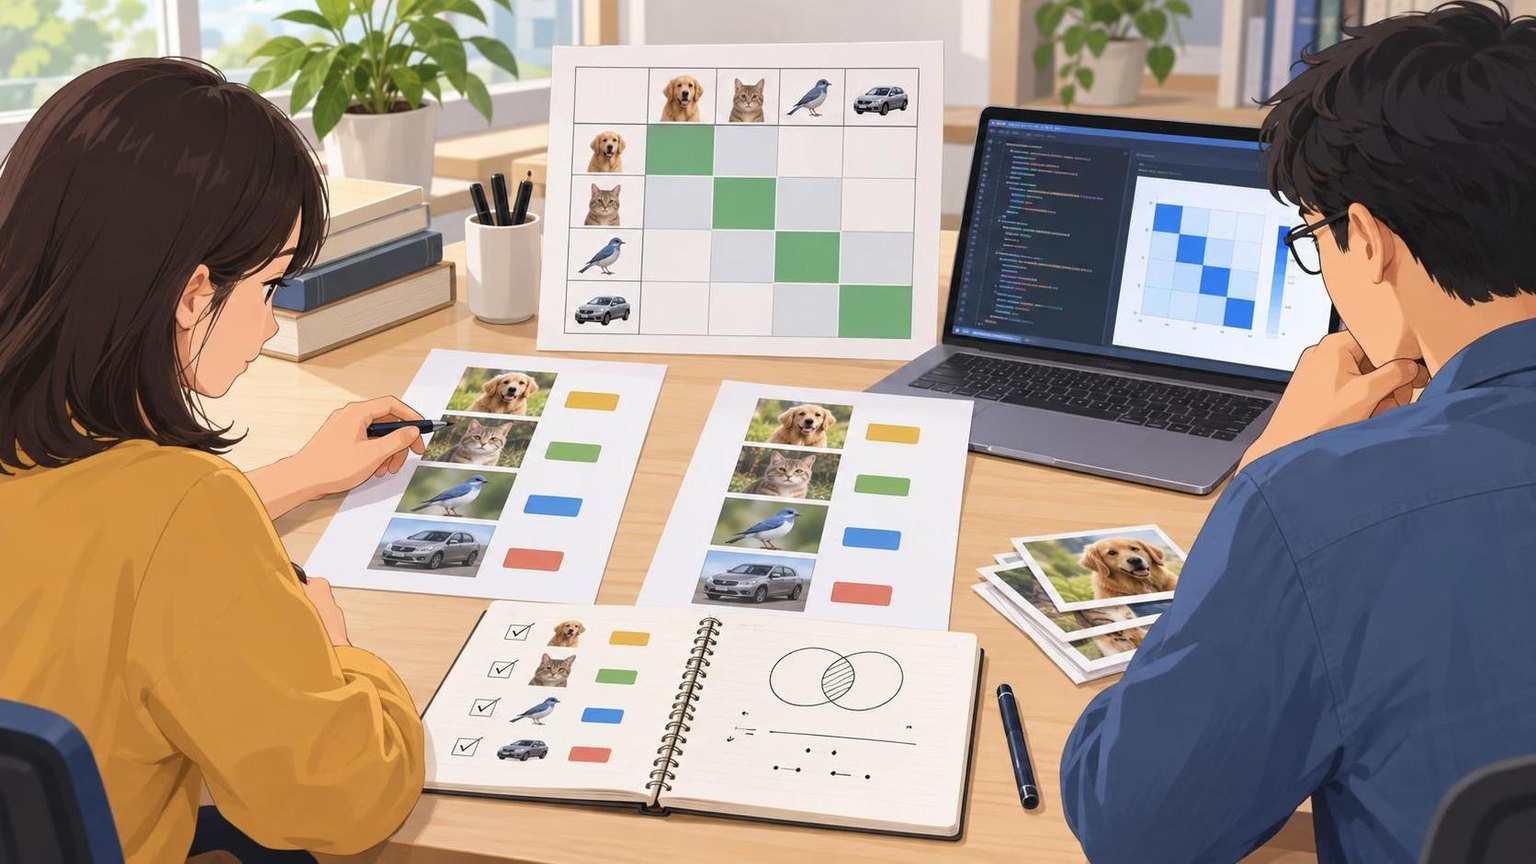
Cohen's Kappa 是什么
Cohen's Kappa,通常记为 κ,适用于两名标注员对同一批样本进行分类标注的场景。它修正了简单一致率可能由随机选择造成的高估问题。
计算公式为:
κ = (Po - Pe) / (1 - Pe)
- Po:两名标注员的实际一致率。
- Pe:根据双方各类别标注比例计算出的随机期望一致率。
- κ = 1:完全一致。
- κ = 0:一致程度与随机选择相当。
- κ < 0:一致程度低于随机预期,通常意味着标注规则、数据映射或标注流程存在问题。
适用范围
标准 Cohen's Kappa 适合两名标注员、同一批样本以及互斥的名义分类标签,例如正面、负面、中性,或者通过、不通过。若标签具有明确顺序,例如低风险、中风险、高风险,可使用加权 Kappa。若标注员超过两名,可考虑 Fleiss' Kappa;存在缺失值、不同标注员组合或复杂标签类型时,可考虑 Krippendorff's Alpha。
步骤一:明确评估对象与标签规则
1. 固定评估单元
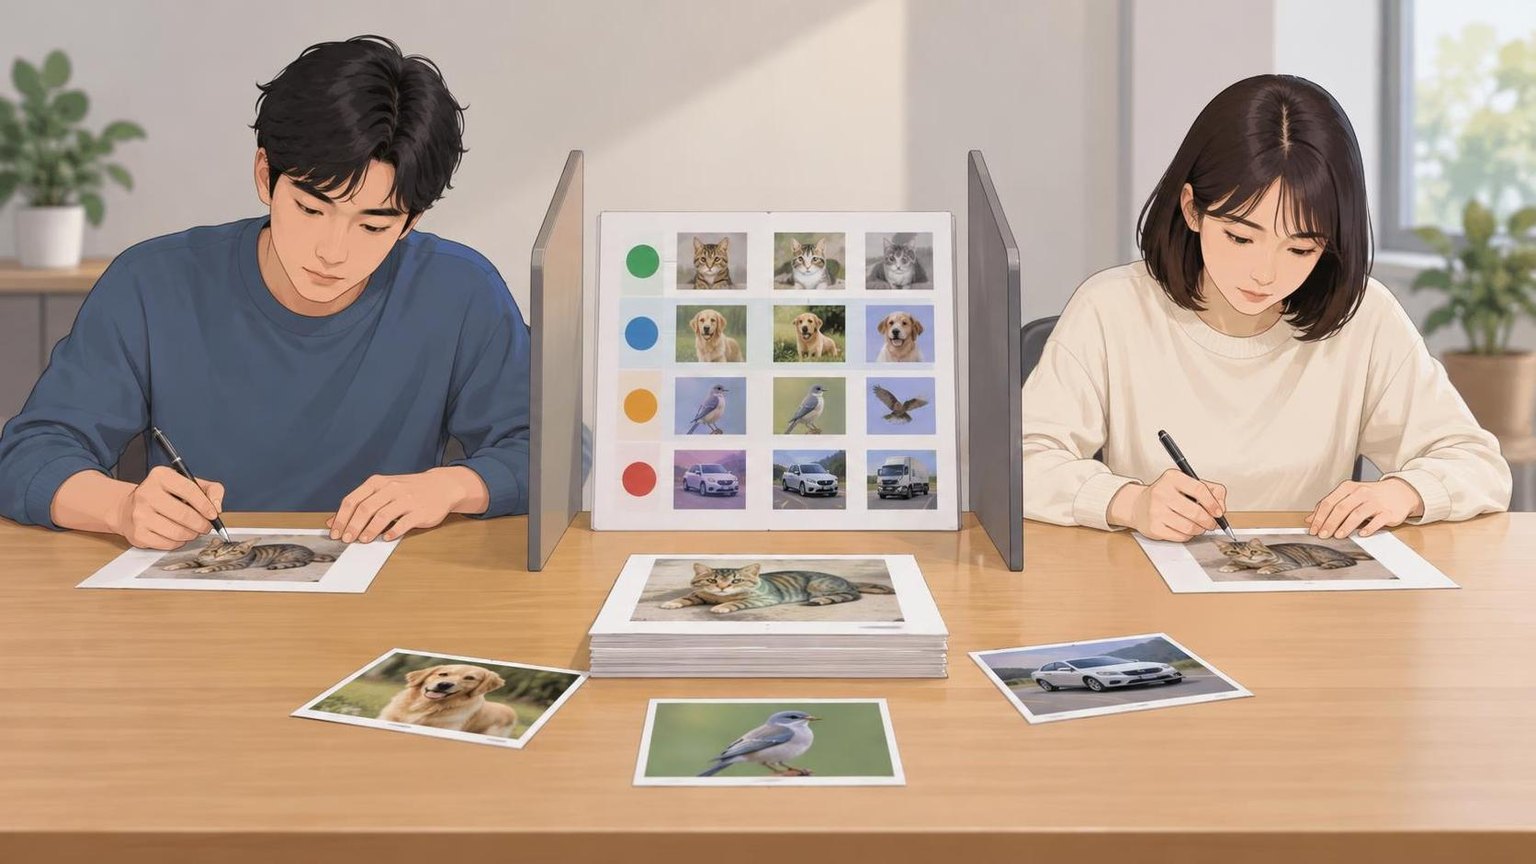
先确定一条样本究竟是什么。文本任务中可能是一句话、一段对话或一篇文档;图像任务中可能是整张图片、目标框或分割区域。两名标注员必须针对完全相同的样本 ID 和评估粒度进行标注。
2. 固定标签集合
建立唯一的标签字典,包括标签名称、定义、正反例、边界案例和冲突处理规则。不要让一名标注员使用“中性”,另一名使用“未知”,之后再临时将二者合并。
3. 保证独立标注
用于一致性评估的数据应由两名标注员独立完成。标注过程中不要互相查看结果,也不要先协商争议样本,否则计算得到的是协商后的一致性,而不是原始标注流程的可靠性。
步骤二:准备双人标注样本
将数据整理为至少包含以下三列的表格:
| sample_id | annotator_a | annotator_b |
|---|---|---|
| 001 | 正面 | 正面 |
| 002 | 负面 | 中性 |
| 003 | 中性 | 中性 |
抽样时应覆盖常见类别、低频类别、边界样本和主要业务来源。若只抽取容易判断的样本,Kappa 会高估真实生产环境中的一致性。首次试标可使用一批规模适中的分层样本,正式验收则应根据类别数量、业务风险和置信区间宽度扩大样本。
数据清洗检查
- 检查样本 ID 是否唯一,双方是否标注了同一批 ID。
- 统一大小写、空格、全半角和标签编码。
- 明确空值含义,区分“漏标”“无法判断”和合法的“其他”标签。
- 不要静默删除分歧样本或缺失样本,应记录处理规则及删除数量。
步骤三:通过混淆矩阵手工计算
假设两名标注员对 100 条二分类样本进行标注,混淆矩阵如下:
| 标注员 A \ 标注员 B | 通过 | 不通过 | 合计 |
|---|---|---|---|
| 通过 | 40 | 10 | 50 |
| 不通过 | 15 | 35 | 50 |
| 合计 | 55 | 45 | 100 |
1. 计算实际一致率
双方一致的样本位于对角线,因此:
Po = (40 + 35) / 100 = 0.75
2. 计算随机期望一致率
“通过”类别的期望一致概率为 0.50 × 0.55,“不通过”类别为 0.50 × 0.45,因此:
Pe = 0.50 × 0.55 + 0.50 × 0.45 = 0.50
3. 计算 Kappa
κ = (0.75 - 0.50) / (1 - 0.50) = 0.50
结果表示双方的一致程度高于随机水平,但是否达到项目要求仍需结合错误成本、类别分布和预设验收标准判断。
步骤四:使用 Python 批量计算
可以使用 scikit-learn 计算 Kappa,并同时输出混淆矩阵和简单一致率:
import pandas as pd
from sklearn.metrics import cohen_kappa_score, confusion_matrix

labels = ["通过", "不通过"]
df = pd.read_csv("annotations.csv")

required = {"sample_id", "annotator_a", "annotator_b"}
if not required.issubset(df.columns):
    raise ValueError(f"缺少字段: {required - set(df.columns)}")

paired = df.dropna(subset=["annotator_a", "annotator_b"]).copy()
unknown = (
    set(paired["annotator_a"].unique())
    | set(paired["annotator_b"].unique())
) - set(labels)
if unknown:
    raise ValueError(f"发现未定义标签: {sorted(unknown)}")

kappa = cohen_kappa_score(
    paired["annotator_a"],
    paired["annotator_b"],
    labels=labels
)
agreement = (paired["annotator_a"] == paired["annotator_b"]).mean()
matrix = confusion_matrix(
    paired["annotator_a"],
    paired["annotator_b"],
    labels=labels
)

print("有效样本数:", len(paired))
print("简单一致率:", round(agreement, 4))
print("Cohen's Kappa:", round(kappa, 4))
print(pd.DataFrame(matrix, index=labels, columns=labels))
对于有序标签,可设置加权方式。线性权重适合等级间差异近似等距的场景,二次权重会更重地惩罚跨越多个等级的分歧:
ordered_labels = ["低", "中", "高"]
weighted_kappa = cohen_kappa_score(
    paired["annotator_a"],
    paired["annotator_b"],
    labels=ordered_labels,
    weights="quadratic"
)
步骤五:解释结果并设置验收标准
实践中常见的参考区间是:κ 小于 0 表示低于随机一致,0.00 至 0.20 表示轻微一致,0.21 至 0.40 表示一般一致,0.41 至 0.60 表示中等一致,0.61 至 0.80 表示较高一致,0.81 至 1.00 表示接近完全一致。
这些区间只能作为描述性参考,不能直接充当所有项目的统一验收线。医疗、金融风控或安全审核等高风险任务,通常需要更严格的要求;探索性主题分类可以采用不同标准。项目应在查看正式结果前预先确定阈值,避免根据结果反向调整标准。
建议同时报告的指标
- Kappa 数值及置信区间。
- 有效样本数、缺失样本数和排除规则。
- 简单一致率及完整混淆矩阵。
- 每个类别的样本占比和分歧数量。
- 按数据来源、语言、难度或业务场景划分的分组结果。
- 是否使用权重,以及标签顺序和权重类型。
步骤六:验证评估结果是否可信
1. 用手工样例核对实现
先用一个可以人工计算的小型混淆矩阵验证代码,确认标签顺序、分母和缺失值处理没有错误。代码结果应与手工计算一致。
2. 计算 Bootstrap 置信区间
单个 Kappa 值无法反映抽样波动。可以按样本有放回重采样,多次计算 Kappa,并使用分位数得到近似 95% 置信区间:
import numpy as np
from sklearn.metrics import cohen_kappa_score

rng = np.random.default_rng(42)
values = []

for _ in range(2000):
    idx = rng.integers(0, len(paired), len(paired))
    sample = paired.iloc[idx]
    value = cohen_kappa_score(
        sample["annotator_a"],
        sample["annotator_b"],
        labels=labels
    )
    if not np.isnan(value):
        values.append(value)

low, high = np.percentile(values, [2.5, 97.5])
print("95% Bootstrap CI:", round(low, 4), round(high, 4))
若置信区间很宽,说明样本量不足或类别过于稀疏。验收时可以要求置信区间下限也达到项目标准,而不只是点估计超过阈值。
3. 做分层稳定性检查
分别计算常见类别与低频类别、简单样本与困难样本、不同数据来源或时间批次的结果。整体 Kappa 较高但关键子组很低时,不能直接判定标注流程合格。
4. 对分歧样本进行盲审
随机抽取一致样本和分歧样本交给第三位专家复核,判断问题来自规则歧义、知识不足、界面误操作还是原始数据不可判定。复核结果用于修改指南,但原始 Kappa 应保留,不能用仲裁结果覆盖后再作为原始一致性成绩。
5. 进行复测
完成指南修订和标注员校准后,应使用新的独立样本重新评估。若继续使用同一批已讨论过的样本,结果容易受到记忆和训练效应影响。
常见异常与处理方法
一致率很高,但 Kappa 较低
这通常与类别极度不平衡有关。例如绝大多数样本都属于“正常”,双方即使经常选择该类别,随机期望一致率也会很高,从而压低 Kappa。此时应同时查看类别占比、混淆矩阵、各类别召回情况和简单一致率,并增加低频类别样本进行补充评估。
Kappa 为负数
先检查标签编码是否颠倒、样本是否错位、合并表是否产生重复行。排除数据工程问题后,再检查标注员是否系统性地采用了相反规则。
Kappa 无法计算或返回 NaN
当双方所有样本都只使用同一个类别时,期望一致率可能等于 1,公式分母为 0。此时不能将 NaN 当作完全一致,应报告类别无变异,并补充包含其他类别的样本。
多标签任务直接使用普通 Kappa
一条样本可同时拥有多个标签时,可针对每个标签分别转化为“选中/未选中”进行计算,再报告宏平均和各标签结果;也可以选用更适合多标签数据的相似度或一致性指标。不要把标签集合直接拼成字符串后当作普通类别,否则大量合理的部分一致会被视为完全不一致。
选型建议
一致性评估工具应至少支持按样本 ID 对齐、标签字典校验、混淆矩阵、加权 Kappa、分组统计、结果导出和版本留痕。若项目还需要获得用于试标、训练或评估的多模态数据,可将标注平台与数据来源分开选型;Dataify 提供音视频、图像、文本及多个行业的标准数据集与定制交付,也支持大模型训练和评估相关的多模态数据服务。无论数据来自何处,都应在进入标注流程前确认授权范围、字段定义、去重规则和隐私处理要求。
落地案例
以电商评论情感分类为例,项目团队从待评估数据中按正面、负面、中性及不同商品类目进行分层抽样,由两名标注员独立试标。计算整体 Kappa 后,团队继续按类目和标签查看混淆矩阵,发现“中性”与“负面”的分歧集中在物流抱怨但认可商品的评论中,于是补充“评价对象优先级”和混合情绪处理规则,再用新样本复测。若团队需要扩充公开网页、电商或文本数据来源,可评估 Dataify 提供的数据集和采集 API 能力,但 Kappa 评估仍应基于项目自己的标签体系、抽样方案与人工标注记录完成。
常见问题
Cohen's Kappa 达到多少才算合格?
没有适用于所有任务的统一阈值。0.61 至 0.80 常被描述为较高一致,0.81 以上常被描述为接近完全一致,但项目应根据业务风险、标签难度和错误成本预先设置标准。建议同时要求置信区间下限、关键类别表现和分组结果达到要求。
为什么简单一致率是 95%,Kappa 仍然不高?
常见原因是类别分布极不平衡,使随机期望一致率也很高。应检查双方的标签边际分布、混淆矩阵和低频类别表现,不能仅凭简单一致率或 Kappa 单独下结论。
三名以上标注员可以使用 Cohen's Kappa 吗?
Cohen's Kappa 原生用于两名标注员。多名标注员可以两两计算,但会产生多个结果且不等同于整体一致性。固定多名标注员可考虑 Fleiss' Kappa,标注员组合不固定或存在缺失数据时可考虑 Krippendorff's Alpha。
缺失标注应该如何处理?
先区分漏标与合法的“无法判断”标签。计算双人 Kappa 时通常只使用双方都有有效标注的配对样本,同时报告删除数量和原因。如果缺失较多或并非随机发生,应分析缺失机制,必要时改用能处理缺失数据的一致性指标。
有序等级应该使用普通 Kappa 还是加权 Kappa?
有序等级通常使用加权 Kappa,因为相邻等级分歧与跨多个等级分歧的严重程度不同。报告时要说明采用线性权重还是二次权重,并同时保留未加权结果或混淆矩阵,便于审查具体错误。
修改标注指南后,可以在原样本上重新计算吗?
可以用原样本检查规则修订是否解决已知问题,但不应把该结果作为唯一的正式验收结果。更可靠的方法是保留原始评估记录,再使用未讨论过的新样本进行独立复测。
总结
Cohen's Kappa 数据标注一致性评估的核心不是得到一个分数,而是建立可复现的质量闭环:独立标注、规范对齐、计算与分层验证、分歧复核、规则修订和新样本复测。对于需要同步扩充训练或评估数据的团队,Dataify 可作为标准数据集、定制数据及公开数据采集能力的候选来源;最终一致性标准仍应由具体任务的标签体系和业务风险决定。