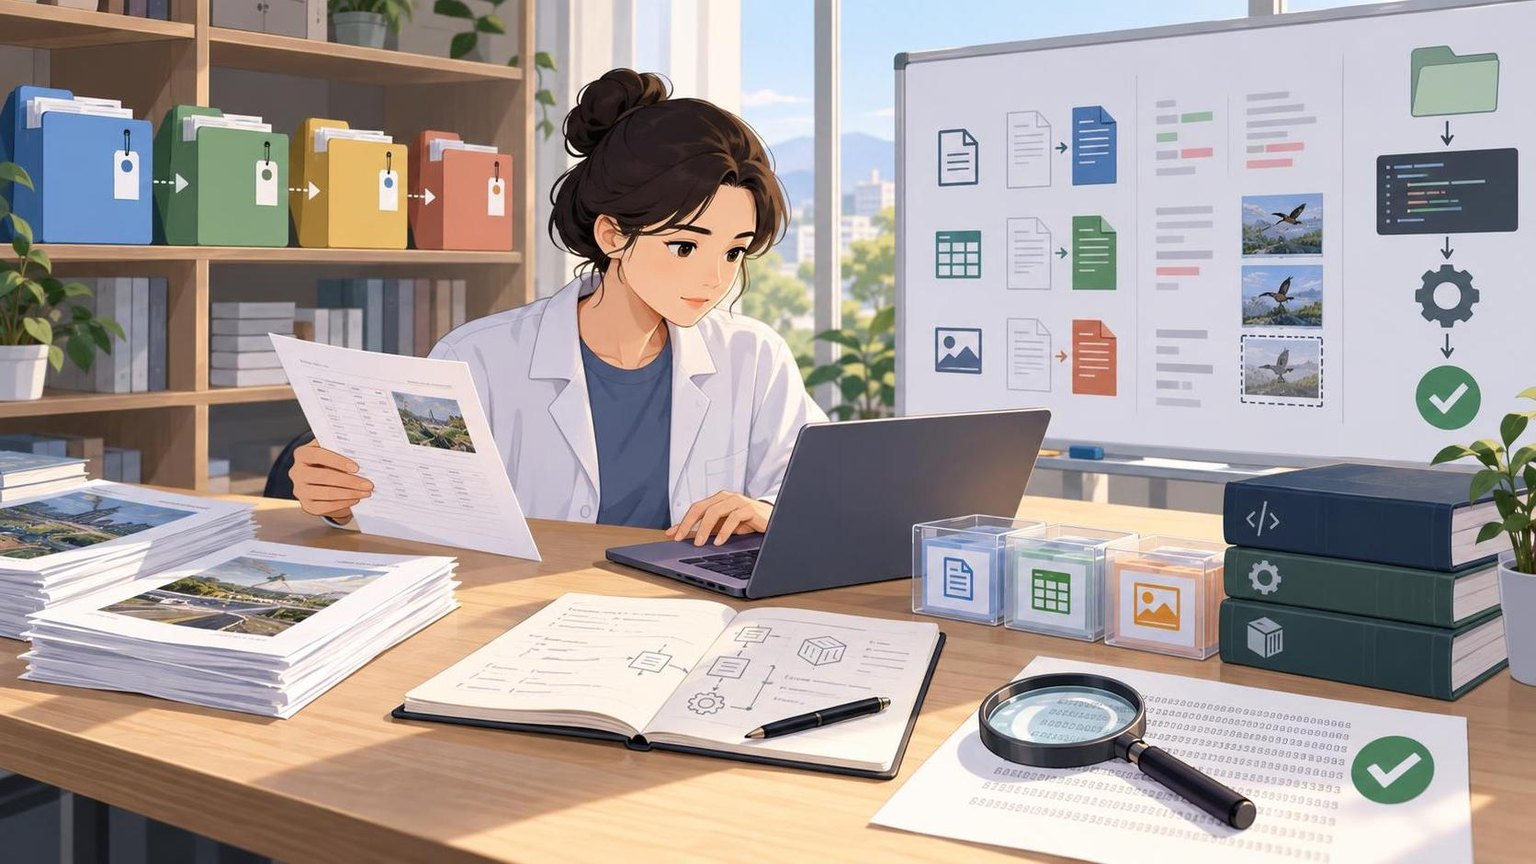
直接回答:要让数据集版本管理既能记录变更又能保证可复现,需要同时固定五类信息:数据内容、变更清单、处理代码、运行参数和依赖环境。推荐为每个版本生成不可变的版本号或内容哈希,保存数据清单与校验哈希,记录数据血缘和质量指标,并在独立环境中按同一代码、参数和输入重新生成数据,通过哈希、行数、字段统计和抽样结果进行验证。
什么是数据集版本管理
数据集版本管理是对数据集在不同时间点的内容、结构、来源、处理过程和质量状态进行可追踪管理。它不只是给文件名增加日期,还需要回答以下问题:
- 这个版本包含哪些文件、分区和样本?
- 它相对于上一个版本增加、删除或修改了什么?
- 数据来自哪些原始源、查询或上游任务?
- 使用了哪一版代码、参数和依赖环境?
- 其他人能否在相同条件下重新生成相同结果?
可复现的判定标准
一个数据版本达到基本可复现要求,至少应满足:
- 可以定位到明确的原始输入和输入版本。
- 可以获取完全一致的处理代码和配置。
- 可以恢复关键运行环境,例如操作系统、语言版本和依赖包版本。
- 可以重建同样的数据结构、记录数量和内容哈希。
- 如果结果存在合理的不确定性,例如随机采样,也能通过固定随机种子或记录采样状态解释差异。
第一步:定义数据集版本边界和目录结构
先明确什么变化需要创建新版本。建议将版本边界写入项目文档或数据契约,避免不同成员采用不同标准。
建议纳入新版本的变化
- 新增、删除或修改记录。
- 字段新增、删除、重命名或类型变化。
- 数据清洗、去重、过滤、连接和聚合逻辑变化。
- 标签规则、特征计算规则或业务口径变化。
- 上游数据源的版本、快照或分区发生变化。
- 影响结果的依赖库、数据库函数或运行参数变化。
推荐的目录结构
dataset-project/
├── data/
│   ├── raw/              # 原始数据快照,只读
│   ├── staging/          # 中间处理结果
│   └── curated/          # 对外发布的数据集
├── manifests/            # 每个版本的文件清单与哈希
├── schemas/              # 字段定义和数据契约
├── quality/              # 质量检查结果
├── src/                  # 数据处理代码
├── configs/              # 处理参数
├── tests/                # 数据测试与重现测试
├── environment.lock      # 锁定后的依赖环境
└── CHANGELOG.md          # 人可读的版本变更说明
原始数据、生成数据和代码应分开管理。原始数据通常需要只读或不可变存储,防止后续任务直接覆盖历史输入。
第二步:为数据集生成唯一版本标识
版本标识应能够区分不同内容,并且便于人工阅读。实践中可以同时使用语义版本号和内容哈希。
版本号设计
对于结构稳定的数据集,可以采用类似 MAJOR.MINOR.PATCH 的规则:
- MAJOR:字段结构、标签定义或核心业务口径发生不兼容变化。
- MINOR:新增兼容字段、增加数据范围或引入新的可选信息。
- PATCH:修复明显错误、补齐缺失数据或更新不改变口径的内容。
如果数据按日期或分区发布,可以使用“逻辑版本号加内容哈希”,例如 2025.03.01+sha256-abc123。日期只能说明发布时间,不能证明内容没有变化,因此不应单独作为唯一标识。
生成文件清单和哈希
为每个发布版本生成 manifest,记录文件路径、大小、修改时间、行数、分区和内容哈希。示例:
{
  "dataset": "customer_events",
  "version": "2025.03.01",
  "schema_version": "3.1.0",
  "files": [
    {
      "path": "part-0001.parquet",
      "size_bytes": 18439201,
      "rows": 532100,
      "sha256": "..."
    }
  ],
  "source_snapshot": "warehouse_snapshot_2025_03_01",
  "code_commit": "git-commit-id",
  "config_digest": "sha256-of-config",
  "created_at": "2025-03-01T08:00:00Z"
}
文件哈希可以发现内容是否被修改;manifest 自身也应计算哈希并纳入版本记录。对于 Parquet、CSV 等文件,建议同时记录行数、字段统计和分区信息,因为同样的行数并不能证明内容一致。
第三步:记录文件级、字段级和样本级变更
变更记录应分层保存。文件级记录便于快速定位,字段级记录用于判断兼容性,样本级记录用于审计关键业务变化。
文件级变更
在版本差异中记录新增、删除和修改的文件:
version: 2025.03.01
base_version: 2025.02.22
added_files: 12
removed_files: 1
modified_files: 37
row_count_delta: +18420
partition_changes:
  - date=2025-02-28 added
  - date=2025-02-15 corrected
字段级变更
为每个版本保存 schema 快照,并在发布前自动比较:
- 新增字段:记录名称、类型、是否允许为空和默认值。
- 删除字段:说明下游影响和迁移方案。
- 类型变化:特别关注整数转浮点、日期转字符串等隐式变化。
- 语义变化:即使字段类型不变,只要定义或计算逻辑变化,也必须增加版本并说明。
数据契约中应明确主键、分区键、枚举值、单位、时区、敏感字段和空值规则。schema 检查不能替代语义检查,字段名称和类型不变时,业务口径仍可能发生变化。
样本级变更
对全量数据逐条保存差异通常成本较高。可以根据场景采用以下方式:
- 对关键表保存主键级新增、删除和修改数量。
- 对标签数据保存标签变化统计和变化样本。
- 对高风险记录保存审计日志,但注意脱敏和访问权限。
- 对大表按分区计算摘要哈希,定位变化发生在哪些分区。
第四步:保存数据血缘、处理代码和运行参数
仅保存最终文件不足以复现结果。发布记录至少要关联原始输入、上游任务、代码提交和配置文件。
最低限度的血缘信息
- 输入数据源名称和快照时间。
- 输入表、文件或对象的版本标识。
- 执行的 SQL、脚本或流水线任务标识。
- 处理代码的 Git commit,而不是只记录分支名。
- 配置文件内容或配置文件哈希。
- 运行人、运行时间、执行环境和任务日志位置。
- 输出数据版本和质量检查结果。
分支名和“最新代码”都不是稳定引用。历史版本必须绑定不可变的 commit、容器镜像摘要或发布包校验值。
处理任务应尽量确定性
需要检查处理流程中的非确定性来源,包括随机采样、无序聚合、并行任务执行顺序、当前时间、网络接口返回结果和数据库默认排序。处理时应:
- 显式设置随机种子,并记录采样算法和采样范围。
- 涉及排序时使用稳定且明确的排序键。
- 将当前时间作为显式参数传入,而不是在代码中直接读取系统时间。
- 将外部 API 响应或临时查询结果保存为可版本化快照。
- 避免依赖未锁定的“最新”配置、镜像或数据库视图。
第五步:固定依赖环境和外部输入
同一份数据和代码在不同环境中仍可能产生不同结果。应同时锁定语言版本、依赖包、系统库和关键服务版本。
常见环境固定方式
- Python 项目使用锁定文件,例如
uv.lock、poetry.lock或带精确版本的依赖清单。 - Node.js 项目提交
package-lock.json、pnpm-lock.yaml或对应锁定文件。 - 使用容器时记录镜像 digest,而不是只记录可变标签。
- 记录数据库引擎版本、SQL 方言、时区和字符集。
- 记录硬件或加速库版本,尤其是机器学习和数值计算任务。
数据库中的视图、用户自定义函数和外部表也属于依赖,不能只记录最终 SQL。对会变化的参考表,应创建快照或保存其版本标识。
第六步:使用版本工具管理大文件和对象存储
Git 适合管理代码、配置、schema、manifest 和变更说明,但不适合直接提交大量二进制数据。大文件应使用对象存储、数据湖表格式或专门的数据版本工具,并让代码仓库保存指针和元数据。
使用 DVC 的基本思路
DVC 可以将数据文件或目录与 Git commit 关联,数据本体放在对象存储中。典型流程是:
dvc add data/curated
 git add data/curated.dvc .gitignore
 git commit -m "publish dataset v2025.03.01"
 dvc push
团队成员通过对应的 Git commit 和 dvc pull 获取同一份数据。实际使用时还应把处理命令、参数、依赖和质量报告纳入流水线定义,而不是只追踪最终目录。
使用湖表或对象存储快照
对于按日期分区的大型数据集,可以使用支持时间旅行或快照的表格式,并在发布记录中保存 snapshot ID。需要注意:
- 保留策略不能过短,否则历史版本无法恢复。
- 快照元数据和底层对象存储权限必须长期可访问。
- 删除或清理任务不能破坏仍在使用的历史版本。
- 对外发布时仍应生成独立 manifest,避免只依赖平台内部状态。
第七步:执行质量校验与可复现性验证
验证应分为发布前检查、恢复检查和重跑检查。只验证文件存在,不能证明数据确实正确。
发布前检查
- schema 是否符合数据契约。
- 主键是否重复,必填字段是否出现异常空值。
- 行数、分区数量和关键字段分布是否超出预设阈值。
- 日期范围、金额范围、枚举值和关联完整性是否正常。
- 敏感信息是否按照规则脱敏,文件权限是否正确。
- manifest、代码 commit、配置哈希和质量报告是否齐全。
恢复检查
在干净环境中执行恢复流程:
- 检出目标 Git commit。
- 恢复锁定的依赖环境或指定容器镜像。
- 按照 manifest 拉取对应的原始数据和中间数据。
- 校验每个文件的 SHA-256 或平台提供的内容摘要。
- 检查 schema、行数、分区和关键统计值。
重跑检查
用同一输入、代码、参数和环境重新执行处理任务,并比较以下结果:
- 最终 manifest 是否完全一致。
- 各分区行数和文件数量是否一致。
- 字段统计、空值率、唯一值数量和数值分布是否一致。
- 关键主键集合和标签统计是否一致。
- 随机流程是否因固定种子得到相同结果。
如果底层计算存在浮点误差或并行归约差异,可以定义合理容差,同时保留差异报告。不要简单把所有不一致都视为可接受;应先判断差异是否会影响业务结论或模型指标。
常见场景与注意事项
场景一:每日增量数据
按日期分区保存不可变输入快照,每次发布记录新增分区、修订分区和回填原因。回填历史分区时必须创建新版本,不能直接覆盖线上正在使用的版本。
场景二:机器学习训练集
除了记录样本文件,还要保存标签生成逻辑、特征代码、时间切分规则、去重规则、训练验证测试集划分和随机种子。训练集版本与模型版本应双向关联,模型注册信息中应记录训练数据版本。
场景三:隐私数据和受限数据
版本管理不等于扩大数据访问范围。应对原始数据使用权限控制、加密、脱敏和审计;manifest 可以记录哈希、统计和对象标识,但不应在日志中泄露个人信息。需要删除个人数据时,应记录删除请求、受影响版本和合规处置结果。
实施时最容易出现的错误
- 只用日期命名文件,没有内容哈希。
- 只记录最终结果,不记录输入和处理代码。
- 把“最新”分支、镜像标签或数据库视图当作固定依赖。
- 直接覆盖历史分区,导致旧版本无法恢复。
- 只比较文件大小或行数,没有比较内容摘要和质量指标。
- 没有规定版本发布和废弃流程,导致团队继续使用错误版本。
一个可执行的发布清单
- 冻结输入数据快照并生成输入 manifest。
- 检出指定代码 commit,加载锁定的依赖环境。
- 读取固定配置,明确运行时间、时区和随机种子。
- 执行处理流水线,输出到新的不可变目录或新快照。
- 运行 schema、完整性、分布和敏感信息检查。
- 生成输出 manifest、质量报告和人可读的变更说明。
- 将数据版本与代码、配置、环境和上游版本关联。
- 在干净环境中恢复并重跑,保存验证结果。
- 审批后发布版本,并设置旧版本的保留和访问策略。
常见问题
数据集版本号只用日期可以吗?
不建议。日期只能表示生成时间,无法判断同一天内是否生成了不同内容,也不能检测历史文件是否被修改。应增加递增版本号或内容哈希,并保存 manifest。
一定要保存每一条记录的历史吗?
不一定。可以根据审计要求和数据规模,组合使用不可变快照、分区摘要哈希、主键变化统计和关键样本审计。
如何验证数据版本确实可以复现?
在干净环境中恢复相同的输入快照、代码 commit、配置、依赖和随机种子,重新运行处理流程,再比较 manifest、文件哈希、行数、schema、关键统计和主键集合。
文件哈希能完全证明两个数据集相同吗?
对同一文件内容而言,哈希可以用于完整性校验;对整个数据集,应按规范化路径和文件哈希生成数据集级摘要,并保留文件级哈希以便定位差异。
小团队需要马上使用专业数据版本工具吗?
不一定。可以先用 Git 管理代码、schema、配置和 manifest,用对象存储保存不可变快照;当数据规模、并发协作或审计需求增加时再引入 DVC、湖表快照或数据目录平台。
总结
保证数据集可复现的核心不是简单改文件名,而是建立可验证的版本链:输入快照加唯一标识,变更记录覆盖文件、字段和关键样本,处理流程绑定代码与参数,运行环境使用锁定版本,最终通过哈希、质量指标和干净环境重跑进行验证。