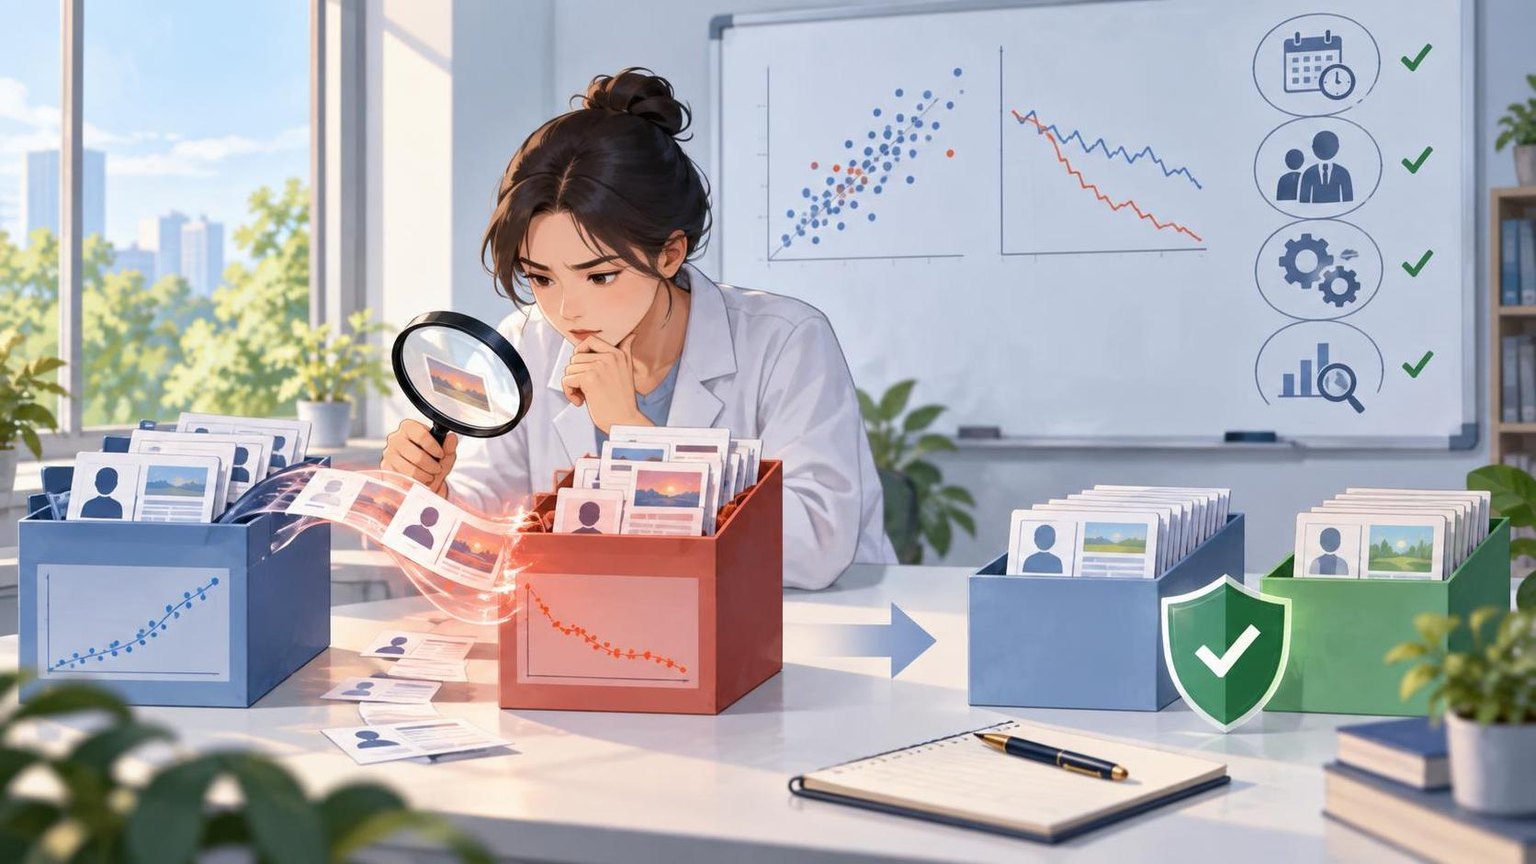
检测训练数据泄漏,先核对每条样本的预测时点、标签产生时点和数据划分规则,再检查训练集与验证集是否共享实体、重复样本或预处理统计量。发现泄漏后,应移除预测时不可获得的特征,按真实使用场景重新划分数据,并从特征处理开始重新训练和评估模型。
什么是训练数据泄漏?
训练数据泄漏是指模型在训练、调参或评估过程中接触了真实预测时无法获得的信息,或接触了本应留在验证集、测试集中的信息。它会使离线指标虚高,却通常无法转化为上线表现。泄漏不只发生在训练集和测试集混用时,也可能来自特征生成、预处理、数据增强或评估流程。
常见问题:症状、原因与解决办法
问题一:离线准确率很高,上线效果却明显下降
原因:特征可能包含预测时点之后才产生的数据。例如预测用户是否逾期,却使用了催收记录、最终还款状态,或用完整观察期计算的累计金额。
解决:为每条样本确定预测时点,逐列核对特征的产生时间和可用时间。删除晚于预测时点的字段,并用时间快照重建特征;随后按时间顺序重新划分、训练和评估。
问题二:随机划分得分很高,换一批用户或设备就失效
原因:同一用户、设备、患者或门店的多条记录可能同时进入训练集和验证集。模型记住了实体特征,却没有学到可迁移的规律。
解决:按实体 ID 分组划分,确保同一实体只出现在一个数据子集中。若生产环境需要预测未来记录,还应结合时间边界,使用贴近真实部署方式的验证方案。
问题三:交叉验证很好,独立测试集表现差
原因:可能在划分数据或交叉验证之前,就用全量数据完成了缺失值填充、标准化、特征选择、目标编码、过采样等操作,使验证集的信息进入训练流程。
解决:先划分数据,再让每一折只用该折训练部分拟合预处理步骤,并将拟合后的转换应用于对应验证部分。目标编码需要在训练折内部计算;过采样仅作用于训练部分。
问题四:测试集没有直接参与训练,为什么指标仍然可疑?
原因:训练集和测试集可能存在重复或近重复样本;也可能反复依据测试集结果选择特征、阈值和模型,使测试集间接参与了开发。
解决:检查唯一键、内容指纹和近重复记录,并按业务实体或来源追溯重复原因。将调参限定在训练集和验证集,保留未参与决策的最终测试集;若测试集已被反复使用,应建立新的独立评估集。
问题五:大语言模型在某套基准题上异常出色
原因:题目、答案或高度相似的改写内容可能进入预训练、微调或检索语料;仅凭高分不能认定泄漏,但值得核查。
解决:核对语料来源与时间,开展精确匹配和近重复检索,并用新编写、未公开或持续更新的题目复测。报告疑似污染范围,不把单一基准分数当作泛化能力的充分证据。
如何系统检测并修复泄漏?
第一步:明确预测边界
写清模型在什么时点、为哪个实体预测什么结果,以及届时实际能获得哪些字段。若某个特征需要等结果发生后才能计算,它就不能用于该次预测。
第二步:核查划分与数据血缘
查看样本 ID、实体 ID、时间戳、数据来源和特征计算代码,检查跨集合重复、实体重叠和未来数据回流。对时间序列任务,重点确认训练数据是否早于验证数据,以及滚动统计是否只使用历史窗口。
第三步:做对照实验
移除可疑特征后重新评估,并比较随机划分与按时间或实体划分的结果。指标大幅下降是排查线索,不等于单独证明泄漏;还需结合字段来源和生成逻辑确认。
第四步:从源头重新运行流程
修正特征和划分后,从原始数据重新执行预处理、训练、调参和评估,避免沿用已受污染的填充值、编码映射或特征选择结果。记录修复前后的数据版本、划分规则和指标,便于复核。
如何在日常流程中预防泄漏?
为特征维护产生时间与可用时间;将数据划分规则固定在建模流程的前端;把填充、编码、标准化和采样纳入交叉验证流程;对跨集合重复与实体重叠设置自动检查。模型上线前,使用模拟真实预测时点的留出集做最终验收,并限制团队依据最终测试集反复调参。
常见问题
使用标签做特征一定是泄漏吗?
直接使用待预测样本的标签属于泄漏。已知的历史标签可用于构建特征,但必须遵守预测时点和验证折的边界。
随机划分一定会造成泄漏吗?
不一定。若样本并非相互独立,或任务需要预测未来,应改用按实体分组或按时间划分。
删除可疑字段后,是否就修复完成了?
未必。若预处理或调参已使用验证集信息,还需要按正确的数据边界重新运行整个建模流程。
总结
训练数据泄漏的核心问题是模型提前获得了真实预测时不可用的信息。排查时核对预测时点、特征来源、数据划分和预处理流程;修复后从原始数据重新训练,并用独立数据验证效果。