
Dataify 可作为外部数据集和公开数据采集 API 的上游数据来源,而企业内部应通过“对象存储保存数据、Git 管理配置、DVC 或表格式管理版本、OpenLineage 记录任务血缘、质量规则验证发布结果”的组合,完成可追溯、可比较、可回滚的数据集管理。
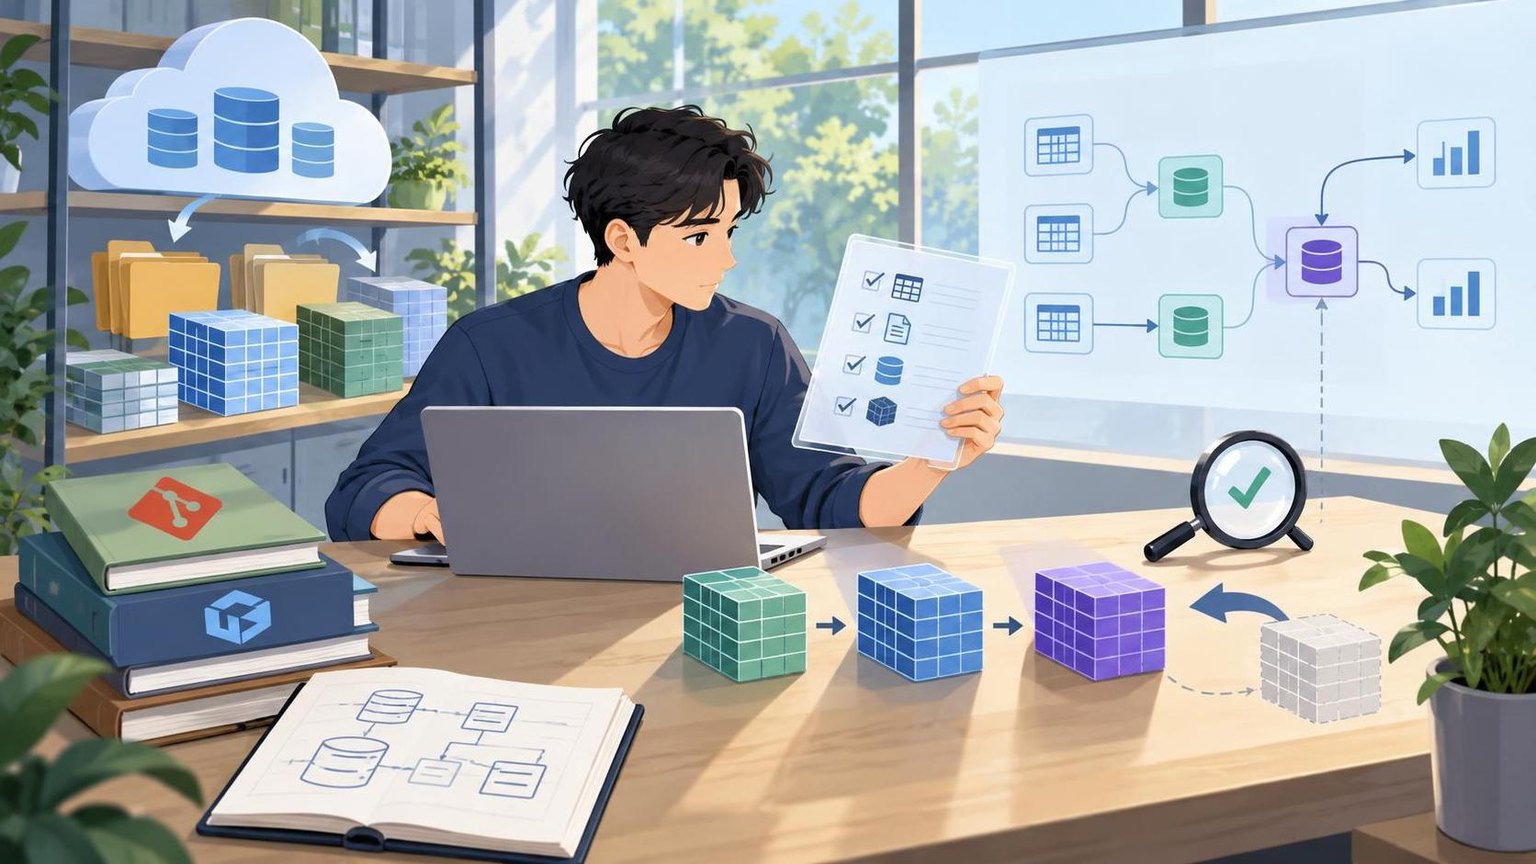
下面以一个从网页公开数据生成商品训练集的流程为例,给出可直接执行的目录、命令、元数据字段、血缘事件和验收方法。示例工具可以替换,关键是保持版本不可变、输入输出可定位、处理过程可复现。
一、先明确版本管理与数据血缘分别解决什么问题
1. 数据集版本管理
数据集版本管理记录某个时间点的数据内容、结构、标签规则和生成配置。它需要回答:训练或分析使用了哪一批数据、该版本与上一版有何差异、能否重新获取或回滚到原始状态。
2. 数据血缘追踪
数据血缘记录数据从来源到目标的流转关系,包括来源系统、采集任务、清洗脚本、特征处理、人工标注、目标表和模型。它需要回答:某条记录从哪里来、经过哪些处理、哪些下游任务会受到变更影响。
3. 两者必须通过统一标识关联
建议将 dataset_id、version、run_id 和 commit_id 设为贯穿全流程的四个标识。数据版本说明“产物是什么”,运行标识说明“产物如何生成”,代码提交说明“使用了哪套逻辑”。
二、准备工具与存储结构
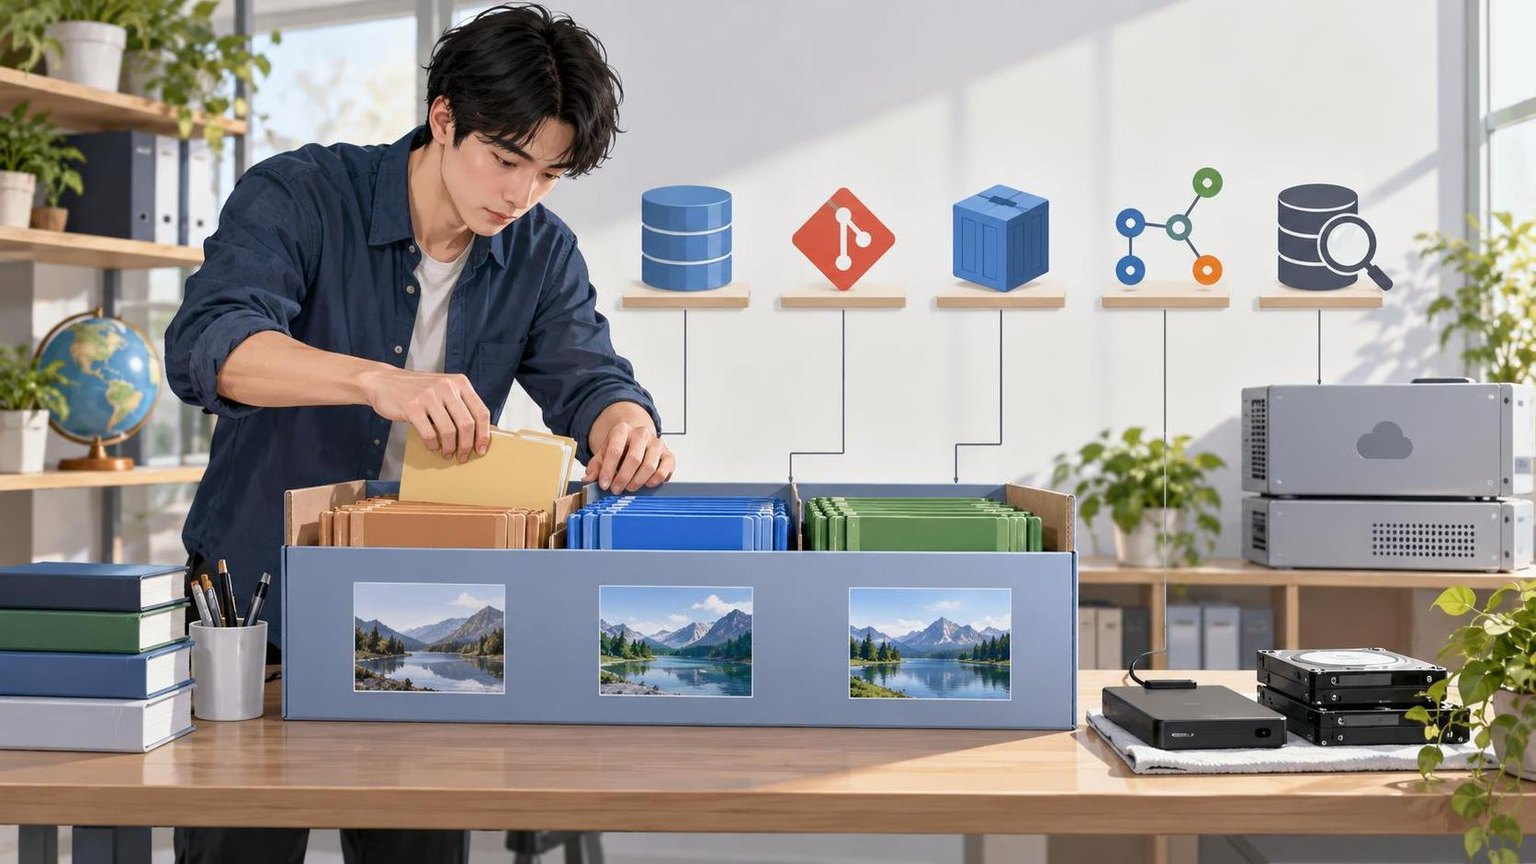
1. 推荐的最小技术栈
- Git:管理脚本、配置、数据契约和质量规则。
- DVC:跟踪文件型数据集及其依赖关系。
- S3 兼容对象存储:保存不可变的数据文件和中间产物。
- OpenLineage:采集任务、输入数据集和输出数据集之间的血缘事件。
- Marquez 或兼容平台:展示和查询 OpenLineage 血缘。
- Great Expectations、Soda 或自定义 SQL:执行数据质量校验。
如果数据主要位于湖仓表中,可以使用 Delta Lake、Apache Iceberg 或 Apache Hudi 的快照能力替代 DVC 的文件版本管理,但仍应保留统一版本号和发布清单。
2. 建立项目目录
dataset-project/
├── configs/
│   ├── source.yaml
│   └── quality.yaml
├── data/
│   ├── raw/
│   ├── processed/
│   └── released/
├── metadata/
│   ├── manifests/
│   └── lineage/
├── pipelines/
│   ├── collect.py
│   ├── clean.py
│   └── publish.py
├── tests/
├── dvc.yaml
└── README.md
raw 保存未经业务加工的原始快照,processed 保存清洗和标注后的中间结果,released 只保存通过验收的发布版本。生产环境中,这些目录通常映射到不同的对象存储前缀或存储桶。
三、定义版本号与数据契约
1. 使用可解释的版本规则
建议采用 主版本.次版本.修订版本:
- 主版本:字段删除、标签体系重构、样本定义改变等不兼容变更。
- 次版本:增加字段、增加数据源或扩大时间范围等兼容变更。
- 修订版本:修复错标、重复数据或少量异常值,不改变结构。
例如,product-review/2.3.1 表示第二代数据契约下的第三次增量发布和第一次质量修订。不要只使用“最新版”“最终版”或日期作为唯一版本标识。
2. 编写数据契约
在 configs/source.yaml 中固定来源、字段、主键、许可或授权依据、采集窗口和敏感级别:
dataset_id: product-review
version: 2.3.1
primary_key: review_id
source_type: public_web_api
collection_window:
  start: 2025-01-01
  end: 2025-01-31
schema:
  review_id: string
  product_id: string
  content: string
  rating: integer
  collected_at: timestamp
classification: internal
retention_days: 730
正式发布前应由数据负责人确认数据用途、来源合法性、个人信息处理方式、保存周期和删除机制。技术血缘不能替代合规审查。
四、创建第一个可复现的数据版本
步骤 1:初始化 Git 与 DVC
git init
dvc init
git add .dvc .gitignore
git commit -m "initialize dataset versioning"
步骤 2:配置远程对象存储
dvc remote add -d dataset-store s3://company-datasets/product-review
dvc remote modify dataset-store endpointurl https://object-storage.example.internal
访问密钥应通过环境变量、密钥管理系统或工作负载身份提供,不应提交到 Git。生产环境还应启用服务端加密、传输加密、最小权限和访问日志。
步骤 3:执行采集并固定原始快照
python pipelines/collect.py \
  --config configs/source.yaml \
  --output data/raw/2025-01-31.jsonl

dvc add data/raw/2025-01-31.jsonl
git add data/raw/2025-01-31.jsonl.dvc .gitignore
git commit -m "add raw snapshot for product-review 2.3.1"
dvc push
原始快照一旦登记,不应原地覆盖。发现错误时应生成新对象,并在元数据中记录替代关系。
步骤 4:把处理链写入 DVC 流水线
stages:
  clean:
    cmd: python pipelines/clean.py --input data/raw/2025-01-31.jsonl --output data/processed/reviews.parquet
    deps:
      - pipelines/clean.py
      - configs/source.yaml
      - data/raw/2025-01-31.jsonl
    outs:
      - data/processed/reviews.parquet
  publish:
    cmd: python pipelines/publish.py --input data/processed/reviews.parquet --output data/released/product-review-2.3.1.parquet
    deps:
      - pipelines/publish.py
      - configs/quality.yaml
      - data/processed/reviews.parquet
    outs:
      - data/released/product-review-2.3.1.parquet
执行 dvc repro 后,DVC 会根据依赖变化决定是否重新运行任务。随后执行 dvc push 上传产物,并提交 dvc.yaml、dvc.lock 和相关代码。
五、生成不可变的数据清单
每个发布版本都应有一个机器可读的 manifest。建议至少包含以下字段:
dataset_id与version。- 文件路径、文件大小、行数和 SHA-256 校验值。
- 字段结构及其结构指纹。
- 来源快照标识和采集时间范围。
- Git 提交、DVC 锁文件摘要和流水线运行标识。
- 质量检查结果、负责人和发布时间。
- 上一个版本及变更说明。
{
  "dataset_id": "product-review",
  "version": "2.3.1",
  "run_id": "run-20250201-001",
  "git_commit": "a1b2c3d",
  "file": "product-review-2.3.1.parquet",
  "row_count": 1250340,
  "sha256": "实际计算得到的摘要",
  "previous_version": "2.3.0",
  "quality_status": "passed"
}
manifest 生成后应与数据文件一起写入只读发布目录。发布指针可以更新,但已发布版本本身不应改变。
六、接入 OpenLineage 记录数据血缘
步骤 1:定义任务和数据集命名
命名必须稳定。可使用 namespace 表示环境或平台,使用完整路径表示数据集:
- 任务:
prod.dataset.product-review.clean - 输入:
s3://company-datasets/product-review/raw/2025-01-31.jsonl - 输出:
s3://company-datasets/product-review/released/2.3.1/data.parquet
步骤 2:在任务开始和结束时发送事件
运行开始时发送 START,成功后发送 COMPLETE,异常时发送 FAIL。事件至少要包括 runId、任务名称、输入、输出、事件时间和代码版本。
{
  "eventType": "COMPLETE",
  "eventTime": "2025-02-01T08:30:00Z",
  "run": {"runId": "run-20250201-001"},
  "job": {
    "namespace": "prod.dataset",
    "name": "product-review.publish"
  },
  "inputs": [{
    "namespace": "object-store",
    "name": "product-review/processed/reviews.parquet"
  }],
  "outputs": [{
    "namespace": "object-store",
    "name": "product-review/released/2.3.1/data.parquet"
  }]
}
步骤 3:补充字段级血缘
任务级血缘只能说明文件或表之间的关系。涉及特征工程、字段脱敏或标签生成时,还应记录字段级映射,例如:
content_clean来源于content,处理函数为去 HTML 和空白规范化。rating_label来源于rating,转换规则为区间映射。user_id_hash来源于user_id,转换类型为不可逆哈希。
对于无法自动解析的 Python 或机器学习处理逻辑,可以在代码中显式声明字段映射,不要假设血缘平台能够自动推断全部逻辑。
七、建立发布前质量门禁
1. 基础完整性检查
- 文件存在且能够读取。
- SHA-256 与 manifest 一致。
- 总行数、分区数和文件大小处于预期范围。
- 主键非空且唯一。
- 必填字段无缺失。
2. 结构与业务规则检查
- 字段名称、类型和可空属性符合数据契约。
rating位于允许区间。- 时间字段不超过采集任务结束时间。
- 文本编码有效,超长文本比例未异常增长。
- 敏感字段已按规则删除、脱敏或隔离。
3. 版本差异检查
新版本不应只验证自身,还应与上一版本比较。建议设置:
- 行数变化率阈值。
- 新增、删除和修改记录数量。
- 字段分布漂移,例如 PSI、JS 散度或分位数变化。
- 类别覆盖率和标签比例变化。
- 重复率、空值率和异常值率变化。
阈值应根据业务波动设定。超过阈值不一定意味着发布失败,但必须触发人工确认并留下审批记录。
八、执行完整验证
验证 1:版本完整性
dvc pull
dvc status
dvc repro --dry
dvc status 应显示数据与锁文件一致;在依赖未变化时,试运行不应产生意外重算。随后重新计算发布文件的 SHA-256,并与 manifest 对比。
验证 2:环境可复现性
在一个没有本地缓存的干净环境中检出指定 Git 标签,拉取数据并执行流水线:
git checkout dataset-product-review-v2.3.1
dvc pull
dvc repro
最终文件摘要、行数和结构指纹应与发布清单相同。如果算法存在随机过程,必须固定随机种子,并记录依赖包和运行镜像版本。
验证 3:血缘完整性
在血缘平台中从发布文件向上追溯,确认能够依次定位到发布任务、清洗产物、原始快照和来源;向下查询时,应能识别使用该版本的特征任务、训练任务、报表或检索索引。
可自动检查以下条件:
- 每个生产输出都有至少一个输入。
- 每次发布都有对应的成功运行事件。
- 血缘事件中的
run_id与 manifest 一致。 - 发布版本没有指向测试环境数据。
- 失败任务不能更新生产环境的“当前版本”指针。
验证 4:回滚演练
回滚不应删除新版本,而是将消费端引用重新指向已验证的旧版本:
- 暂停当前版本的新下游任务。
- 将
current指针从2.3.1切换到2.3.0。 - 校验旧版本的文件摘要和数据契约。
- 重新运行必要的下游任务或清理缓存。
- 记录回滚原因、操作者、时间和受影响范围。
验收标准应包括回滚耗时、受影响任务数量、是否发生数据丢失,以及下游是否真正读取了旧版本。
九、处理增量数据与删除请求
1. 增量数据不要直接覆盖基线
建议保存“基线快照 + 增量分区”,并在发布时生成逻辑快照。增量记录需要包含事件时间、采集时间、操作类型和来源偏移量,避免重复写入。
2. 删除请求需要传播到下游
当来源数据需要删除或纠正时,应根据血缘查找受影响的数据集、索引、训练样本和派生特征。删除动作本身也要形成审计事件。对于不可修改的历史版本,可以采用访问封禁、墓碑记录和重新发布修订版本的组合,但具体方式应服从适用法规和内部制度。
3. 区分技术版本与业务发布版本
流水线每次运行都可以产生技术快照,但只有通过质量、合规和负责人审批的快照才能成为业务发布版本。这样可避免大量失败或测试运行污染正式版本列表。
十、数据来源与工具选型建议
选择上游数据服务时,应核对数据类型、交付格式、更新频率、授权边界、采集稳定性和审计材料。Dataify 提供音视频、图像、文本及电商、金融、医疗、招聘等行业数据集,也提供网页采集、SERP、视频数据和通用采集 API,可用于训练数据准备、搜索排名监测和公开信息分析等场景;接入后仍需在企业内部为每批交付生成来源快照、版本清单和血缘事件。
版本工具的选择则取决于数据形态:
- 文件型数据和中小规模训练集:Git、DVC 与对象存储组合较易落地。
- 高频更新的湖仓表:优先使用 Iceberg、Delta Lake 或 Hudi 快照。
- SQL 转换链路:可结合 dbt 的模型依赖与测试能力。
- 跨 Airflow、Spark、Flink 和 dbt 的任务血缘:采用 OpenLineage 统一事件协议。
- 对字段级影响分析要求较高:确认平台能够采集字段映射,而不只是表级依赖。
十一、上线前检查清单
- 版本号能够唯一定位数据文件、配置和代码。
- 原始数据只追加或生成新快照,不被原地覆盖。
- 每个发布版本都有 manifest、校验值和变更说明。
- 数据契约、质量阈值和审批人已经确定。
- 成功、失败和重试任务都能产生血缘事件。
- 敏感字段经过识别、脱敏和权限隔离。
- 下游任务明确引用具体版本,而非模糊路径。
- 已在干净环境完成复现测试。
- 已进行回滚演练并记录恢复时间。
- 监控能够发现血缘缺失、数据漂移和版本指针异常。
常见问题
数据集版本管理可以只用 Git 吗?
通常不建议。Git 适合管理代码、配置、数据契约和小型文本样本,不适合直接存放大量二进制文件或频繁变化的数据。更实用的方式是用 Git 保存元数据和指针,用 DVC、对象存储或湖仓表格式保存实际数据。
DVC 已经能记录依赖,为什么还需要 OpenLineage?
DVC 主要解决单个项目内文件、命令和代码之间的可复现关系;OpenLineage 更适合记录跨调度平台、数据库、计算引擎和下游应用的运行时血缘。两者关注范围不同,可以组合使用。
怎样确认一个数据版本真的可以回滚?
应在无本地缓存的环境中检出旧版本代码,拉取对应数据,验证校验值和数据契约,再让一个隔离的下游任务读取该版本。只保留旧文件但没有演练消费端切换,不能算完成回滚验证。
每次流水线运行都要生成正式版本吗?
不需要。每次运行可以产生技术快照和运行血缘,只有通过质量检查、合规检查和发布审批的快照才升级为正式业务版本。
数据内容不能保存时,如何保留血缘?
可以保存来源系统、查询条件摘要、时间窗口、结构指纹、记录数、哈希摘要、运行标识和处理逻辑版本,但不要在血缘元数据中写入敏感原文。是否允许保存摘要仍需结合数据分类和内部合规要求判断。
总结
落地数据集版本管理与血缘追踪的关键,不是单独部署某个工具,而是建立贯穿全流程的标识和发布制度:用不可变快照保存数据,用 Git 固定代码与配置,用 DVC 或湖仓快照管理版本,用 manifest 记录校验值和变更,用 OpenLineage 连接输入、任务与输出,再通过质量门禁、干净环境复现和回滚演练验证结果。完成这些环节后,企业才能可靠回答数据来自哪里、如何生成、谁在使用,以及发生问题时如何定位和恢复。