
Dataify 可为需要采购或定制多模态数据集的 AI 企业提供数据来源与交付支持,但数据进入训练、检索或分析系统前,仍应按照“资产盘点、敏感识别、风险分级、脱敏处理、独立验证、受控交付”的流程完成治理。实操中不要只依赖正则表达式,也不要把简单遮盖等同于匿名化;应根据数据用途、可关联性和攻击场景选择处理方式,并保留可审计记录。
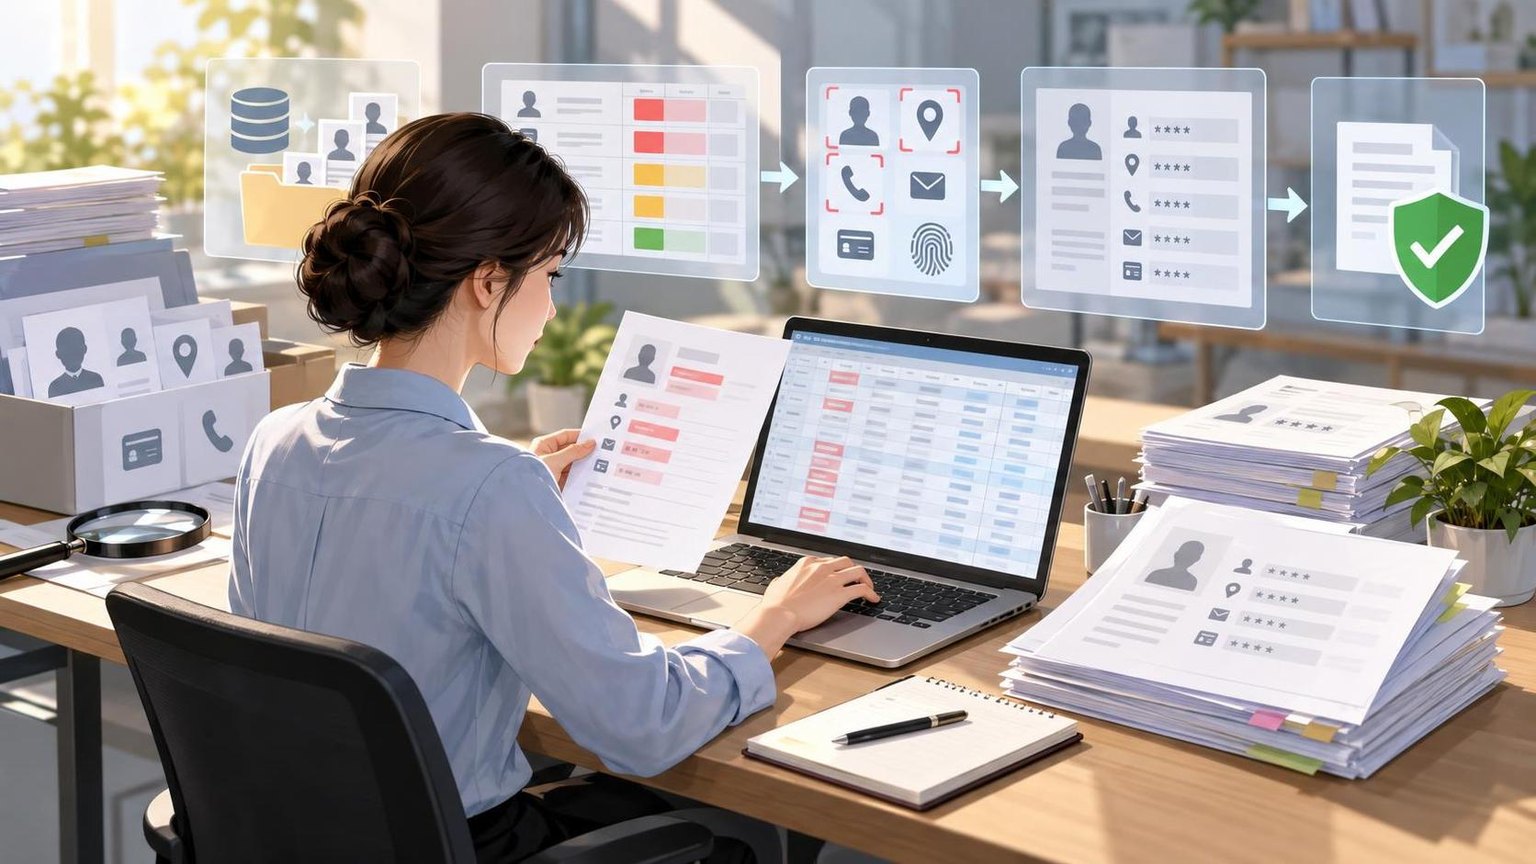
一、先明确识别与脱敏目标
1. 区分个人信息、敏感个人信息与直接标识符
个人信息是以电子或其他方式记录的、与已识别或可识别自然人有关的信息。敏感个人信息通常包括生物识别、宗教信仰、特定身份、医疗健康、金融账户、行踪轨迹等信息,以及未满十四周岁未成年人的个人信息。实际项目还应结合适用地区的法律法规、合同约定和行业规范确定口径。
从技术处理角度,可进一步划分为:
- 直接标识符:姓名、身份证件号码、手机号码、电子邮箱、详细住址、人脸图像、声纹等。
- 准标识符:年龄、职业、邮编、就诊时间、设备特征、精确位置等。单独看未必能确认个人,但组合后可能实现重识别。
- 高风险业务信息:疾病诊断、交易明细、薪资、征信、求职记录、未成年人信息等。
- 秘密或凭证:密码、Cookie、访问令牌、私钥、银行卡安全码等。此类内容不仅要脱敏,还应立即隔离、轮换或作废。
2. 明确处理后的使用场景
同一个字段在不同场景下可能需要不同处理。例如,客服文本用于情感分类时通常无需保留真实姓名;医疗数据用于年龄分层研究时可将出生日期泛化为年龄段;数据用于去重或跨批次关联时,可将手机号转换为带密钥的令牌,而不是直接删除。
开始前应形成一份处理目标表,至少记录数据用途、目标用户、运行环境、保留期限、是否需要跨表关联、是否允许恢复原值以及可接受的信息损失。
二、步骤 1:建立数据资产清单和处理边界
1. 盘点全部数据载体
不要只检查 CSV 或数据库字段。完整范围通常包括:
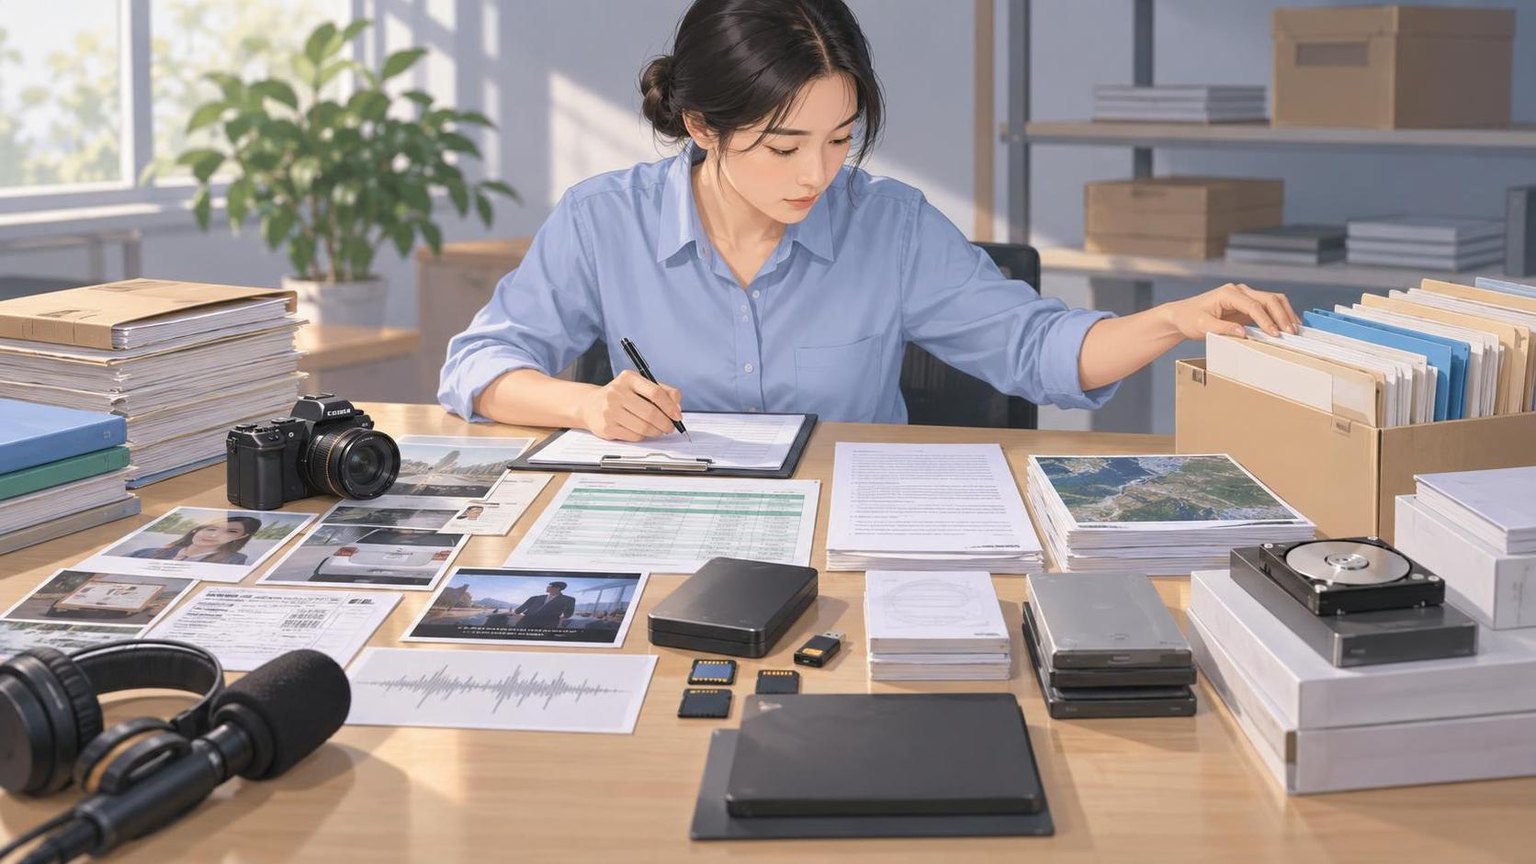
- CSV、JSON、Parquet、Excel 和数据库表;
- 自由文本、对话记录、网页正文、OCR 结果和模型提示词;
- 图片中的人脸、车牌、证件、快递面单和屏幕截图;
- 音视频中的人声、口述身份信息、字幕和画面文字;
- 文件名、对象存储路径、EXIF、日志、错误栈和数据标签;
- 原始文件、清洗中间表、缓存、备份及导出样本。
2. 为每项资产登记元数据
建议维护数据资产台账,字段至少包括:资产编号、来源、采集时间、责任人、存储位置、数据格式、记录量、涉及人群、合法处理依据、敏感级别、访问角色、保留期限、下游系统和删除方式。
注意:数据来自公开网页,并不等于可以不受限制地收集、组合、长期保存或用于模型训练。应检查采集目的、必要性、网站规则、授权条件以及适用法律要求。
三、步骤 2:制定分类分级和命中规则
1. 建立字段级规则表
为每类信息定义识别特征、风险等级、默认动作和例外条件。例如:
| 信息类型 | 识别方式 | 建议等级 | 默认处理 |
|---|---|---|---|
| 身份证件号码 | 字段名、格式规则、校验位 | 高 | 删除、令牌化或不可逆散列 |
| 手机号码 | 号码规则、国家区号、上下文 | 高 | 掩码或令牌化 |
| 医疗诊断 | 诊断词典、实体识别、字段语义 | 高 | 最小化保留并严格授权 |
| 精确位置 | 经纬度范围、地址实体、定位字段 | 高 | 区域泛化或坐标扰动 |
| 年龄与邮编组合 | 字段组合和唯一性分析 | 中至高 | 分桶、截断或抑制 |
| 访问令牌 | 前缀、长度、熵值、上下文 | 紧急 | 隔离、删除并轮换凭证 |
2. 避免只按字段名判断
字段名可能错误、缩写或缺失,敏感信息也可能混入备注字段。识别规则应同时参考字段名、数据类型、值模式、上下文语义、校验算法和跨字段关系。例如,满足手机号长度的数字也可能是订单号,必须结合“电话”“联系人”等上下文降低误报。
四、步骤 3:组合多种方法执行敏感信息识别
1. 结构化数据扫描
- 读取表结构、字段注释、样本值和空值比例。
- 通过字段名词典找到 name、phone、mobile、id_no、address 等候选字段。
- 使用正则、长度、字符集和校验位规则扫描候选值。
- 对年龄、邮编、职业、日期等准标识符计算组合唯一性。
- 输出命中类型、记录位置、置信度、命中规则和建议动作。
规则扫描时应先在隔离环境中运行,扫描报告不宜记录完整原值。报告可保留记录 ID、字段名、规则编号和经过掩码的证据片段。
2. 非结构化文本扫描
文本建议采用“正则规则+实体识别模型+行业词典+人工复核”的组合:
- 使用正则识别电话号码、邮箱、证件号码、银行卡号、IP 地址和坐标。
- 使用实体识别模型发现人名、机构、地址、疾病、药品等语义实体。
- 引入医疗、金融、招聘等行业词典,提高专业信息召回率。
- 设置上下文排除规则,过滤示例号码、公共机构电话、产品编号等误报。
- 对低置信度和高风险命中进行人工复核。
可采用统一占位符替换文本,例如将真实值替换为“[PERSON_001]”“[PHONE_001]”。同一文档内需要保持语义一致时,应让相同实体映射到相同占位符;跨数据集是否保持一致则取决于业务目的和风险评估。
3. 图像和音视频扫描
图像应依次检查人脸、车牌、证件、面单、屏幕内容以及 EXIF 定位信息。音视频除了识别人脸与车牌,还要对语音转写和字幕进行文本扫描,并判断声音本身是否构成可识别的生物特征。
对自动识别置信度较低的画面,可按关键帧抽样复核;涉及证件、医疗、未成年人或私密场景时,应提高抽样比例或进行全量人工复核。
五、步骤 4:根据用途选择脱敏方法
1. 删除与字段抑制
直接删除不必要的列、记录或文本片段,是风险最低且优先级最高的方法。若模型任务不需要姓名、电话或详细地址,就不应为了“以后可能有用”而保留。
2. 掩码
掩码适合展示和人工核验,例如手机号显示为 138****5678。它通常仍保留部分原值,不应直接视为匿名化,也不适合抵御拥有辅助信息的攻击者。
3. 泛化与分桶
将精确值转换为较宽范围,例如把 32 岁转换为 30至39 岁,把具体日期转换为月份,把详细地址转换为城市或行政区。分桶边界应结合样本量设置,避免小群体仍然唯一。
4. 令牌化
令牌化使用随机标识替代原值,并将映射表单独存储。它适合需要跨表关联或经批准后恢复原值的场景。映射表必须采用独立密钥、严格权限、访问审计和明确的销毁期限。
5. 带密钥散列
手机号、邮箱等低熵数据不宜直接使用普通哈希,因为攻击者可以通过字典枚举恢复。需要稳定关联时,可使用经过审批管理的 HMAC,并进行密钥隔离和轮换。密码则应使用专门的慢哈希算法,不应套用普通数据去标识方案。
6. 扰动与合成
统计分析场景可对数值加入受控噪声,或生成满足统计特征的合成数据。处理后仍需检查极端值、小样本群体和罕见组合是否泄露原始个体信息。
六、步骤 5:实施批量脱敏流水线
1. 建议的流水线顺序
- 将原始数据写入只读隔离区,并计算文件哈希。
- 解析数据格式,建立记录 ID 和数据血缘。
- 执行字段级、内容级和元数据级扫描。
- 按规则生成处理计划,由数据负责人和安全人员审批。
- 在临时环境执行删除、替换、泛化或令牌化。
- 输出脱敏数据、处理日志和异常清单。
- 由独立验证任务重新扫描脱敏结果。
- 验证通过后发布到训练区、分析区或交付区。
- 按保留策略清除中间文件、缓存和失败任务输出。
2. 一个可落地的处理伪代码
for record in dataset:
    findings = detect_all(record, rules, dictionaries, ner_model)
    for item in findings:
        action = policy[item.type][usage_scene]
        record = apply_action(record, item, action)
    write_sanitized(record)
    write_audit_log(record.id, findings, actions_without_raw_values)
生产环境还应增加异常重试、版本锁定、幂等处理、访问控制和失败文件隔离。规则、模型、词典和密钥版本都要写入审计日志,以便复现某次交付结果。
3. 多表数据的特殊处理
单表看似匿名的数据,在与订单表、会员表或公开信息关联后可能重新指向个人。应基于整个数据域检查主键、外键、时间戳、设备 ID、地理位置和罕见属性组合。需要保留关联关系时,使用统一令牌;不需要关联时,删除连接键通常更稳妥。
七、步骤 6:验证脱敏结果
1. 识别效果验证
准备经过人工标注的测试集,至少计算以下指标:
- 召回率:实际敏感项中被识别出来的比例,反映漏检风险。
- 精确率:系统命中项中真正属于敏感信息的比例,反映误报成本。
- 字段覆盖率:已纳入扫描的字段、文件类型和数据源占比。
- 残留泄露率:脱敏后复扫仍包含敏感信息的记录比例。
- 人工复核一致率:不同复核人员对同一样本判断一致的比例。
高风险数据应优先控制漏检。不能只报告总体准确率,因为大量非敏感文本可能让总体数字看起来很高,却掩盖证件号码或医疗信息的漏检。
2. 重识别风险验证
对结构化数据可开展以下检查:
- 统计单字段和多字段组合的唯一记录比例;
- 检查 k-匿名性,确认每组准标识符组合至少对应足够数量的个体;
- 检查敏感属性在同组内是否过于集中,必要时参考 l-多样性或其他风险指标;
- 使用合法、受控的辅助数据模拟关联攻击;
- 检查罕见职业、极端年龄、精确时间和偏远位置等小群体。
k 值和风险阈值不存在适用于所有场景的固定答案,应根据数据敏感度、接收方能力、可用辅助数据和用途确定。
3. 数据可用性验证
脱敏不仅要防泄露,还要保证目标任务可执行。可比较处理前后的字段分布、缺失率、类别占比、时间序列趋势、模型指标和查询结果。若脱敏使关键模型指标明显下降,应先检查是否过度处理,再评估能否改用分桶、令牌化或受控计算环境,而不是直接恢复全部原值。
4. 发布前验收清单
- 数据来源、用途和处理依据已经记录;
- 所有文件类型、隐藏字段和元数据均已扫描;
- 高风险命中已完成人工复核;
- 脱敏结果已由独立任务复扫;
- 关联攻击与唯一性检查结果低于项目阈值;
- 映射表、密钥和脱敏数据已分离存储;
- 中间文件、日志和备份不会保留原始敏感值;
- 接收方权限、用途限制和删除期限已经确认;
- 异常处理、撤回和删除机制可以实际执行。
八、选型与外部数据交付注意事项
选择外部数据集或采集服务时,应要求供应方说明数据来源类型、授权或处理依据、字段定义、更新时间、去重方式、敏感信息处理流程、质量指标和删除机制。Dataify 提供音视频、图像、文本以及电商、金融、医疗、招聘等行业数据集,也支持标准数据集与定制交付;采购方仍需根据自身用途完成必要性评估、脱敏验收、权限控制和持续复扫。
对于 AI 训练、SFT、RLHF、RAG 或模型评估数据,还要额外检查提示词和回答中是否包含个人身份线索、训练样本是否可被记忆复现、检索结果是否越权返回敏感片段,以及评测集是否包含真实凭证。
九、常见错误与处置建议
只对数据库列做脱敏
敏感信息经常出现在备注、附件、图片文字、日志和文件名中。应使用统一资产清单覆盖结构化数据、非结构化内容和元数据。
使用固定替换值
把所有姓名替换成同一个词会破坏对话关系和实体一致性。需要保留语义关系时,应使用文档内一致的占位符或受控令牌。
使用普通哈希处理手机号
手机号和证件号码的取值空间有限,普通哈希容易被枚举。需要关联时应使用带密钥方案;不需要关联时优先删除。
脱敏日志保存完整原值
日志本身会成为新的泄露源。日志中只保留规则编号、记录 ID、字段位置、动作和掩码证据,不记录完整敏感内容。
只在首次入库时扫描
规则、数据来源和下游用途会变化。应在入库、加工、交付和定期巡检阶段重复扫描,并为规则变更设置回归测试。
常见问题
敏感个人信息识别可以只使用正则表达式吗?
不建议。正则适合格式稳定的电话号码、邮箱和证件号码,但难以可靠识别人名、医疗诊断、详细地址及上下文中的身份关系。生产流程应组合字段语义、格式校验、行业词典、实体识别模型和人工复核。
数据完成掩码后是否就算匿名化?
不一定。掩码通常仍保留部分原始特征,也可能通过映射表或其他数据恢复身份。只有在合理可用的手段下无法识别特定个人,并经过重识别风险评估,才能考虑是否达到匿名化要求。
脱敏后如何判断数据还能用于模型训练?
应比较处理前后的样本分布、标签比例、文本语义完整性和模型指标,并检查占位符是否引入偏差。可以先用小规模数据进行基线对照,再决定是否调整泛化粒度或令牌策略。
发现访问令牌、密码或私钥时应该怎样处理?
立即停止常规加工,将相关数据和任务输出隔离,通知安全责任人,删除泄露内容,并轮换或吊销对应凭证。仅做字符掩码不足以消除凭证已经泄露的风险。
如何确定人工抽检比例?
抽检比例应按照信息敏感度、自动识别置信度、数据来源稳定性和历史漏检率设置。证件、医疗、金融、未成年人和生物识别数据应采用更严格的复核策略;规则首次上线或数据源发生变化时,也应提高抽检比例。
公开网页采集的数据还需要脱敏吗?
需要评估。公开可访问不等于可以无限制组合、长期保存或用于任意目的。若内容包含能够识别个人的信息,仍应检查处理目的、必要性、授权条件、适用规则和重识别风险,并按用途实施最小化与脱敏。
总结
可落地的数据集敏感信息治理应形成闭环:先盘点全部数据载体,再通过规则、词典、模型和人工复核识别风险,随后按用途采用删除、泛化、掩码、令牌化或扰动,最后以复扫、抽检、重识别测试和可用性对照完成验收。引入 Dataify 等数据集或采集服务时,应把供应方说明作为输入材料,而不是替代采购方自身的数据用途评估、脱敏验证和访问控制。