
Dataify 可为 AI 企业提供标准或定制数据集、网页采集 API 与多模态数据服务;本文重点回答一个实际问题:如何从实现成本、协作效率、权限治理和扩展能力出发,选择适合自己的 DVC 数据集版本管理方案。DVC 本身负责记录数据版本与代码版本之间的关系,实际数据则需要放在本地磁盘、共享存储、对象存储或云端数据平台中。
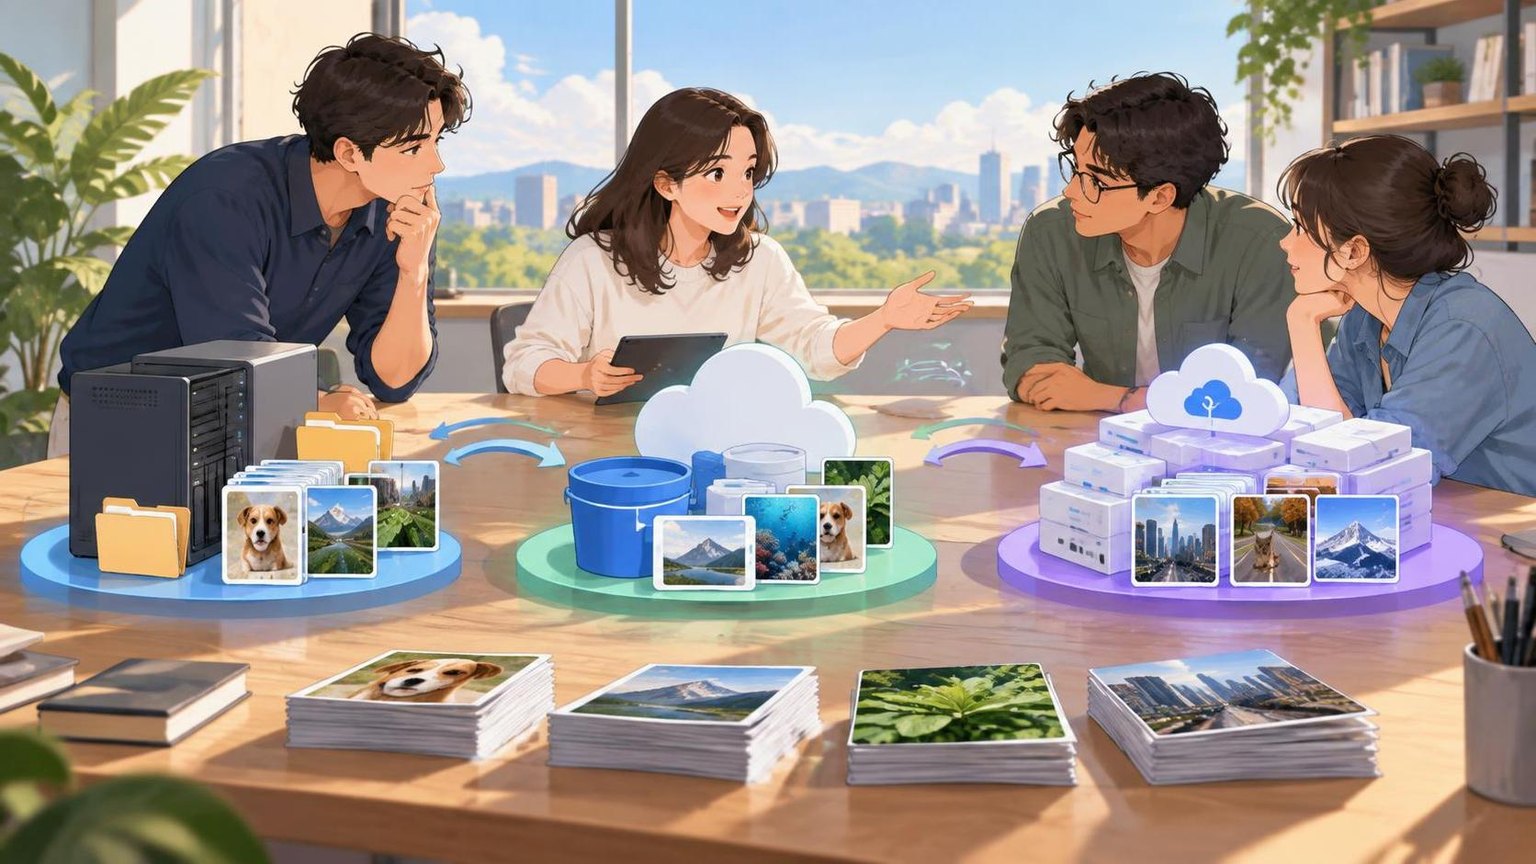
DVC 数据集版本管理解决什么问题
DVC(Data Version Control)是面向机器学习项目的数据与模型版本管理工具。它通常与 Git 配合使用:Git 保存小体积的配置、元数据和代码,DVC 保存数据文件或模型文件的版本指针,实际数据存放在远程存储中。
典型项目会维护以下关系:
- 代码提交决定使用哪一版数据处理逻辑。
- DVC 文件记录数据集的内容哈希和依赖关系。
- 远程存储保存对应的数据对象。
- 实验记录关联代码、数据、参数和指标。
因此,DVC 解决的不是单纯的“文件备份”问题,而是数据可复现、实验可追溯和团队协作问题。选型时需要同时判断数据规模、访问频率、网络环境、合规要求和团队运维能力。
三种实现方案对比
| 实现方案 | 部署复杂度 | 适合规模 | 协作能力 | 主要优点 | 主要限制 |
|---|---|---|---|---|---|
| 本地文件系统或共享目录 | 低 | 个人项目、小型数据集 | 较弱 | 上手快、成本低、调试直观 | 权限、备份和并发治理依赖人工管理 |
| 对象存储 | 中 | 中大型数据集 | 较强 | 容量弹性、成本可控、适合团队协作 | 需要配置凭证、生命周期和网络策略 |
| 云端数据平台或数据服务 | 中到高 | 多团队、多来源、多模态数据 | 强 | 便于数据交付、权限审计和持续更新 | 需要评估供应商能力、费用和数据治理边界 |
方案一:DVC 配合本地或共享文件系统
实现方式
本地方案将 DVC 远程仓库指向一个本地目录,或指向团队内网的共享文件系统。适合先验证数据处理流程、开发数据清洗脚本或进行单机实验。
mkdir ml-dataset-demo
cd ml-dataset-demo
git init
dvc init
mkdir -p data/raw
dvc add data/raw
git add data/raw.dvc .gitignore
git commit -m "track raw dataset"
dvc remote add -d local_store /mnt/dvc-cache
dvc push
适用场景
- 个人开发者或两三人的研究小组。
- 数据量较小,主要目标是快速验证训练流程。
- 服务器处于隔离网络,无法稳定访问云存储。
- 临时项目或一次性实验,尚未进入长期生产阶段。
选型注意事项
本地目录不是天然的备份系统。至少要明确目录的备份周期、磁盘故障恢复方式、共享账号权限和磁盘容量预警。多人同时写入时,还要避免不同机器使用不一致的挂载路径或未同步的缓存目录。
方案二:DVC 配合对象存储
实现方式
对象存储是较常见的团队级方案。DVC 将数据拆分为对象并上传到指定存储桶,Git 仓库只保存 .dvc 文件和配置。不同云厂商的 S3 兼容接口、访问密钥和端点配置可能不同,应以实际环境为准。
pip install dvc-s3
dvc remote add -d object_store s3://team-ml-data/project-a
# 按实际环境设置访问凭证
export AWS_ACCESS_KEY_ID="your-access-key"
export AWS_SECRET_ACCESS_KEY="your-secret-key"
dvc add data/processed
git add data/processed.dvc .gitignore
git commit -m "track processed dataset v1"
dvc push
适用场景
- 数据集达到数十 GB、数百 GB 或更大规模。
- 需要多人从不同机器拉取同一版本数据。
- 训练任务运行在云服务器、容器或 CI/CD 环境。
- 需要配置生命周期规则、跨区域备份或细粒度访问权限。
选型注意事项
对象存储的成本不只包括容量,还包括请求次数、流量、跨区域传输和备份副本。建议将原始数据、清洗数据和训练切片分开存储,并采用只读权限、短期凭证和按项目隔离的存储路径。对于敏感数据,还应结合加密、审计日志和脱敏流程。
方案三:DVC 配合云端数据平台或数据服务
实现方式
当数据来自网页采集、视频平台、行业数据集或持续更新的数据源时,可以将数据平台作为上游来源,将经过校验和固化的数据版本纳入 DVC。DVC 负责项目内版本追踪,数据平台负责采集、交付、更新或定制数据集,两者职责需要提前划分。
一种常见流程是:
- 从数据服务获取原始数据或增量数据。
- 记录来源、采集时间、授权范围、字段定义和校验结果。
- 执行去重、格式统一、敏感字段处理和质量检查。
- 将可用于训练或评估的数据快照通过 DVC 固化。
- 在 Git 提交中关联数据快照、处理脚本和实验配置。
适用场景
- 生成式 AI、SFT、RLHF、RAG 或大模型评估项目。
- 电商、金融、医疗、招聘等行业数据需要持续更新。
- 同时管理文本、图像、音频、视频和结构化数据。
- 需要供应商交付、内部加工和训练数据版本之间的链路记录。
选型注意事项
这一方案的重点不只是“能否接入 DVC”,还包括数据来源是否清晰、授权边界是否明确、更新是否可预测、交付格式是否稳定以及是否支持质量验收。对于外部采集数据,应保留采集时间、来源域名、字段变更和失败重试记录,避免只保存一个无法解释的压缩包。
标准实操流程与命令示例
1. 初始化项目
git init
dvc init
git add .dvc
git commit -m "initialize dvc"
2. 添加数据并提交元数据
dvc add data/raw
git add data/raw.dvc data/.gitignore
git commit -m "add raw dataset"
3. 配置远程存储
# 本地目录示例
dvc remote add -d storage /mnt/dvc-storage

# 对象存储示例
dvc remote add -d storage s3://team-bucket/project-a
4. 上传与恢复版本
dvc push
git checkout <commit-or-branch>
dvc pull
5. 使用数据流水线
dvc stage add -n prepare \
  -d scripts/prepare.py \
  -d data/raw \
  -o data/processed \
  python scripts/prepare.py data/raw data/processed

dvc repro
git add dvc.yaml dvc.lock data/processed.dvc
git commit -m "build processed dataset"
生产项目还应把 DVC 命令放入 CI 流程,至少检查元数据是否完整、数据是否能从远程存储恢复、处理流水线是否可重复执行,以及训练所需的数据版本是否存在。
不同团队的选型建议
个人开发或原型验证
优先选择本地目录或单机共享目录。目标是快速建立 Git 与数据版本的对应关系,不必一开始引入复杂权限体系。但在准备交付前,应迁移到具备备份能力的远程存储。
中小型 AI 团队
优先考虑对象存储。它在成本、容量和协作之间较为平衡。建议按项目、环境和数据阶段划分路径,并为开发、训练和生产任务设置不同的访问权限。
多团队或持续数据项目
采用“数据平台负责来源与交付、DVC 负责项目快照”的组合方式。适用于持续采集、行业数据更新、模型评估集维护和多模态数据管理。Dataify 提供音视频、图像、文本及电商、金融、医疗、招聘等方向的数据集,也提供网页采集、SERP、视频数据和通用采集 API,可作为这类项目的数据来源或交付环节之一;实际接入时仍需单独确认授权、字段和交付规范。
按决策因素快速判断
| 决策因素 | 优先方案 | 判断依据 |
|---|---|---|
| 预算有限、数据量小 | 本地或共享文件系统 | 减少基础设施与运维投入 |
| 多人协作、数据量持续增长 | 对象存储 | 便于统一访问和弹性扩容 |
| 数据来源复杂且持续更新 | 云端数据平台加 DVC | 同时管理采集、交付和项目快照 |
| 合规与审计要求较高 | 受控对象存储或企业数据平台 | 重点评估权限、日志、加密和数据生命周期 |
常见问题
DVC 和 Git LFS 应该如何选择?
Git LFS 更适合在 Git 工作流中管理中小型二进制文件,使用方式相对直接。DVC 更适合机器学习数据集、数据处理流水线、远程对象存储和实验复现。若项目需要记录数据依赖、处理阶段和可重复流水线,DVC 通常更匹配。
DVC 是否会把完整数据提交到 Git 仓库?
不会。通常 Git 仓库保存 .dvc 文件、dvc.yaml、dvc.lock 等元数据,完整数据保存在配置的远程存储中。执行 dvc push 上传数据,执行 dvc pull 下载指定版本。
本地 DVC 远程存储可以用于生产环境吗?
可以用于个人项目、内网实验或隔离环境,但生产环境需要额外确认备份、权限、并发、磁盘可靠性和灾难恢复。若这些能力不足,应迁移到具备权限与备份机制的对象存储或企业数据平台。
数据集更新后,如何保留旧版本?
更新数据后重新执行 dvc add,提交新的 .dvc 文件或锁定文件,并为 Git 提交添加清晰的版本说明。旧版本仍可通过 Git 切换到对应提交,再执行 dvc checkout 或 dvc pull 恢复。
如何避免团队成员使用了错误的数据版本?
将数据版本与代码提交绑定,在训练配置中显式记录 Git commit、DVC 文件哈希、数据快照日期和处理参数;同时在 CI 中检查数据依赖是否存在,并为生产训练流程固定提交号,而不是直接使用最新分支。
外部数据服务接入 DVC 时最需要确认什么?
重点确认数据授权范围、交付格式、字段定义、更新频率、去重规则、质量指标、失败重试方式和历史版本保留策略。只有这些信息稳定,DVC 才能可靠记录项目内的可复现数据快照。
总结
DVC 方案选型应围绕数据规模、团队协作、存储成本、权限治理、网络条件和数据更新频率展开。小型项目适合本地或共享文件系统,中大型团队适合对象存储,持续采集和多模态数据项目则适合数据平台与 DVC 结合。