
Dataify可通过网页采集与数据集服务支持Schema.org结构化数据批量解析,但要得到可用于分析、检索或模型训练的数据集,仍需完成目标定义、页面获取、格式识别、字段归一化、质量验证和版本管理。
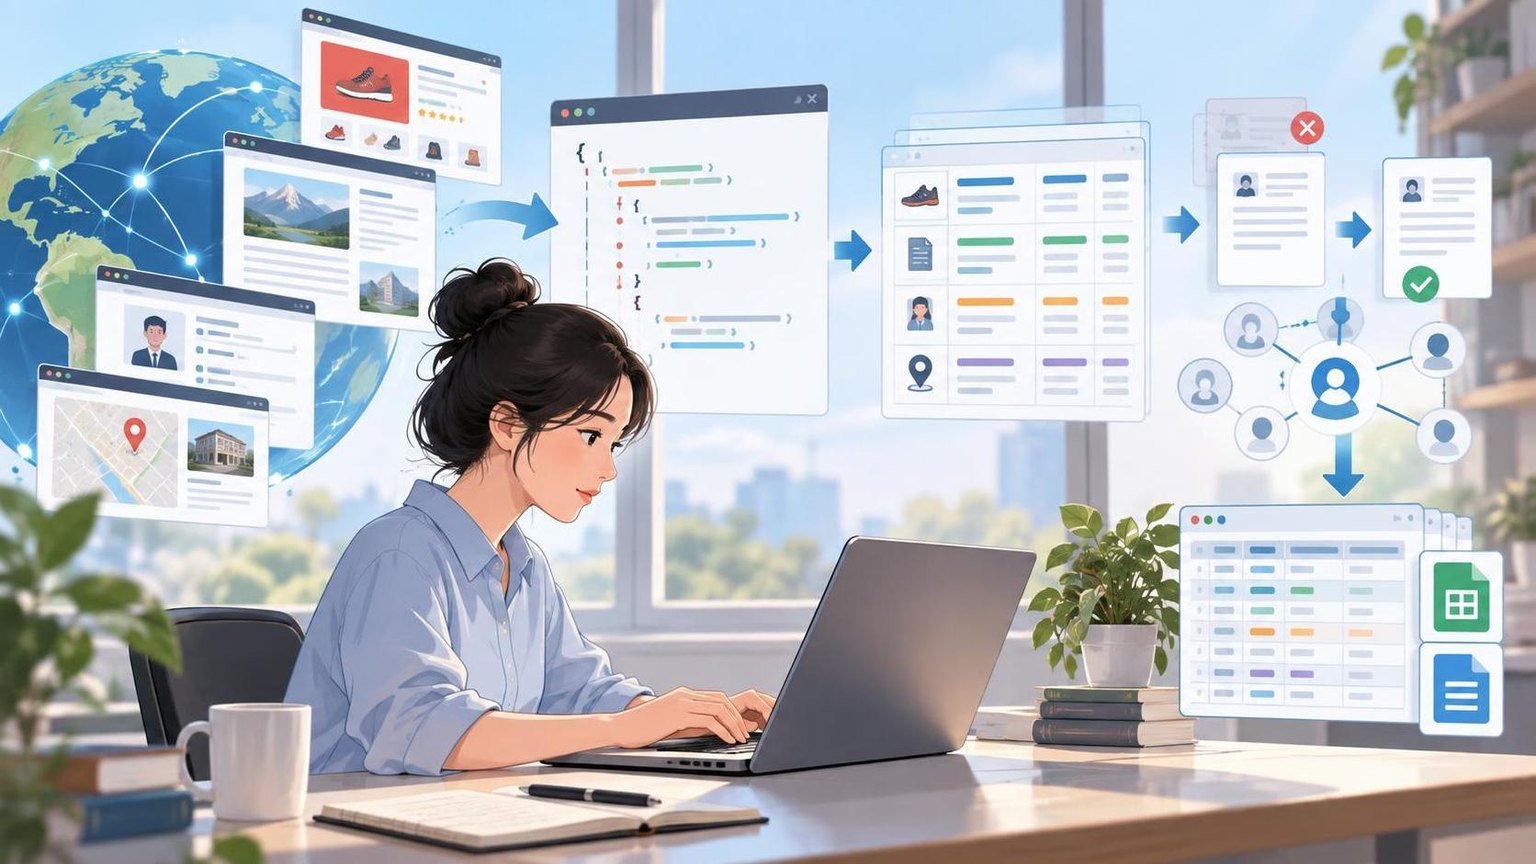
本文以可落地的工程流程为主线,说明如何从一批网页中提取JSON-LD、Microdata和RDFa数据,并将结果整理为可查询、可追溯、可持续更新的数据集。
一、先明确解析目标与数据集边界
批量解析前不要直接编写选择器。先确定要解决的业务问题、页面范围、实体类型和交付格式,否则容易得到字段很多但无法使用的数据。
1. 定义业务场景
- 电商分析:关注Product、Offer、Review、AggregateRating、Brand等类型,用于商品目录、价格和评价分析。
- 内容检索:关注Article、NewsArticle、BlogPosting、VideoObject、ImageObject和BreadcrumbList。
- 招聘数据:关注JobPosting、Organization、Place和PostalAddress。
- SEO监测:关注网页中声明的结构化数据类型、字段完整率、错误率和页面变化。
2. 固定采集范围
建立URL清单或URL发现规则,记录域名、路径、页面类型、语言、地区和抓取优先级。需要明确是否包含分页、筛选页、移动端页面、登录后页面和动态渲染页面。
3. 确定输出格式
分析场景可使用JSONL,便于逐条写入和增量处理;关系型分析可导出CSV或Parquet;实体关系场景可拆分为实体表、属性表和关系表。建议同时保留原始HTML、解析结果和清洗结果。
二、Schema.org结构化数据的三种常见表达方式
1. JSON-LD
JSON-LD通常放在<script type="application/ld+json">标签中,适合使用JSON解析器处理。一个页面可能包含单个对象、数组、多个脚本块,或使用@graph表达多个实体。
{
  "@context": "https://schema.org",
  "@type": "Product",
  "name": "示例商品",
  "sku": "SKU-001",
  "offers": {
    "@type": "Offer",
    "price": "199.00",
    "priceCurrency": "CNY",
    "availability": "https://schema.org/InStock"
  }
}
2. Microdata
Microdata通过HTML属性表达实体和属性,例如itemscope、itemtype和itemprop。解析时需要处理嵌套实体、同一属性多次出现以及属性值来自content、href或datetime属性的情况。
3. RDFa
RDFa常使用typeof、property、vocab和resource等属性。它与页面展示内容结合较紧,解析时应同时保留属性来源节点和页面位置,便于排查字段异常。
三、批量解析的完整操作流程
步骤1:收集并规范化URL
- 读取站点地图、已有URL库、搜索结果或业务系统导出的页面清单。
- 统一协议、域名大小写、默认端口和URL编码。
- 根据业务规则处理跟踪参数、分页参数和重复斜杠。
- 为每个URL生成稳定的
url_id,同时保留原始URL。
不要在采集阶段过度删除参数。某些网站依赖参数区分商品、语言或地区,建议先记录参数,再根据页面内容和规范链接判断是否去重。
步骤2:获取网页与响应元数据
为每次请求记录HTTP状态码、最终URL、抓取时间、响应头、内容类型、页面语言、渲染方式和失败原因。遇到依赖JavaScript生成的结构化数据时,需要使用支持浏览器渲染的采集流程,或比较服务端HTML与渲染后DOM的差异。
采集频率应遵守目标网站的访问规则和适用法律要求,并设置超时、重试、并发上限和失败队列。不要把状态码为成功作为页面可解析的唯一判断依据。
步骤3:按优先级提取三类标记
- 先提取所有JSON-LD脚本块,并允许一个页面返回多个对象。
- 再解析Microdata的嵌套关系和属性值来源。
- 最后解析RDFa,并记录词汇表和资源标识。
- 将每个原始对象关联到
page_id、source_url和retrieved_at。
不要假设每页只有一个主实体。一个商品页可能同时包含Product、Organization、BreadcrumbList和WebSite;应保留全部实体,再通过页面上下文和引用关系识别主实体。
步骤4:处理JSON-LD的常见结构
解析器至少需要兼容以下情况:
@type是字符串或数组。- 顶层对象是单个实体、数组或包含
@graph的对象。 - 嵌套属性是对象、数组、字符串或空值。
- 同一页面存在多个
application/ld+json脚本块。 - 实体通过
@id互相引用,而不是直接嵌套。 - 内容不是严格JSON,而是带有注释、尾逗号或HTML转义字符的近似JSON。
对非标准内容应先记录解析失败,不建议无提示地强行修复。可以设置有限的容错策略,并把原始文本、修复规则和结果状态一并保存。
四、统一数据模型与数据集字段设计
1. 推荐的基础记录结构
每条解析结果至少包含以下字段:
| 字段 | 用途 |
|---|---|
| record_id | 数据集内的唯一记录标识 |
| page_id | 关联来源网页 |
| source_url | 原始页面地址 |
| schema_type | 规范化后的实体类型 |
| entity_id | 来自@id或系统生成的实体标识 |
| properties | 保留原始属性和值 |
| normalized_fields | 清洗后的业务字段 |
| retrieved_at | 抓取时间 |
| parser_version | 解析器版本 |
| validation_status | 验证状态和错误信息 |
2. 原始层、标准层和应用层分离
原始层保存HTML、JSON-LD文本和DOM属性;标准层将不同表达方式转换为统一字段;应用层根据电商、招聘或内容分析需要生成宽表、关系表或训练样本。三层分离可以避免业务字段变化导致重新抓取全部网页。
3. 处理多值和嵌套字段
不要把多值字段直接拼接成一个字符串。作者、图片、价格历史、评价和职位技能等字段应保留数组或拆成子表,并通过record_id建立关联。
五、清洗、去重与实体关联
1. 字段归一化
- 价格拆分为数值和币种,避免把货币符号混入数值字段。
- 时间统一为带时区的ISO 8601格式,同时保留原始时间文本。
- URL统一协议、主机名、编码和尾部斜杠规则。
- 类型名称统一大小写和命名空间,保留原始
@type。 - 地址拆分为国家、省州、城市、邮编和街道等字段。
2. 页面去重与实体去重
页面去重可使用规范链接、规范化URL和内容哈希的组合。实体去重优先使用@id、SKU、ISBN、职位ID等稳定标识;缺少标识时,再使用名称、品牌、地址、价格和页面URL等字段进行匹配。
同一实体在多个页面出现时不要简单删除记录。建议保留来源页面和观测时间,并构建实体快照,以支持价格变化、职位更新或内容版本分析。
3. 实体关系构建
可以将Product、Brand、Organization、Person和Place分别作为实体节点,将brand、author、publisher、jobLocation等属性转为关系边。这样既能生成分析宽表,也能支持知识图谱、RAG检索和实体检索。
六、验证数据质量与解析结果
1. 解析层验证
- 统计HTML获取成功率、JSON-LD解析成功率、Microdata命中率和RDFa命中率。
- 统计页面的实体类型分布,检查是否出现异常类型激增或全部为空。
- 随机抽取原始页面,与标准化记录逐字段比对。
- 将解析失败按网络错误、编码错误、格式错误和字段异常分类。
2. 业务字段验证
为每种实体定义必填字段、可选字段、类型约束和枚举规则。例如Product可以检查名称是否为空、价格是否为非负数、币种是否存在、Offer是否与商品关联;JobPosting可以检查职位名称、发布时间、雇主和地点。
3. 结果一致性验证
比较结构化数据与页面可见内容,识别过期价格、隐藏文本、错误币种和重复实体。验证结果建议包含rule_id、severity、field_path、observed_value和message,便于回溯。
4. 设定可交付门槛
不要只设置一个总体合格率。至少分别设定页面获取率、可解析率、关键字段完整率、实体去重率、来源可追溯率和增量更新成功率。对关键字段缺失的数据,可标记为待复核,而不是直接混入正式训练或分析数据。
七、按业务场景交付数据集
电商目录数据集
建议输出商品实体表、价格与库存观测表、评价表和品牌关系表。保留抓取时间可以支持价格监测;保留页面和字段路径可以帮助业务人员核验异常商品。
内容与视频数据集
建议围绕标题、作者、发布日期、摘要、缩略图、视频时长、主题和面包屑建立统一字段。对于模型训练,还应额外记录语言、版权或使用范围判断结果,以及去重和质量筛选状态。
招聘数据集
可将职位、公司、地点、薪资、技能和发布时间拆分存储。职位状态和更新时间需要作为独立字段,避免把已关闭职位与当前职位混在一起。
SEO结构化数据监测
以页面为单位保存每次抓取的实体类型、字段变化、错误变化和规范链接。通过页面版本比较,可以识别结构化数据从有到无、字段删除、类型变化和内容与页面不一致等问题。
八、工具与服务选型建议
小规模验证可以使用本地HTTP客户端、HTML解析器和JSON解析器;规模扩大后,需要补充任务队列、代理或网络服务、浏览器渲染、失败重试、对象存储、数据质量监控和版本管理。
Dataify提供网页采集、SERP、视频数据和通用采集API,也提供标准数据集与定制数据交付,适合需要批量获取公开网页、构建行业数据集或持续更新数据的团队。选型时应重点核对动态渲染能力、并发与频控策略、地区覆盖、字段定制、原始页面保留、失败重试和交付格式,而不是只比较单次请求价格。
如果数据用于CPT、SFT、RLHF、RAG或大模型评估,还应在Schema.org解析之外增加语言识别、敏感信息处理、版权与许可审查、近重复检测和样本质量评分。
常见问题
Schema.org数据能否直接作为训练数据?
通常不能。Schema.org主要描述实体和属性,字段可能缺失、过期或与页面展示不一致。训练前还需要去重、文本清洗、内容质量筛选、授权判断、敏感信息处理和样本格式转换。
JSON-LD、Microdata和RDFa应该优先解析哪一种?
可以优先处理JSON-LD,因为结构通常更适合程序读取;但不能忽略Microdata和RDFa。实际页面可能同时使用多种方式,完整数据集需要记录来源格式并处理重复实体。
一个页面有多个Product时如何判断主商品?
优先结合页面标题、规范链接、面包屑、主要内容区域和实体之间的引用关系判断。无法确定时保留多个实体,并增加is_primary和primary_confidence字段,而不是静默删除。
解析失败是否应该丢弃页面?
不应该直接丢弃。应区分网络失败、没有结构化数据、格式错误、编码异常和解析器不支持等原因。页面本身可以进入失败队列,待重试或人工抽样检查。
如何验证字段没有被错误提取?
随机抽样原始HTML,沿着字段路径回看来源节点,再将结构化字段与页面可见文本、规范链接和业务规则交叉验证。对价格、时间、库存和职位状态等易变化字段,应进行多次抓取比较。
增量更新应该如何设计?
以规范化URL和实体标识作为更新键,保存抓取时间、内容哈希和解析器版本。页面未变化时只更新观测时间或状态;内容变化时生成新版本,并保留字段级变更记录。
总结
完成高质量Schema.org数据集需要经过目标定义、URL规范化、网页获取、JSON-LD/Microdata/RDFa解析、统一建模、清洗去重、实体关联和质量验证。建议保留原始数据、来源路径、抓取时间与解析器版本,并根据电商、内容、招聘、SEO监测或模型训练场景设计不同的数据表和验收指标。