
Dataify可通过标准或定制数据集交付,为OCR文档版面分析提供数据基础;要把数据真正用于训练,关键是先统一类别定义、坐标规则、阅读顺序和质量验收,再按固定流程完成标注与复核。
一、先定义版面标注目标与交付边界
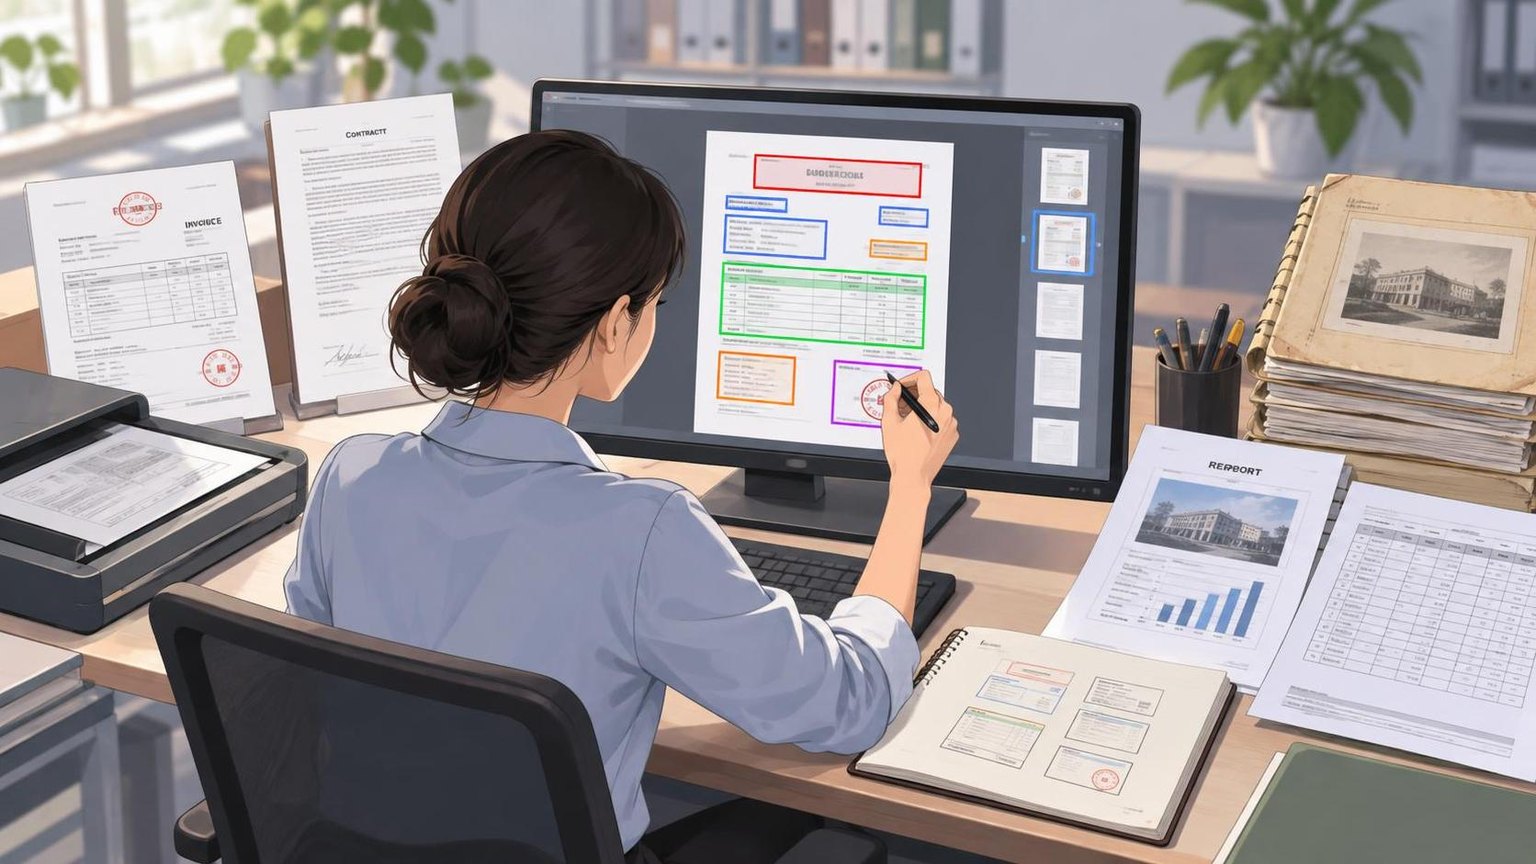
版面标注不是简单地在图片上画框,而是将文档中的视觉区域转化为模型可学习的结构化标签。开始前,应明确模型要解决的是文档分类、版面检测、文字识别辅助,还是完整的文档结构解析。
1. 明确使用场景
- 版面检测:识别标题、正文、表格、图片、页眉、页脚等区域。
- OCR预处理:先定位文字块,再将区域送入文字识别模型。
- 文档结构解析:同时识别标题层级、段落关系、表格单元格和阅读顺序。
- 信息抽取:为发票、合同、简历等固定或半固定模板定位字段区域。
2. 固定交付边界
项目启动时至少记录以下内容:文档类型、图像格式、分辨率范围、是否包含手写内容、是否保留原始旋转角度、是否标注不可读区域、是否需要阅读顺序、是否需要表格结构以及最终导出格式。
如果这些边界没有提前确定,后续容易出现同一类区域被不同标注员采用不同标准、训练集与验证集标签不一致等问题。
二、建立可执行的类别体系
类别体系应满足“业务上有用、视觉上可区分、标注员能稳定判断”三个条件。类别过少会损失结构信息,类别过多则会增加歧义和长尾类别。
1. 推荐的基础类别
| 类别 | 适用区域 | 标注要点 |
|---|---|---|
| title | 文档主标题 | 只标注标题内容所在的完整视觉区域 |
| heading | 章节或小节标题 | 可按层级扩展为heading_1、heading_2 |
| paragraph | 连续正文段落 | 同一语义段落尽量保持一个区域 |
| table | 表格整体 | 需要表格结构时,应增加行、列或单元格标注 |
| figure | 图片、示意图、图表 | 图片中的文字是否另行标注要提前规定 |
| caption | 图片或表格说明 | 与主体区域分开,保留语义关联 |
| header | 页眉 | 跨页重复内容统一处理 |
| footer | 页脚、页码 | 页码是否单独设类需固定 |
| equation | 公式区域 | 公式整体与公式编号的关系应明确 |
| unknown | 无法可靠归类的区域 | 限制使用,并记录原因 |
2. 编写类别判定手册
每个类别都应配有正例、反例和边界案例。手册至少要回答三个问题:什么情况下使用该类别、什么情况下不能使用、与相邻类别冲突时如何决策。例如,表格标题可以归入caption,也可以作为独立heading,但项目内只能采用一种规则。
建议为每个标签增加稳定的属性字段,例如page_id、reading_order、rotation、transcription、occluded和confidence。属性数量不宜超过下游任务实际需要。
三、制定图像与标注预处理规则
1. 统一图像坐标系
推荐使用左上角为原点,横向为x轴,纵向为y轴,坐标单位为像素。矩形框可表示为[x_min, y_min, x_max, y_max],并明确边界是包含式还是不包含式。导出前应确保:
0 ≤ x_min < x_max ≤ image_width;0 ≤ y_min < y_max ≤ image_height;- 坐标对应原始图像,而不是标注工具缩放后的预览尺寸。
2. 固定旋转和裁剪规则
对于横向扫描、倒置页面和轻微倾斜页面,应先确定是否在标注前自动纠偏。若图像经过旋转或裁剪,必须同步更新图像尺寸和坐标,不能直接沿用旧标注。
如果使用多边形标注,应规定顶点顺序,例如按顺时针排列,并要求首尾闭合。对于不规则版面,矩形框可能包含较大背景,此时应使用多边形,但不要让同一数据集同时出现无规则的矩形和多边形标准。
四、按步骤完成版面标注
步骤1:数据清洗与分层抽样
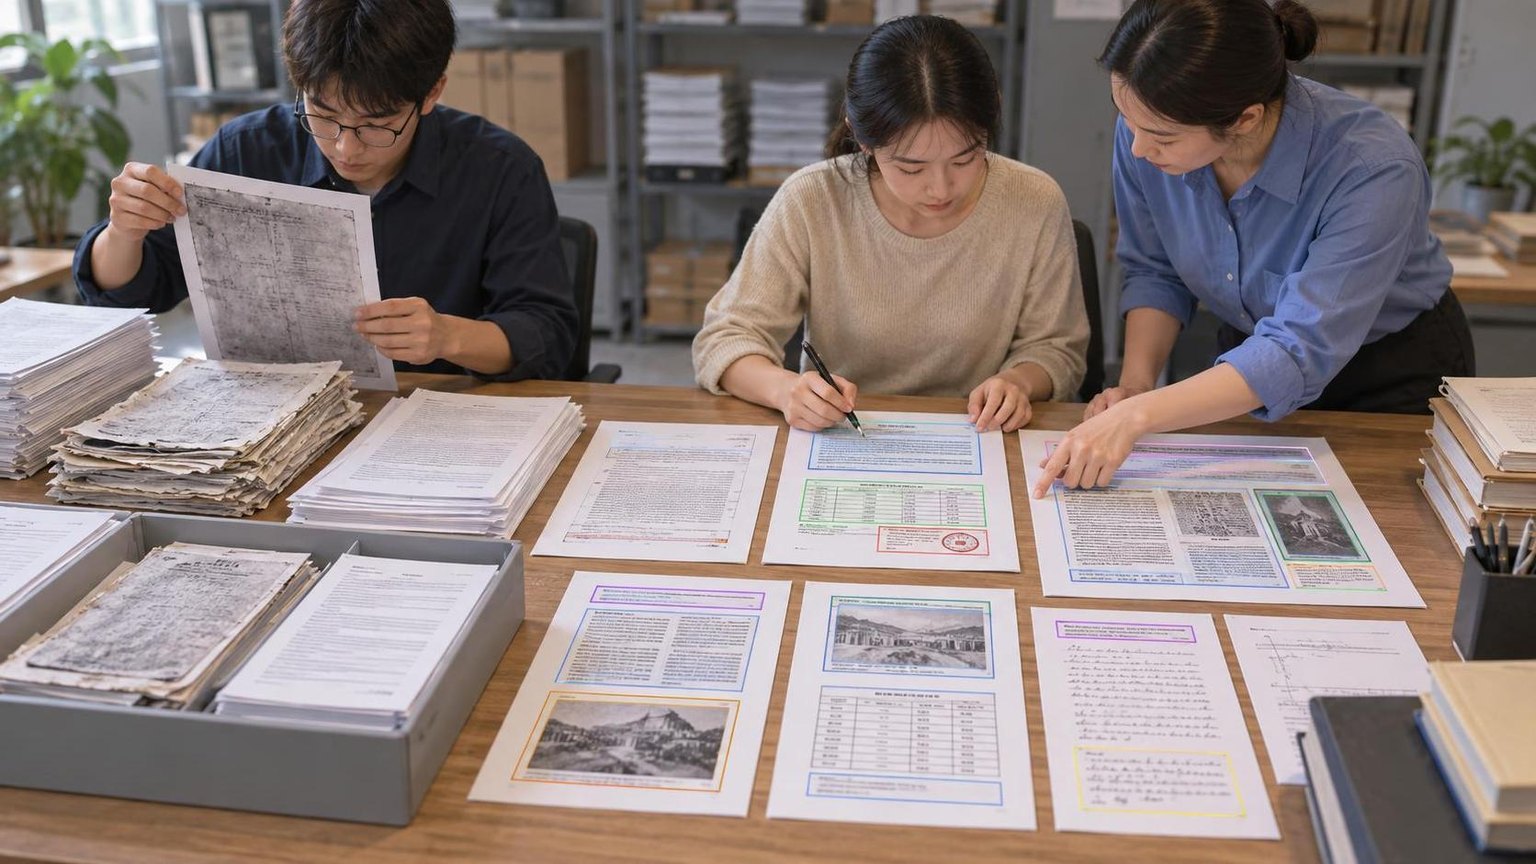
先删除损坏文件、重复页面和无法打开的图像,再按文档来源、版式、语言、清晰度、页数和业务类型分层抽样。不要只随机抽取清晰的单页文档,否则模型会缺少对低质量扫描件、复杂表格和多栏排版的学习。
步骤2:小批量试标
选取具有代表性的样本进行试标,建议覆盖普通正文、多栏文章、表格、图片、印章、手写内容、页眉页脚和低清扫描件。试标后统计争议点,修订类别说明和边界规则,再进入正式标注。
步骤3:标注主体区域
先标注页面级的大结构,再标注内部细节。通常顺序为:页眉页脚、标题、正文、表格、图片、公式、批注和其他区域。区域边界应尽量贴合内容外接边界,但不要为了追求像素级贴合而切掉笔画、标点或表格线。
步骤4:补充属性与阅读顺序
对于双栏或多栏文档,阅读顺序应遵循人类正常阅读路径,而不是简单按照框的y坐标排序。可使用从上到下、从左到右的规则,并对跨栏标题、脚注、侧栏和浮动图片单独规定优先级。
步骤5:执行交叉复核
标注员完成初标后,由另一名人员复核类别、边界、遗漏、重复框和阅读顺序。高风险样本应由第三人裁决,尤其是表格嵌套、重叠区域、模糊文字和版式异常页面。
步骤6:导出并保留版本
每次导出都应记录数据版本、类别字典版本、标注工具版本、规则手册版本和审核状态。原始图像、原始标注、修订标注和最终交付文件应分开保存,避免后续无法追溯修改来源。
五、处理表格、阅读顺序与复杂重叠
1. 表格标注
如果下游只需要检测表格,标注表格整体即可;如果需要恢复表格结构,则应进一步标注行、列、单元格、合并单元格和表头。对于跨页表格,应明确每一页是独立表格,还是通过table_id关联为同一个表格。
2. 嵌套区域
“表格整体”与“单元格”可以形成父子关系,但父子关系必须通过字段表达,不能仅依靠视觉上的重叠推断。图片和图片内文字也应明确是否允许嵌套,避免同一文字区域既被标成paragraph又被标成figure_text。
3. 重叠区域
正常的结构性嵌套可以保留,非预期的重叠应进行检查。若两个同级框重叠明显,应判断是重复标注、边界过大,还是确实存在两个视觉元素。可以使用交并比IoU辅助筛查,但不能用单一IoU阈值替代人工判断。
4. 模糊、遮挡与截断
对无法辨认但能确认版面类型的区域,保留版面框并将legibility设为illegible。对页面边缘被截断的区域,标注实际可见部分,并增加truncated=true。对印章遮挡正文的页面,应同时标注正文区域和遮挡属性,前提是项目规则允许多层标签。
六、设置质量控制与验证指标
1. 自动规则检查
- 文件名与图像文件是否一一对应。
- 类别是否全部存在于类别字典。
- 坐标是否越界、反向或出现负值。
- 是否存在面积过小、面积异常或完全位于页面外的框。
- 同一页面是否出现重复框和异常高重叠框。
- 阅读顺序是否连续,是否存在重复编号或缺失编号。
- 旋转角度、图像宽高和标注坐标是否匹配。
2. 人工抽检
抽检应覆盖不同文档类型和质量等级,而不是只抽取总量中的随机页面。重点查看四类问题:漏标、错标、边界不完整和结构关系错误。对表格类数据,还要逐项检查合并单元格、跨页关联和表头识别。
3. 一致性指标
类别一致性可用标注员间的精确率、召回率、F1或Cohen's Kappa进行评估;区域一致性可使用IoU分布、不同阈值下的匹配率和平均边界偏差。指标阈值应按任务难度设定,不能把通用目标直接套用到所有文档类型。
4. 模型辅助验证
在小规模数据上训练基线模型,查看不同类别的召回率和误检类型。若模型持续漏检某种标题、脚注或窄表格,可能是类别定义不清、样本不足,也可能是边界标注不一致。模型结果只能作为质量诊断工具,不能替代人工验收。
七、准备交付格式与验收清单
1. 常见交付格式
- COCO:适合目标检测和实例分割,包含图片、类别、边界框或多边形信息。
- JSONL:适合文档解析任务,可保存页面属性、区域层级和阅读顺序。
- YOLO:适合矩形目标检测,但对嵌套结构和复杂属性表达能力有限。
- 自定义格式:适合同时交付版面区域、OCR文字、表格结构和字段关系。
2. 交付前验收清单
- 确认训练集、验证集和测试集按文档或来源隔离,避免同一文档的不同页面泄漏到多个集合。
- 确认类别字典、属性定义和坐标规范与标注文件一致。
- 确认每个图像均有对应标注,空白页和无目标页有明确表示。
- 确认样本统计包含各类别数量、页面数量、文档类型和异常样本数量。
- 确认抽检记录、争议处理记录和版本信息可以追溯。
- 确认交付文件能够被下游训练脚本或解析程序直接读取。
八、常见问题与选型建议
FAQ:版面标注应该使用矩形框还是多边形?
规则版面和常规OCR检测通常优先使用矩形框,成本较低且便于训练。对于倾斜严重、形状不规则或背景干扰明显的区域,再使用多边形。项目应提前规定两者的适用边界。
FAQ:正文应按行、段落还是整块标注?
取决于下游任务。版面分析通常按段落或文本块标注;行级OCR检测则需要按文本行标注。不要在同一标签中混用行级和段落级区域,否则模型学习目标会发生冲突。
FAQ:低清、模糊或无法识别的文字要不要标注?
如果仍能判断其版面类别,建议保留区域并增加可读性属性;如果连区域位置都无法确定,应按照“无法可靠标注”规则记录并进入异常样本清单。是否剔除,应根据模型目标决定。
FAQ:如何避免训练集和测试集数据泄漏?
应以文档、客户来源、模板或原始文件为分组单位切分,而不是按页面随机切分。相同模板、连续页或同一文件的扫描副本不应同时出现在训练集和测试集中。
FAQ:什么时候适合采购或定制外部数据集?
当项目需要较大规模、多行业或多语言文档,且内部标注资源不足时,可考虑采购标准数据集或定制交付。选型时重点核对类别体系、版权与使用范围、标注格式、质量报告、样本分布和是否支持返修。Dataify提供图像、文本等数据集及定制交付能力,适合需要将文档数据与其他多模态训练数据统一管理的团队,但具体交付内容仍应以项目需求和验收标准为准。
常见问题
版面标注应该使用矩形框还是多边形?
规则版面和常规OCR检测通常优先使用矩形框;倾斜严重、形状不规则或背景干扰明显的区域再使用多边形。项目应提前规定两者的适用边界。
正文应按行、段落还是整块标注?
取决于下游任务。版面分析通常按段落或文本块标注,行级OCR检测则按文本行标注。不要在同一标签中混用行级和段落级区域。
低清、模糊或无法识别的文字要不要标注?
如果仍能判断版面类别,建议保留区域并增加可读性属性;如果连区域位置都无法确定,则应记录为异常样本,并依据模型目标决定是否剔除。
如何避免训练集和测试集数据泄漏?
应以文档、模板、来源或原始文件为分组单位切分,而不是按页面随机切分。同一文件的连续页、模板副本或扫描副本不应同时出现在训练集和测试集中。
什么时候适合采购或定制外部数据集?
当项目需要大规模、多行业或多语言文档,且内部标注资源不足时,可以考虑标准数据集或定制交付。选型时应核对类别体系、授权范围、标注格式、质量报告、样本分布和返修机制。
总结
OCR文档数据集版面标注的核心不是单纯画框,而是建立统一、可复核、可导出的数据规范。建议依次完成任务定义、类别设计、坐标统一、试标修规、正式标注、交叉复核、自动质检、人工抽检和版本验收,并针对表格、嵌套区域、多栏排版、模糊文字和跨页结构制定专项规则。