
Dataify 可提供标准数据集、定制数据交付以及面向网页、搜索和视频公开数据的采集 API;在此类数据进入数据湖后,Parquet 分区设计应优先围绕查询条件、数据增长方式和文件规模展开。可落地的做法是:先统计真实查询中的过滤字段,再选择低至中等基数的时间或业务字段作为分区键,通过分区裁剪减少扫描范围,同时控制分区数量、文件大小和写入并发,最后用同一组基准 SQL 对优化前后进行验证。
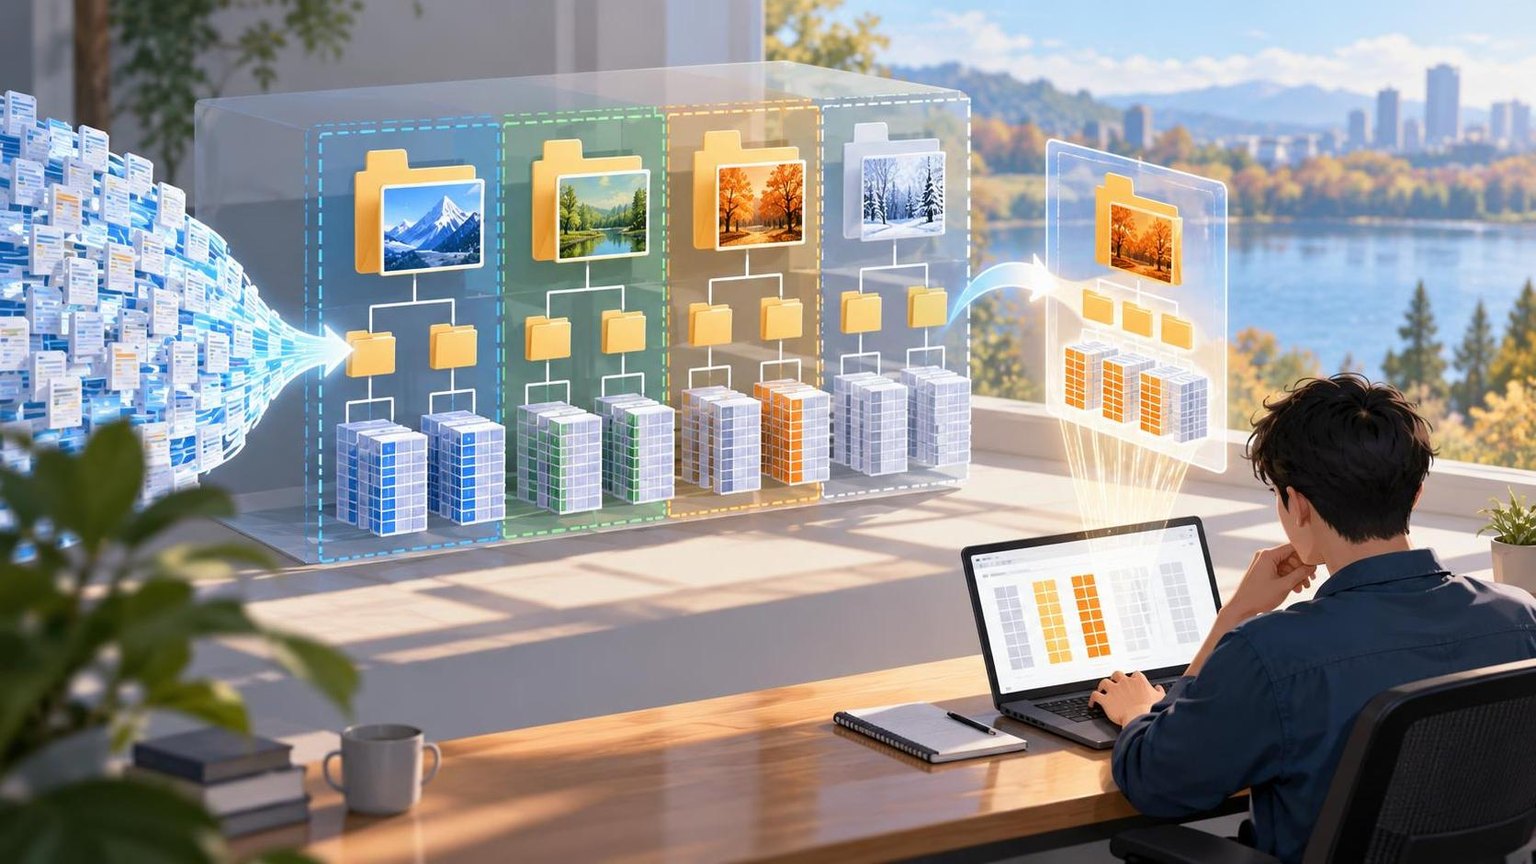
分区并不是把字段简单写进目录名,而是通过目录结构让查询引擎在读取文件前排除无关数据。设计不当会产生大量小文件、分区爆炸或热点目录,导致元数据访问和任务调度成本超过扫描收益。
先给结论:分区设计的核心原则
- 按常用过滤条件分区:优先选择查询中经常出现在 WHERE 条件里的字段。
- 控制分区基数:日期、地区、业务类型通常比用户 ID、订单 ID 更适合做目录分区。
- 先粗后细:常见起点是按天分区,只有在单日数据量过大或查询模式明确时才增加小时、区域等层级。
- 保持文件规模稳定:通过合并小文件和控制写入批次,尽量让单个 Parquet 文件达到几十 MB 到数百 MB 的可管理范围,具体数值应结合引擎与集群规模测试。
- 分区与列裁剪同时使用:分区只能减少目录范围,列式存储和谓词下推才能进一步减少文件内的读取量。
一、明确数据集访问模式与分区边界
1. 收集真实查询样本
先从历史 SQL、任务脚本或 BI 报表中提取以下信息:
- 最常出现的过滤字段,例如 event_date、region、category。
- 查询时间范围,例如最近一天、最近七天或自然月。
- 是否经常按某个维度聚合,例如按地区、商品类目或数据来源统计。
- 单次查询能够接受的延迟,以及查询并发量。
- 数据是否持续追加,还是会频繁更新和删除。
可以建立一张简单的查询画像表,将查询按调用次数、扫描数据量和业务重要性排序。不要只根据字段的高基数或业务直觉选择分区键。
2. 估算分区数量
分区数量可以先按下面的方式估算:
预计分区数 = 时间范围数量 × 其他分区字段的取值组合数
例如,按天和地区分区,保存 365 天、20 个地区,理论上就有 7300 个分区。若每天只有少量数据,这种设计可能产生过多小目录和小文件。此时可改为仅按月分区,或仅按天分区并把地区保留为普通列。
3. 选择合适的分区字段
| 字段类型 | 适合程度 | 说明 |
|---|---|---|
| 日期或月份 | 通常适合 | 查询范围明确,分区数量容易估算 |
| 地区或业务类型 | 有条件适合 | 取值稳定且查询经常过滤时有效 |
| 数据来源 | 有条件适合 | 来源数量有限、数据分布相对均衡时可用 |
| 用户 ID、订单 ID | 通常不适合 | 基数过高,容易造成分区爆炸 |
| 高频变化状态 | 谨慎使用 | 更新会导致数据重写或分区管理复杂 |
二、设计 Parquet 目录结构与分区字段
1. 使用稳定、可解析的目录规范
推荐使用 Hive 风格的目录结构,例如:
s3://bucket/dataset/events/dt=2025-01-01/region=cn/file-0001.parquet
s3://bucket/dataset/events/dt=2025-01-01/region=us/file-0002.parquet
这种结构便于 Spark、Trino、Hive、Flink 和多数数据目录工具识别分区字段。字段名称应保持稳定,日期格式应统一为 ISO 格式,避免同时出现 dt、date、event_date 等含义相近但格式不同的目录键。
2. 选择单层、双层还是多层分区
常见结构可以按以下顺序选择:
- 单层分区:
dt=2025-01-01,适合主要按时间查询的数据集。 - 双层分区:
dt=2025-01-01/region=cn,适合时间和地区都经常被过滤的场景。 - 多层分区:在时间、地区之外继续增加业务类型时,需要先确认组合数量、数据均衡性和目录维护成本。
如果第二个字段只在少数查询中使用,通常不必立即把它做成分区字段,可以保留为普通列,并依赖 Parquet 的统计信息和谓词下推。
3. 处理 NULL、异常值与新增取值
分区字段必须定义缺失值策略。例如将空地区统一写为 region=__HIVE_DEFAULT_PARTITION__ 或项目内部约定的 region=unknown,并在数据字典中固定下来。不要让同一含义同时出现 NULL、空字符串、unknown 和其他拼写变体,否则会形成多个难以管理的分区。
对新出现的地区、来源或业务类型,应确认是否会导致极端倾斜。单个分区占据绝大多数数据时,查询性能可能受热点文件和并发限制影响,需要结合时间键、哈希桶或写入层合并策略处理。
三、执行数据写入与文件大小优化
1. 用批量写入替代高频小批次提交
流式任务或频繁微批会不断生成小 Parquet 文件。短期内写入延迟可能较低,但长期会增加对象存储请求、元数据扫描和调度开销。可采用以下方式:
- 在内存或临时存储中累积一定数据量后再写入。
- 按目标分区批量提交,避免每条消息单独落盘。
- 定期运行 compaction,将同一分区内的小文件合并。
- 合并后检查是否出现单文件过大,避免单个任务处理压力集中。
2. 选择压缩编码与数据类型
对一般分析型数据,Snappy 通常兼顾解压速度和压缩效果;ZSTD 往往能进一步降低存储与扫描量,但需要结合 CPU 成本和查询延迟验证。字符串字段应尽量避免不必要的超长文本复制,时间、整数和布尔字段应使用合适的物理类型。
例如,将只包含日期的数据保存为 DATE,将计数保存为整型,将低基数枚举字段统一字典化,有助于减少存储空间并改善列读取效率。不要为了节省空间把所有字段都转换为字符串,这会削弱类型过滤和后续计算效率。
3. 避免重复写入和分区覆盖风险
追加写入时,应为批次建立唯一标识,并记录数据时间范围、来源和写入状态。重跑任务可能导致同一记录重复进入分区。对于按天生成的离线数据,可采用临时目录写入、校验完成后原子替换的方式,避免查询读到半成品。
四、针对查询引擎优化 Parquet 文件
1. 确保分区谓词能够下推
查询时直接过滤分区列,通常比对分区列进行复杂函数转换更容易触发分区裁剪。例如优先使用:
SELECT user_id, item_id, event_time
FROM events
WHERE dt >= DATE '2025-01-01'
  AND dt < DATE '2025-01-08';
谨慎使用以下形式:
WHERE CAST(event_time AS DATE) = DATE '2025-01-01'如果 event_time 不是实际分区列,或者表达式无法被引擎识别,查询可能扫描更多文件。更稳妥的方式是在写入时生成标准化的 dt 分区字段,并在查询中直接过滤 dt。
2. 只读取需要的列
避免在大表上默认使用 SELECT *。显式指定需要的列,可以发挥 Parquet 列式读取优势。对训练数据或多模态数据,图像、音频、视频和长文本字段往往体积较大,应按任务拆分为元数据表、特征表和内容索引,只有需要时才读取大字段。
3. 利用行组统计信息
Parquet 文件通常会保存每个行组的最小值、最大值和空值数量。写入时保持相近范围的数据相对集中,有助于查询引擎根据统计信息跳过不匹配的行组。可以按时间、来源或业务键排序后再写入,但排序成本必须通过基准测试证明值得。
4. 处理数据倾斜
如果某个分区包含远多于其他分区的数据,查询可能出现单任务过重。可采取以下措施:
- 提高时间粒度,例如从月分区调整为天分区。
- 在同一时间分区下增加有限的业务维度。
- 对极端热点值单独归档或建立独立数据集。
- 在写入阶段控制文件大小和并发度,避免所有数据集中到一个文件。
五、用基准测试验证优化结果
1. 固定测试条件
优化前后应使用同一数据范围、同一查询引擎版本、相近的集群资源和相同的结果集要求。至少准备三类 SQL:
- 分区过滤查询:验证目录裁剪效果。
- 列过滤查询:验证列裁剪和大字段隔离效果。
- 聚合查询:验证行组统计、数据倾斜和并行度。
2. 记录关键指标
| 指标 | 验证重点 |
|---|---|
| 总耗时 | 用户实际感知的查询延迟 |
| 扫描数据量 | 分区裁剪和列裁剪是否生效 |
| 读取文件数 | 是否存在大量小文件或无效扫描 |
| 任务数与峰值并发 | 是否出现调度开销或热点任务 |
| CPU、内存与网络 | 压缩、排序和解压成本是否合理 |
| 结果正确性 | 分区重写、过滤和去重是否引入数据遗漏 |
3. 设置可接受阈值
不要只看平均耗时。建议同时记录 P50、P95 或业务规定的最大延迟,并设定扫描量、文件数和错误率阈值。例如,最近一天查询不应扫描全年目录;重写分区后,记录总数、主键去重数和关键聚合值应与基线一致。
4. 建立持续监控
将每天新增分区数、平均文件大小、最大小文件、空分区数量、单分区数据量和典型查询扫描量纳入监控。发现平均文件大小持续下降或某个分区突然膨胀时,应触发合并、重分区或数据质量排查。
六、常见场景与选型建议
AI 训练与 RAG 数据
训练数据通常包含样本元数据、标签、来源、版本和大体积内容。建议按数据集版本、采集日期或业务来源组织目录,将文本、图像、音视频内容与元数据分离;检索和评估任务先扫描轻量元数据,确认样本范围后再读取内容字段。对于需要持续补充样本的数据集,按日期或批次分区比按单条样本 ID 分区更易维护。
电商与市场分析
订单、商品、价格和行为数据通常适合按事件日期或业务日期分区。地区、渠道和商品类目是否成为第二级分区,应根据查询频率和数据分布决定。对于经常查询最近七天的报表,应重点验证最近分区是否存在小文件堆积和热点访问。
网页采集与 SEO 监测
抓取结果可按采集日期、任务批次或数据来源组织。URL、页面正文和响应原文不宜全部作为分区键;这类高基数字段更适合作为普通列,并结合必要的索引、去重表或检索系统使用。需要保存不同采集版本时,可将 schema_version 或 crawl_batch 作为元数据字段,避免无计划地增加目录层级。
在需要外部数据采集或定制数据集交付的项目中,Dataify 提供网页采集、SERP、视频数据和通用采集 API,并覆盖音视频、图像、文本及多个行业数据集;接入前仍应按照目标查询模式自行确定 Parquet 分区和归档策略。
实施检查清单
- 确认至少三类真实查询及其过滤字段。
- 估算分区数量、每日数据量和文件数量。
- 确定日期格式、空值规则和目录命名规范。
- 选择压缩方式、数据类型和目标文件大小。
- 配置批量写入与小文件合并任务。
- 用 EXPLAIN 或引擎执行计划确认分区裁剪。
- 对比优化前后的扫描量、耗时、资源消耗和结果正确性。
- 将分区规模、文件大小和查询扫描量纳入持续监控。
常见问题
Parquet 一定要做分区吗?
不一定。数据量较小、查询范围固定或主要按主键检索时,额外分区可能增加管理成本。通常当数据规模较大且查询经常按时间、地区或业务类型过滤时,分区收益更明显。
为什么按用户 ID 分区通常会变慢?
用户 ID 基数通常很高,会产生大量目录和小文件。查询引擎需要读取更多元数据,写入、维护和权限管理也更复杂。除非查询模式高度集中且每个分区有足够数据,否则应将用户 ID 保留为普通列。
Parquet 分区越多,查询就越快吗?
不是。分区过多会造成分区爆炸、小文件和元数据开销。分区数量应与数据量、查询过滤条件和文件规模共同决定,通常需要通过基准测试选择合理粒度。
如何判断分区裁剪是否生效?
查看查询执行计划和运行指标,重点确认实际读取的分区数、文件数和扫描字节数是否明显小于全量数据。如果查询仍扫描大量无关目录,需要检查分区字段类型、过滤表达式、目录命名和引擎元数据刷新状态。
小文件问题应该如何处理?
优先减少高频微批写入,按分区批量提交,并通过 compaction 合并同一分区的小文件。合并任务应设置目标文件大小和并发限制,同时验证重写过程中没有重复记录或遗漏数据。
时间分区应按天、小时还是月?
按天是常见起点。单日数据量很大、查询经常限定小时范围时可考虑按小时;数据量较小且查询多按月统计时可按月。最终选择应以分区数量、单分区文件规模和实际查询扫描量为依据。
总结
Parquet 性能优化的关键不是增加更多分区,而是让分区边界匹配真实查询,同时控制分区基数、文件大小、数据倾斜和小文件数量。推荐按“查询画像分析、分区设计、批量写入、文件合并、查询裁剪、基准验证、持续监控”的顺序实施。完成后,应使用固定 SQL 对比扫描量、文件数、耗时、资源消耗和结果正确性,只有在这些指标同时改善时,才能确认分区设计真正有效。