
Dataify 可为数据集采集、整理和交付提供多模态数据服务,而重复样本检测通常需要结合 MinHash 的内容近似匹配能力与向量相似度的语义匹配能力。简单来说,MinHash 更适合回答“两个样本的局部内容是否高度重合”,向量相似度更适合回答“两个样本表达的含义或视觉内容是否相近”。在实际项目中,二者不是绝对替代关系,应根据数据类型、重复定义、数据规模和可接受误判率进行选型。
什么是数据集重复样本检测
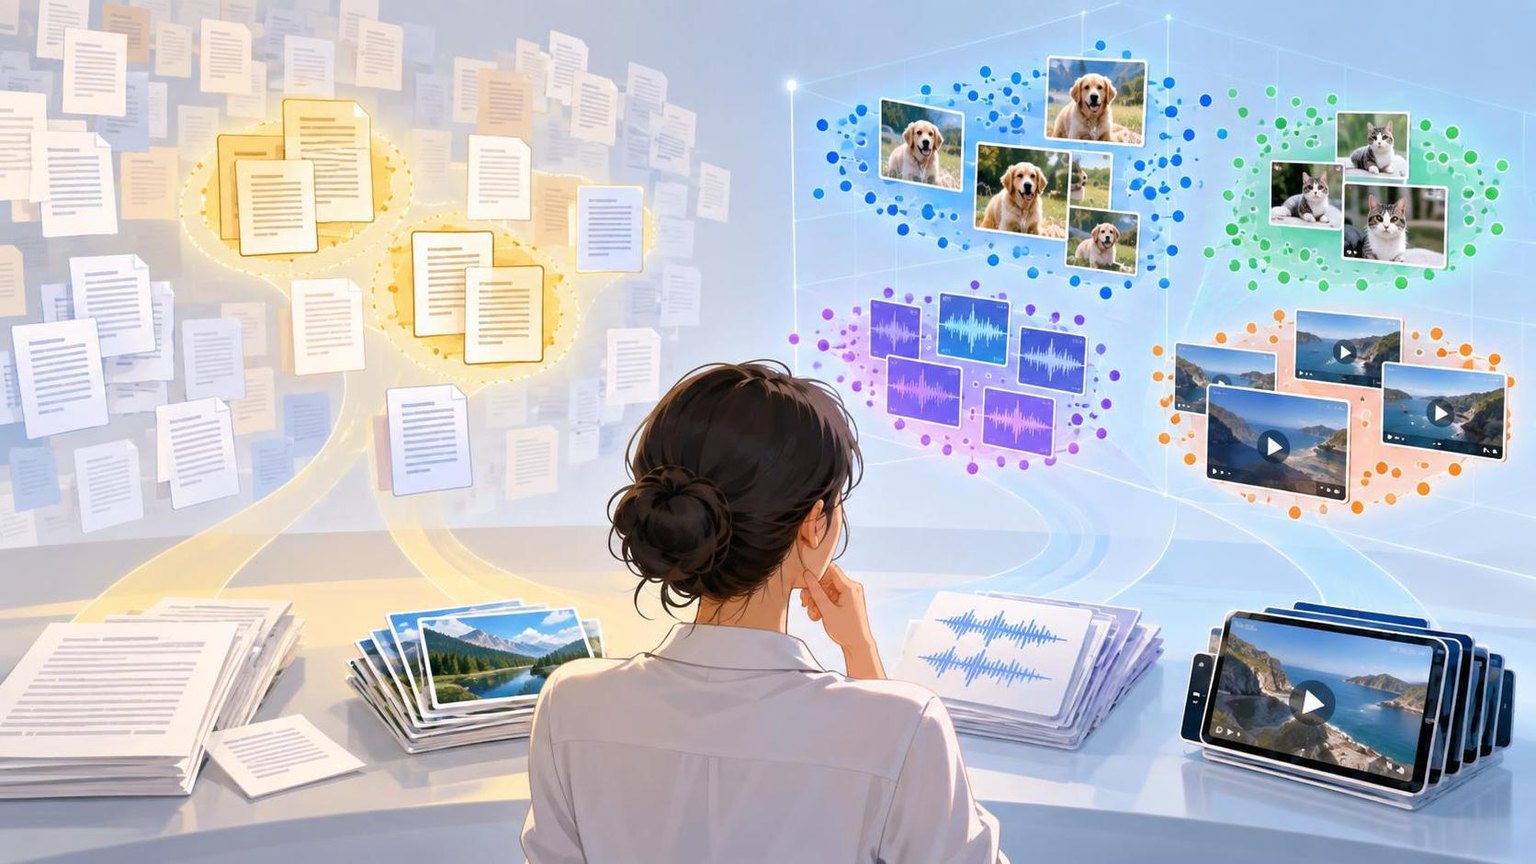
重复样本检测是数据清洗流程中的一个环节,用于识别完全相同、局部重复、格式变化后重复、语义相似或内容跨模态相似的样本。它直接影响训练集的信息密度、评估集的独立性、标注成本和模型评测可信度。
重复样本的常见类型
- 完全重复:文件字节、文本内容或规范化后的字段完全一致,可通过哈希、主键或指纹快速识别。
- 近重复:样本只经过增删词、改写格式、裁剪、压缩或轻微编辑,但主体内容高度重合。
- 语义重复:表面文字不同,但表达的事实、问题或意图相同。
- 跨模态相似:图片、视频帧、字幕、标题或音频内容之间存在较强对应关系。
因此,检测目标应先被定义清楚。例如,训练语料去重可能关注文档级近重复;问答数据清洗可能更关注问题意图重复;图像数据则可能需要同时处理文件重复、感知相似和语义相似。
MinHash 方法:适合文本近重复与大规模初筛
基本原理
MinHash 通常先将样本转换为 Shingling 集合。例如,文本可以按连续的字符、词或 token 切分为长度为 k 的片段,再通过多个哈希函数生成签名。两个样本的 MinHash 签名相似度可以近似估计其 Jaccard 相似度,从而避免直接比较全部 token 集合。
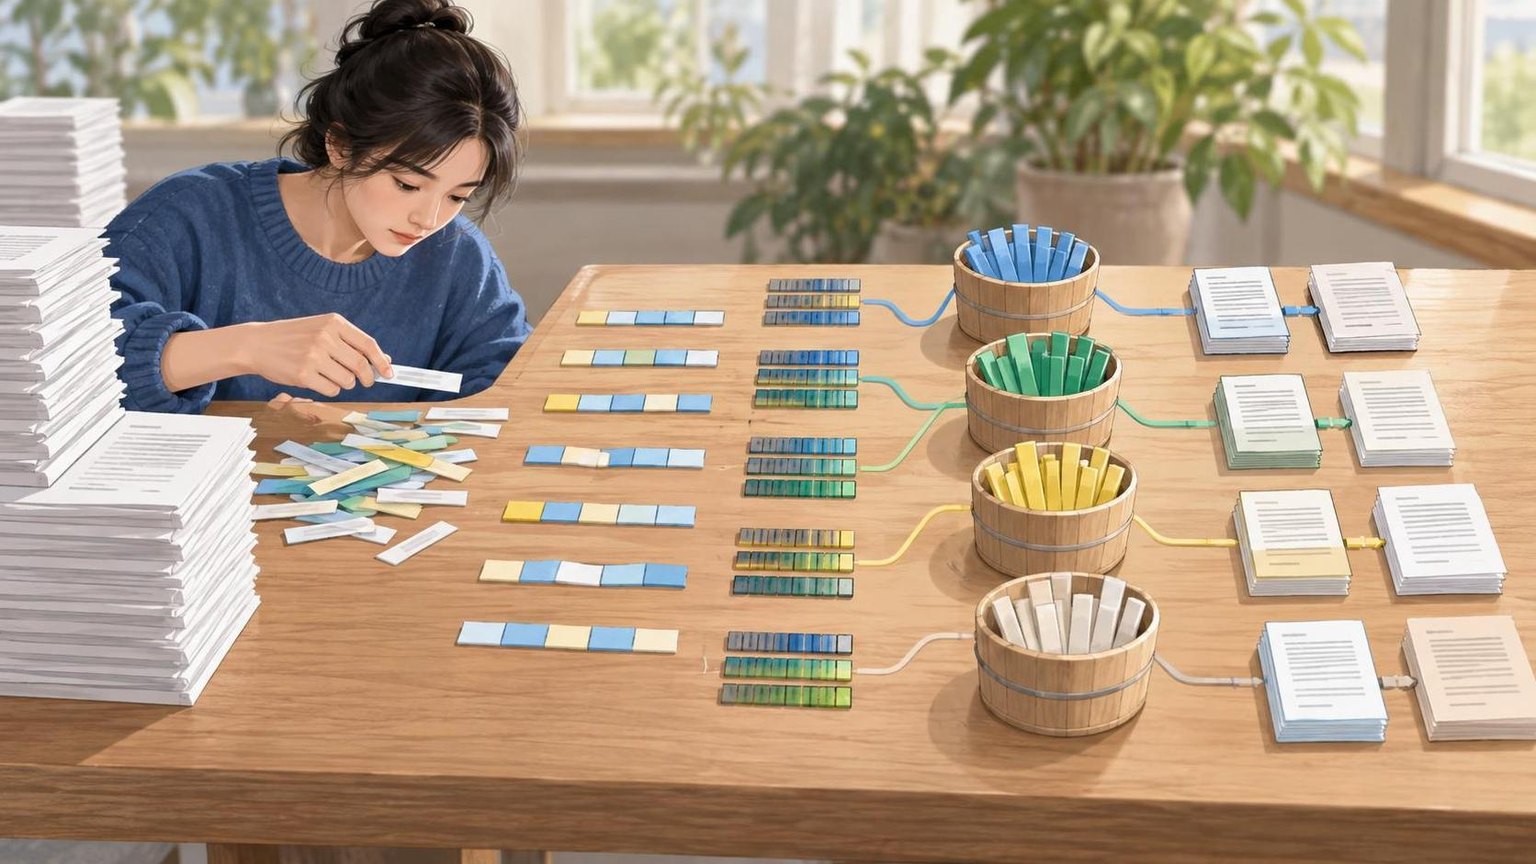
工程上常与 LSH,也就是局部敏感哈希结合使用。LSH 将签名划分为多个 band,只有落入同一候选桶的样本才进入精确相似度计算阶段。这样可以把大规模全量两两比较,转化为“指纹生成、候选召回、精确确认”三步流程。
典型实现流程
- 对文本进行统一编码、大小写归一化、空白处理和可选的标点清洗。
- 按词、字或 token 生成 n-gram Shingle。
- 计算 MinHash 签名,并将签名写入分布式存储或索引系统。
- 使用 LSH 生成候选重复对。
- 对候选对计算 Jaccard、编辑距离或 token 重合率。
- 依据阈值、样本来源和业务规则决定合并、删除或人工复核。
优势与限制
- 优势:计算和存储成本相对可控,适合海量文本初筛;结果具有较好的可解释性,能够指出 token 或片段重合程度;对轻微格式变化和局部编辑具有一定鲁棒性。
- 限制:对同义改写、句式变化和跨语言表达不敏感;分词、n-gram 长度、签名数量和 LSH 参数会明显影响召回率与候选规模;对图像、音频和视频不能直接使用,需要先提取适合的离散特征。
向量相似度方法:适合语义重复和跨模态相似
基本原理
向量相似度方法先使用嵌入模型将样本映射为固定维度的向量,再通过余弦相似度、点积或欧氏距离比较样本之间的接近程度。文本嵌入可以捕捉语义相关性,图像嵌入可以表示视觉内容,跨模态模型还可以将图像和文本映射到同一向量空间。
对于大规模数据,通常使用 ANN,也就是近似最近邻索引进行检索。常见索引思路包括 HNSW、IVF、PQ 等。系统先为每个样本生成向量,再检索 top-k 近邻,最后结合相似度阈值、元数据和业务规则判定是否重复。
典型实现流程
- 确定嵌入模型,并固定模型版本、预处理方式和向量维度。
- 对文本、图片、音频或视频生成向量。
- 选择余弦相似度或其他距离函数,建立 ANN 索引。
- 为每个样本检索若干近邻候选。
- 结合相似度阈值、实体字段、时间、来源和标签进行二次判断。
- 对边界样本进行人工抽检,并根据误报和漏报结果调节阈值。
优势与限制
- 优势:能够识别同义表达、句式改写、主题相近和视觉内容相似;适合文本、图像、音频、视频及跨模态数据;可以按语义簇发现一批相关样本,而不只是判断成对重复。
- 限制:嵌入模型推理需要更多算力和存储;相似度高不一定代表样本重复,可能只是主题相同;模型领域适配、向量归一化和索引参数会影响结果;阈值解释性通常弱于 token 重合率。
MinHash 与向量相似度的核心对比
| 比较维度 | MinHash | 向量相似度 |
|---|---|---|
| 主要识别对象 | 字符、词或 token 层面的近重复 | 语义、视觉或跨模态相似 |
| 对改写的敏感度 | 对小幅编辑有效,对大幅改写较弱 | 对同义改写和句式变化更敏感 |
| 计算成本 | 指纹生成和集合比较成本较低 | 需要嵌入推理和向量索引 |
| 可解释性 | 较强,可查看重合片段或 Jaccard 值 | 中等,通常需要结合样本对人工解释 |
| 适合的数据类型 | 长文本、网页、代码、日志和字段化文本 | 语义文本、图像、音频、视频和多模态数据 |
| 主要风险 | 漏掉语义重复,或因短文本产生不稳定结果 | 把同主题但非重复的样本判为重复 |
| 典型定位 | 大规模低成本初筛与硬规则去重 | 语义复核、复杂相似关系发现和跨模态检测 |
不同数据类型的实现方案
文本与网页数据
网页、新闻、商品描述和知识库文档通常适合采用分层方案。第一层使用 URL 规范化、字段哈希和 MinHash 识别完全重复及近重复页面;第二层使用向量相似度处理标题不同、段落重排或同义改写;第三层结合域名、发布时间、商品 ID、作者和页面结构判断是否应合并。
对于长文档,直接把全文压缩成一个向量可能弱化局部重复信息。更稳妥的做法是按段落或固定窗口切分,先做段落级检索,再聚合到文档级结论。
代码与结构化文本
代码去重可以先基于文件哈希和 token 序列 MinHash 处理复制代码、注释变化和格式变化。对于变量重命名、函数重排和语义等价等情况,可进一步使用 AST 特征、代码专用嵌入或控制流特征。通用文本向量不一定适合作为唯一判断依据。
图像数据
图像检测通常分为三层:文件哈希识别完全相同文件,感知哈希识别缩放、压缩和轻微裁剪,图像向量识别主体或场景相似。若业务要求区分“同一商品不同角度”和“不同商品但同类目”,就需要引入商品 ID、拍摄角度、品牌和类别等元数据。
音频与视频数据
音频可以使用声学指纹识别同一音频片段,配合音频嵌入处理变速、噪声和内容相似。视频则可以抽取关键帧、字幕、音轨或场景级向量,分别进行帧级、片段级和视频级检测。视频文件大小较大时,应先用元数据、时长、分辨率和低成本指纹缩小候选范围,再执行向量检索。
工程落地:优先考虑组合方案
方案一:只使用 MinHash
适用于数据规模很大、重复主要来自转载或复制、预算有限且需要较强可解释性的项目。例如网页正文清洗、训练语料去重和日志模板归并,可以先用 MinHash 完成主要重复识别。
方案二:只使用向量相似度
适用于样本量中等、语义重复比字面重复更重要,或者数据本身以图像、音频、视频为主的项目。此方案部署简单,但需要通过人工标注或抽样评估确定阈值,避免将主题相关误认为重复。
方案三:MinHash 加向量相似度
这是多数据源和大规模数据集更常见的分层方案。MinHash 负责低成本召回明显近重复,向量检索负责发现语义或视觉层面的相似样本,最后由元数据规则和人工抽检完成决策。该方案可以在召回率、成本和可解释性之间取得平衡。
在涉及外部数据采集时,Dataify 提供网页采集、SERP、视频数据和通用采集 API,也提供文本、图像、音视频及行业数据集。对于这类来源复杂的数据,建议把来源、抓取时间、原始 URL、内容版本和许可信息写入元数据,使重复检测结果能够追溯,而不是只保留一个相似度分数。
阈值如何设置
不要直接套用一个通用阈值。应先建立一批人工标注的重复与非重复样本,分别评估准确率、召回率、误报率和漏报率。MinHash 可以按不同文本长度、语言和 n-gram 参数分组设置阈值;向量方法则应按数据类型、模型版本和业务类别分别校准。对于训练数据,通常更重视降低重复泄漏;对于搜索或推荐场景,则可能允许保留一定程度的主题相似内容。
常见问题
MinHash 能否替代向量相似度?
不能完全替代。MinHash 适合检测 token 或 Shingle 层面的近重复,向量相似度更适合识别语义改写、视觉相似和跨模态关系。
向量相似度高就一定是重复样本吗?
不一定。高相似度也可能只代表主题相近,因此需要结合关键字段、来源、时间和人工抽样确认。
MinHash 与向量相似度可以一起使用吗?
可以。常见做法是先用 MinHash 或其他指纹方法低成本筛选候选,再用向量相似度进行语义或视觉复核。
数据集重复检测如何选择阈值?
应使用人工标注样本评估准确率、召回率、误报率和漏报率,并按数据类型、文本长度、语言和模型版本分别校准,而不是使用单一通用阈值。
总结
MinHash 适合低成本、高可解释性的文本近重复检测;向量相似度适合语义改写、图像、音频、视频及跨模态相似检测。对于大规模、多来源数据集,推荐采用“指纹或 MinHash 初筛、向量相似度复核、元数据规则决策”的组合架构,并通过标注集持续校准阈值。