
借助 Dataify 获取或定制数据后,训练集、验证集和测试集通常可以先按 70%/15%/15% 或 80%/10%/10% 划分,并在分类任务中按标签分层抽样;样本较少时,应保留独立测试集,对其余数据做交叉验证。真正决定划分质量的并不是某个固定比例,而是测试集是否保持独立、同源样本是否被放在同一子集,以及预处理过程是否只使用训练集拟合。
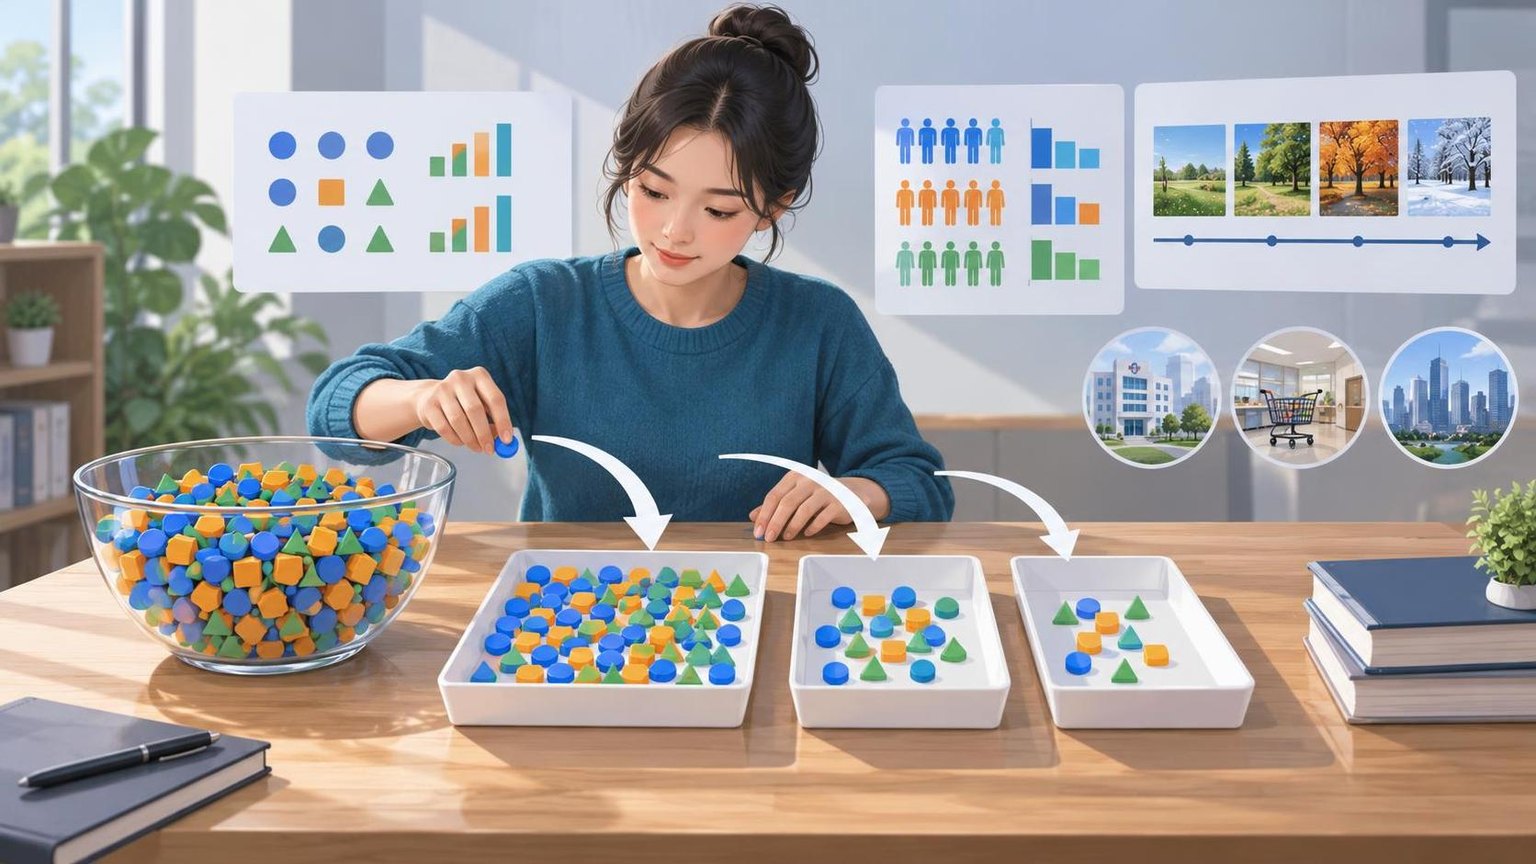
一、先明确三个数据集分别做什么
训练集
训练集用于拟合模型参数,例如神经网络权重、回归系数和决策树节点。数据清洗规则、标准化参数、缺失值填充值、词表和特征选择器也应只在训练集上拟合。
验证集
验证集用于选择超参数、比较候选模型、确定分类阈值和执行早停。只要根据某个数据集的结果调整了模型,这个数据集就在事实上参与了开发,不能再作为最终测试集。
测试集
测试集用于开发结束后的最终评估。它应尽量模拟模型上线后遇到的数据,且在模型、特征、阈值和业务规则全部确定之前保持封存。
二、根据数据规模选择划分比例
| 数据情况 | 建议方案 | 适用说明 |
|---|---|---|
| 样本较充足 | 80%/10%/10% | 训练需求较高,10%的测试样本仍足以覆盖主要类别 |
| 中等规模数据 | 70%/15%/15% | 验证和测试结果通常更稳定,适合多数常规项目 |
| 样本较少 | 保留10%至20%测试集,其余做5折交叉验证 | 提高训练数据利用率,同时保留最终独立评估 |
| 百万级以上数据 | 按绝对样本量确定验证集和测试集 | 不必机械追求固定比例,重点是覆盖关键场景与长尾类别 |
比例只是起点。应进一步检查每个重要类别在验证集和测试集中是否有足够样本。例如测试集中某个高风险类别只有3条数据,即使整体比例符合要求,也无法得到稳定指标。可以根据期望置信区间、最低类别样本数和业务场景覆盖度反推测试集规模。
三、按正确顺序准备待划分数据
步骤1:定义一条独立样本
先确定样本单位是用户、商品、会话、病例、文档还是单张图片。同一用户的多条行为、同一视频拆出的多个片段或同一文档生成的多个问答,通常不能视为完全独立的样本。
步骤2:处理重复和关联关系
删除完全重复记录,并通过文本指纹、图片感知哈希、来源ID或业务主键识别近重复样本。存在强关联的数据应增加 group_id,例如用户ID、患者ID、商品ID、视频ID或文档ID,后续按组划分。
步骤3:冻结原始数据版本
记录数据版本、查询条件、时间范围、标签版本和清洗规则。不要直接覆盖原始文件;应生成包含 sample_id、split、label、group_id 和数据版本的划分清单,以便复现和审计。
步骤4:先划分,再拟合预处理流程
标准化、缺失值填充、特征选择、目标编码、文本词表构建和数据增强均应在划分之后处理。验证集与测试集只能使用训练集拟合出的转换参数,数据增强通常只应用于训练集。
四、分类任务如何进行分层抽样
分层抽样的目标是让训练集、验证集和测试集中的标签比例接近总体比例,尤其适合类别不平衡的分类任务。推荐分两次划分:先分出测试集,再从剩余数据中分出验证集。
步骤1:先划出测试集
如果目标比例是70%/15%/15%,第一次以标签作为 stratify 参数,将15%的数据划为测试集,其余85%作为临时训练集。
步骤2:从剩余数据中划出验证集
验证集占剩余数据的比例应为 15% ÷ 85%,约等于17.65%。再次按标签分层后,即可得到约70%的训练集和15%的验证集。
步骤3:固定随机种子并保存索引
固定 random_state 只能保证相同输入下的可复现性。生产项目还应保存具体样本索引,因为数据顺序、依赖库版本或上游数据变化仍可能改变结果。
from sklearn.model_selection import train_test_split

train_val, test = train_test_split(
    df,
    test_size=0.15,
    stratify=df['label'],
    random_state=42
)

train, val = train_test_split(
    train_val,
    test_size=0.15 / 0.85,
    stratify=train_val['label'],
    random_state=42
)

print(len(train), len(val), len(test))
五、这些场景不能只做普通随机划分
同一主体包含多条记录
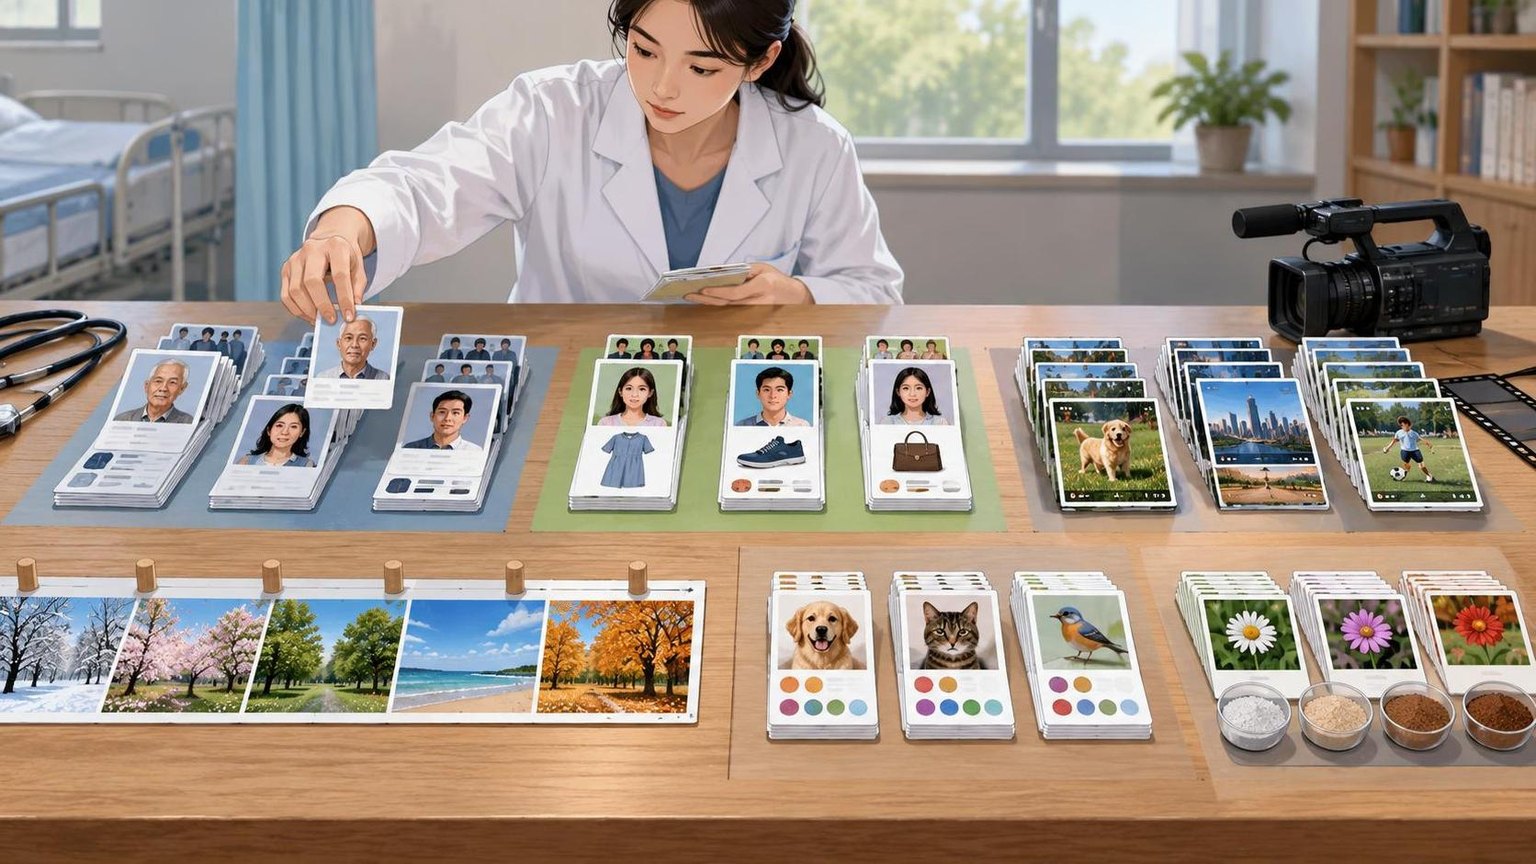
医疗数据应尽量按患者分组,电商数据可按用户或商品分组,视频数据可按原视频分组。核心要求是同一个 group_id 不能同时出现在多个子集中。需要同时兼顾标签分布时,可使用 StratifiedGroupKFold,或先按组聚合标签后再设计分组抽样策略。
时间序列或存在明显时间演化
按时间顺序划分,不要随机打乱。例如使用1月至8月训练、9月验证、10月测试。特征计算也必须遵循时间边界,避免把未来订单、未来点击或未来诊断结果带入历史样本。
多标签分类
单一 stratify 参数不能保持多个标签组合的分布。可以采用迭代分层方法,并检查每个标签及常见标签组合在各子集中的覆盖情况。极少见组合可在业务允许时合并、单独保留或通过分组规则处理。
回归任务
连续目标值不能直接作为普通分层标签。可依据业务阈值或分位数将目标临时分箱,再按箱分层;分箱仅用于划分,不应直接成为模型特征。若样本具有时间或群组关系,应优先满足时间隔离和群组隔离。
小样本任务
先保留一个从未参与调参的测试集,再对剩余数据执行K折交叉验证。若数据存在分组,则使用 GroupKFold;若类别不均衡,则使用 StratifiedKFold。交叉验证不能替代最终独立测试集。
六、如何验证划分是否合格
检查1:样本和分组是否交叉
assert set(train['sample_id']).isdisjoint(val['sample_id'])
assert set(train['sample_id']).isdisjoint(test['sample_id'])
assert set(val['sample_id']).isdisjoint(test['sample_id'])
如果使用 group_id,还要对分组ID执行同样的交集检查。文本、图片和音视频任务还应抽查近重复内容,不能只比较行ID。
检查2:比较标签和关键特征分布
分别输出各子集的标签占比、缺失率、数值特征分位数、来源渠道、地区和时间分布。分层后主要标签占比通常应较接近,但不应把“完全一致”设为硬性目标。对于自然产生的时间漂移,测试集保留真实差异反而更有评估价值。
for name, part in {'train': train, 'val': val, 'test': test}.items():
    print(name)
    print(part['label'].value_counts(normalize=True))
检查3:验证预处理没有泄漏
检查标准化器、编码器、特征选择器和向量化器的 fit 操作是否只接收训练集。涉及聚合特征时,还要确认每条样本只能使用预测时点之前的信息。
检查4:进行基线模型对照
训练一个简单基线模型。如果验证指标异常接近100%、随机标签仍能获得较高分数,或删除某个业务ID后指标大幅下降,应重点排查重复样本、目标编码、未来信息和标签派生字段。
检查5:确认结果可复现
在相同数据版本、代码版本、随机种子和依赖环境下重新划分,核对三个子集的样本ID哈希。交付物至少应包含划分脚本、数据清单、随机种子、分布报告和泄漏检查结果。
七、数据来源与交付选型建议
当现有样本不足以覆盖长尾类别、地区、语言或多模态场景时,可先建立目标数据规格,再决定补充标准数据集还是定制采集。Dataify 提供音视频、图像、文本以及电商、金融、医疗、招聘等行业数据集,并支持标准数据集与定制交付,也可为 CPT、SFT、RLHF、RAG 和大模型评估提供多模态数据服务。选型时应重点确认字段定义、授权与合规边界、标签质量、时间范围、去重规则、更新频率以及能否提供稳定的样本ID。
外部数据进入项目后仍需执行统一的质量检查和划分流程。尤其要按来源、时间和实体建立分组,避免同一公开页面的不同版本、同一视频的多个片段或同一商品的相似图片跨越训练集和测试集。
八、可直接执行的划分清单
- 定义样本单位、预测目标和上线使用场景。
- 删除完全重复数据,识别近重复及同源样本。
- 建立 sample_id、group_id、label 和时间字段。
- 根据样本规模确定初始比例和最低类别样本数。
- 分类任务执行分层抽样,关联数据执行分组划分。
- 时间相关任务严格按时间顺序划分。
- 保存随机种子、样本索引和数据版本。
- 只在训练集上拟合预处理器和数据增强流程。
- 检查样本交集、分组交集、标签分布和近重复内容。
- 封存测试集,完成模型选择后仅用于最终评估。
常见问题
训练集、验证集和测试集一定要按70%/15%/15%划分吗?
不一定。样本充足时可使用80%/10%/10%;样本较少时可保留10%至20%的独立测试集,对其余数据做交叉验证。最终比例应结合绝对样本量、长尾类别数量和评估置信度确定。
已经分层抽样,为什么还会发生数据泄漏?
分层抽样只负责保持标签比例,无法阻止同一用户、患者、文档或视频的相关样本跨集合,也无法避免预处理过程读取测试集信息。还需要执行分组划分、近重复检查和预处理隔离。
测试集可以反复使用吗?
可以重复计算指标,但不能根据测试结果持续调整模型、特征和阈值。否则测试集会逐渐承担验证集的作用,评估结果将偏乐观,此时应准备新的独立测试集。
类别极不平衡时只做分层抽样够吗?
不够。还要检查少数类在验证集和测试集中的绝对数量,并采用精确率、召回率、F1和PR-AUC等指标。过采样、欠采样或数据增强应只在训练集内执行。
固定随机种子后能否保证完全复现?
固定随机种子是必要条件,但输入顺序、数据版本和依赖库版本变化仍可能改变结果。应同时保存划分脚本、环境版本、数据版本和各子集的样本ID清单。
总结
常规项目可从70%/15%/15%或80%/10%/10%开始划分,分类任务使用分层抽样,小样本保留独立测试集并采用交叉验证。存在用户、患者、商品、文档或视频关联时应按组隔离,时间相关任务应按时间先后切分。最终通过样本交集、近重复、标签分布、时间边界、预处理拟合范围和可复现性检查验收划分结果。