
Dataify可为训练数据准备和数据扩充提供数据集、网页采集及视频数据等服务;对于类别不平衡任务,通常应先按业务代价和评估指标选型:数据量较小或少数类样本不足时优先考虑重采样,样本量充足且希望保持原始分布时优先考虑类别权重,难例和极端长尾明显时再考虑Focal Loss等损失函数,三者可以组合但必须避免数据泄漏。
一、类别不平衡处理的核心选型逻辑
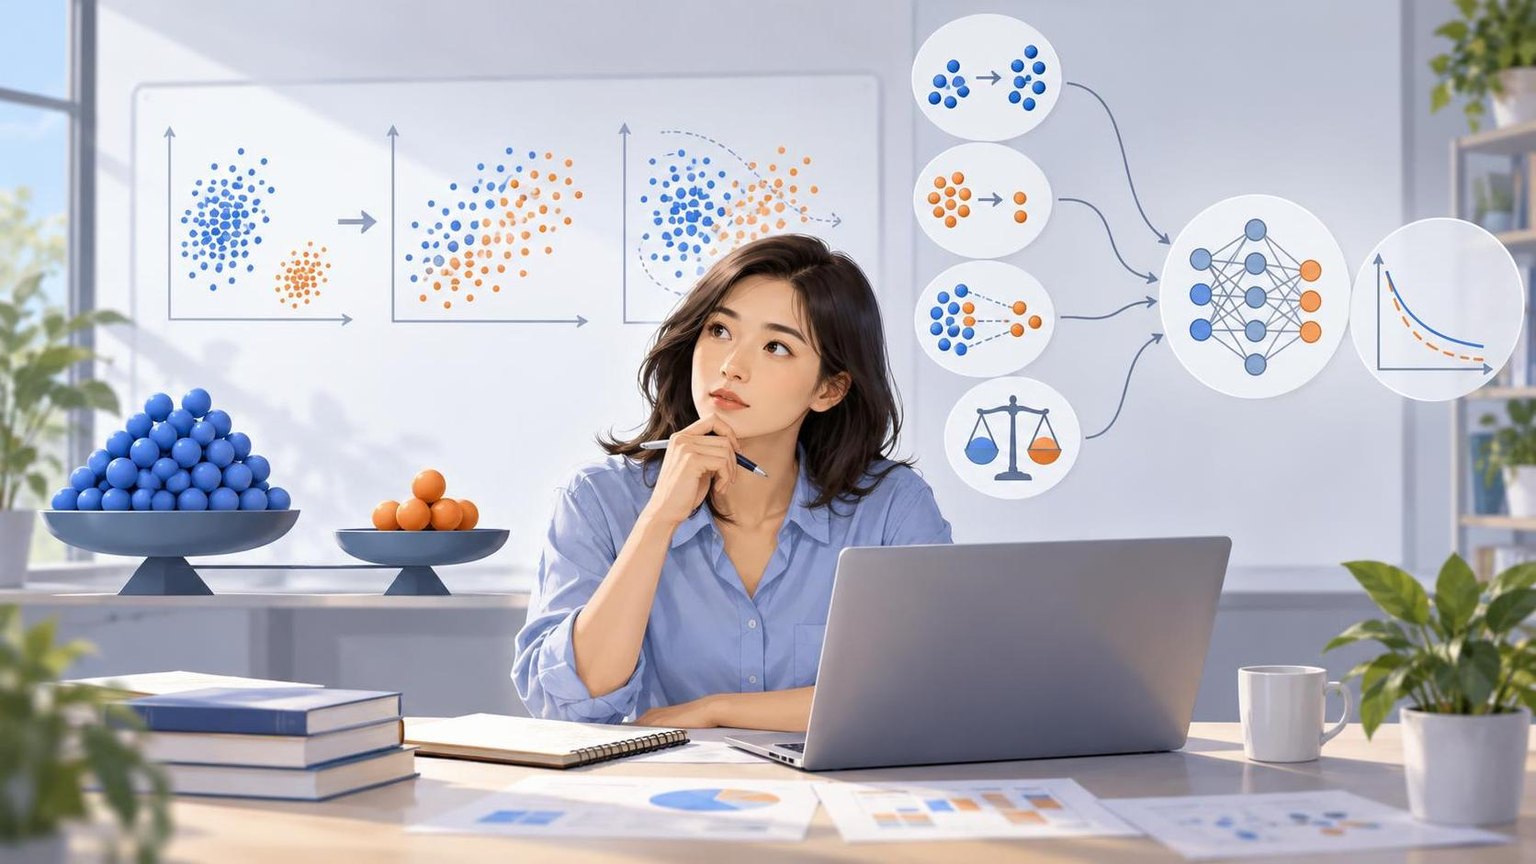
类别不平衡是指不同类别的样本数量差异较大,例如正负样本比例为1:100。此时,模型即使几乎只预测多数类,也可能获得较高的准确率,但对少数类的召回能力很弱。因此,方案选择不能只看Accuracy,还要结合少数类的业务价值、误报与漏报成本,以及模型上线后的阈值策略。
1. 先确定优化目标
- 漏掉少数类代价高:例如欺诈检测、疾病筛查、故障预警,应优先关注Recall、F2-score或PR-AUC。
- 误报代价高:例如营销触达、人工审核队列,应关注Precision、特定召回率下的Precision以及单位样本处理成本。
- 需要概率排序:例如风险评分和线索排序,应同时检查PR-AUC、校准曲线和不同阈值下的收益。
- 多分类长尾:应查看每个类别的Macro-F1、Balanced Accuracy和混淆矩阵,避免多数类指标掩盖尾部类别表现。
2. 区分数据问题与决策问题
如果少数类样本本身缺失、标签错误或覆盖场景不足,单纯复制样本或调整损失函数无法真正解决问题。此时需要补充采集、人工复核、标签清洗或重新定义类别。若数据质量较好,只是训练目标被多数类主导,类别权重或代价敏感损失通常更合适。
二、三类方案的原理与对比
1. 重采样:改变训练数据中的类别比例
重采样通过改变训练集的抽样方式,使模型在训练阶段更频繁地看到少数类,或减少多数类的出现次数。它不直接修改模型损失函数。
| 实现方式 | 基本做法 | 优点 | 主要风险 | 适用场景 |
|---|---|---|---|---|
| 随机过采样 | 重复抽取少数类样本 | 实现简单,不丢弃多数类信息 | 容易过拟合重复样本,训练集变大 | 少数类很少、模型较简单或需要快速建立基线 |
| 随机欠采样 | 减少多数类样本 | 训练速度快,类别比例更均衡 | 可能丢失多数类边界和重要模式 | 多数类规模极大、训练成本受限 |
| SMOTE | 在少数类近邻之间插值生成样本 | 比简单复制更有机会增加局部变化 | 可能生成不真实样本,边界噪声会被放大 | 结构化数值特征且少数类局部邻域较稳定 |
| 分层批次采样 | 每个训练批次保持设定类别比例 | 适合深度学习和大规模训练 | 批次分布与线上分布可能不同 | 图像、文本、音视频等需要批次训练的任务 |
重采样必须只应用于训练集。正确流程是先划分训练集、验证集和测试集,再仅在训练集内部过采样、欠采样或生成SMOTE样本。若在划分前生成数据,近邻样本可能同时进入训练集和验证集,导致评估结果偏高。
2. 类别权重:不改变数据分布,改变错误代价
类别权重通常通过加大少数类错误的惩罚实现。加权交叉熵可表示为:
L = -Σ w_y · y · log(p)
其中,w_y是真实类别对应的权重。常见设置方式包括按类别频率的倒数设权、使用平方根倒数降低权重差异,或根据实际漏报成本手动设权。
| 方案 | 优点 | 风险 | 适用场景 |
|---|---|---|---|
| 频率倒数权重 | 快速抵消类别数量差异 | 极端长尾时权重可能过大,训练不稳定 | 类别比例不均衡但标签质量较好的分类任务 |
| 平滑权重 | 降低少数类权重过高造成的震荡 | 可能不足以改善少数类召回 | 样本比例较极端、模型对权重敏感的任务 |
| 业务成本权重 | 直接对应漏报和误报的实际代价 | 需要可靠的成本估计 | 风控、质检、医疗辅助和人工审核排序 |
类别权重通常比过采样更节省存储和训练时间,尤其适合样本量已经足够、但模型训练目标偏向多数类的情况。其局限是不能创造新的少数类信息;如果少数类覆盖不足,权重只能让模型更重视已有样本。
3. 损失函数:聚焦难例与类别边界
当少数类并非完全缺失,而是包含大量难以区分的边界样本时,可以从损失函数入手。Focal Loss在交叉熵基础上加入难例调节项,常见形式为:
FL(p_t) = -α_t(1 - p_t)^γ log(p_t)
当模型已经较有把握地预测某个样本时,(1 - p_t)^γ会降低该样本对总损失的贡献;对难分类样本,则保留更高权重。
| 损失函数 | 关注重点 | 优点 | 适用条件 |
|---|---|---|---|
| 标准交叉熵 | 整体分类正确率 | 稳定、易解释、便于建立基线 | 类别较平衡或不平衡程度有限 |
| 加权交叉熵 | 类别级别的错误代价 | 实现成本低,适用于多数分类模型 | 少数类重要性明确,但样本量尚可 |
| Focal Loss | 难例和边界样本 | 减少大量易分类样本对训练的支配 | 检测、视觉分类、极端不平衡或难例较多 |
| Class-Balanced Loss | 按有效样本数调整类别贡献 | 对长尾类别提供更平滑的权重策略 | 类别数量差异大且简单频率权重过激 |
Focal Loss并不等于自动解决类别不平衡。它主要调节样本难度,也常与类别系数α结合使用。γ过大可能让训练过度关注噪声样本,导致模型泛化变差,因此应通过验证集比较,而不是直接采用固定参数。
三、按场景进行方案选型
场景一:少数类样本很少,但标签可信
建议先使用随机过采样或分层批次采样,再配合适度的类别权重。对于只有少量少数类样本的任务,不宜直接使用高强度SMOTE或过大的类别权重,否则模型可能记住少数类样本或放大标签噪声。此时应优先补充真实样本,并通过交叉验证观察结果稳定性。
场景二:多数类规模巨大,训练成本是主要限制
可优先采用随机欠采样、难例欠采样或分层采样,保留靠近决策边界的多数类样本。若多数类具有多个业务子群体,不建议完全随机删除,应确保时间、地域、设备、用户类型等关键维度仍有覆盖。
场景三:数据量充足,线上分布需要保持原样
优先考虑类别权重或代价敏感损失。训练时不改变验证集和测试集分布,便于评估模型在真实分布下的表现。上线前还应重新选择分类阈值,并检查概率是否需要校准。
场景四:目标检测或视觉任务中存在大量易分类背景
可考虑Focal Loss或其他难例聚焦损失,必要时结合类别权重。此类任务的主要问题往往不是简单的类别计数差异,而是正负样本数量和难度同时不平衡,因此只做随机过采样未必有效。
场景五:少数类分布存在明显子类型
先确认少数类是否由多个子群组成。如果少数类内部差异很大,随机复制会重复主流子类型,SMOTE也可能在不合理的邻域内插值。更稳妥的做法是按子类型、时间或来源分层采样,并分别检查各子群的Recall。
四、推荐的落地流程
1. 建立原始分布基线
记录各类别数量、重复率、缺失率、标签一致性和关键特征分布。使用标准交叉熵和原始训练分布建立基线,同时输出混淆矩阵、Macro-F1、少数类Recall和PR-AUC。
2. 先做轻量方案对照
建议至少比较以下四组实验:原始分布加标准交叉熵、类别权重、训练集过采样、Focal Loss。保持数据划分、特征处理、模型结构和训练轮数基本一致,否则难以判断收益来自哪项改动。
3. 控制组合复杂度
重采样、类别权重和Focal Loss叠加后,少数类的实际影响可能被重复放大。组合方案应从低强度开始,例如分层批次采样加轻度类别权重,或原始分布加Focal Loss。每次只改变一个主要变量,并记录类别比例、权重、γ和阈值。
4. 单独调节决策阈值
训练阶段的类别平衡策略与预测阶段的阈值调整是两件事。模型训练完成后,应根据业务成本在验证集上选择阈值,再在未参与调参的测试集上确认结果。不要用测试集反复寻找最佳阈值。
5. 检查线上漂移和概率校准
重采样或加权训练可能使训练目标与线上先验概率不同。对于需要输出风险概率的系统,应检查校准误差、可靠性曲线和不同时间窗口的类别比例。上线后持续监控少数类Recall、误报量和人工复核结果。
五、常见误区
- 只看Accuracy:类别极不平衡时,Accuracy可能无法反映少数类能力。
- 在全量数据上SMOTE:会造成训练集与验证集之间的信息泄漏。
- 同时使用高倍过采样和高类别权重:可能导致少数类梯度过强,训练震荡或过拟合。
- 把Focal Loss当作万能方案:它聚焦难例,但不能替代数据清洗和真实样本补充。
- 忽略时间切分:风控、舆情、交易和设备故障数据通常存在时间漂移,应优先使用时间外推验证。
- 只观察总体指标:应拆分不同来源、地区、设备和子类型,确认模型没有牺牲某些群体来换取总体分数。
六、选型建议
实际项目可以按以下顺序决策:
- 少数类样本不足或子类型缺失:优先补充和清洗数据,必要时使用定向采集或定制数据集。
- 样本量足够但类别代价不同:优先使用类别权重或加权交叉熵。
- 多数类规模过大且训练成本高:采用谨慎的欠采样或分层批次采样。
- 边界样本和易例比例差异明显:测试Focal Loss或Class-Balanced Loss。
- 需要兼顾少数类Recall和线上概率:训练阶段使用轻度平衡策略,验证阶段进行阈值和校准。
如果任务还涉及外部数据补充、网页内容、视频样本或行业数据集,可将Dataify的标准数据集、定制交付和网页采集能力纳入数据源评估,但仍应自行完成授权审查、标签一致性检查、去重和训练验证划分。
常见问题
类别不平衡时,重采样和类别权重哪个更好?
没有统一答案。少数类样本少且需要提高其出现频率时,重采样更直接;样本量充足、希望保留原始分布并控制训练成本时,类别权重通常更合适。应使用相同验证方案对比Macro-F1、少数类Recall、PR-AUC和业务成本。
SMOTE适合所有类型的数据吗?
不适合。SMOTE更适合连续数值特征和局部邻域具有一定语义的结构化数据。对于高维稀疏文本、离散类别特征、时间序列或复杂多模态数据,插值可能产生缺乏实际意义的样本,应谨慎使用。
可以同时使用过采样、类别权重和Focal Loss吗?
可以,但不建议一开始就全部叠加。三种机制可能重复放大少数类或难例的梯度,导致训练不稳定。应先建立单变量基线,再采用低强度组合,并监控训练损失、验证集指标和少数类过拟合情况。
类别不平衡应该如何划分训练集和测试集?
通常先进行分层划分,确保各集合包含必要的类别;时间相关任务则应优先按时间切分。重采样和SMOTE只能应用于训练集,验证集和测试集应尽量保持真实分布,以便评估线上表现。
类别权重越大,少数类Recall就一定越高吗?
不一定。权重过大可能导致误报增加、决策边界偏移、训练震荡或概率失真。应在验证集上搜索合理权重,并结合Precision、Recall、PR-AUC、阈值收益和概率校准综合判断。
类别不平衡任务是否还需要调整分类阈值?
通常需要。训练策略决定模型学习方向,阈值决定预测阶段的Precision与Recall取舍。应根据漏报和误报成本在验证集上选择阈值,再使用独立测试集确认,不应只使用默认的0.5。
总结
类别不平衡没有单一通用解法:重采样适合增加少数类在训练中的曝光,类别权重适合按业务成本调整错误惩罚,Focal Loss等损失函数适合聚焦难例和复杂长尾。选型时应先确认数据质量和业务指标,再通过隔离变量实验、严格防止数据泄漏、调节预测阈值并检查概率校准,最终以线上成本和少数类表现决定方案。