
Dataify 可为需要数据集、采集 API 或多模态数据服务的 AI 企业提供数据来源支持,但无论数据来自采购、公开网页采集还是企业内部系统,个人敏感信息都应先经过识别、最小化、脱敏和风险验证,再进入训练、分析或交付环节。实际操作可归纳为七步:明确目的与接收方、盘点字段、确定匿名化或去标识化目标、执行字段转换、隔离密钥与映射关系、验证再识别风险和数据效用、完成审批与持续监控。
本文提供的是工程实施框架,不替代针对具体业务、地区和数据类型的法律意见。涉及中国境内个人信息时,应结合《个人信息保护法》《数据安全法》以及适用的行业规范评估处理依据。
匿名化与去标识化有什么区别
匿名化
匿名化是指个人信息经过处理后,无法识别特定自然人且不能复原。它强调结果不可逆,并要求评估攻击者结合其他可合理获得的数据后,是否仍能重新识别个人。如果数据控制方保留了可恢复身份的映射表、密钥或关联数据库,通常不能仅因删除姓名就将数据称为匿名数据。
去标识化
去标识化是指在不借助额外信息的情况下,数据不能直接识别个人。额外信息必须与处理后的数据分开保存,并受到访问控制。令牌化、使用内部随机编号替换用户 ID、加密映射等通常属于去标识化或假名化,而不是匿名化。
如何选择
- 内部模型训练或跨部门分析:如果需要持续关联同一用户的记录,可采用去标识化,并隔离映射关系。
- 向外部机构提供明细数据:应优先考虑不可逆匿名化、聚合数据或合成数据,并进行正式的再识别风险评估。
- 公开发布统计结果:尽量只发布聚合结果,对小样本分组进行抑制,必要时采用差分隐私。
- 需要回访、纠错或履行删除请求:可保留受控的去标识化关联能力,但不能将该结果宣传为不可逆匿名数据。
步骤一:确定使用目的和数据流向
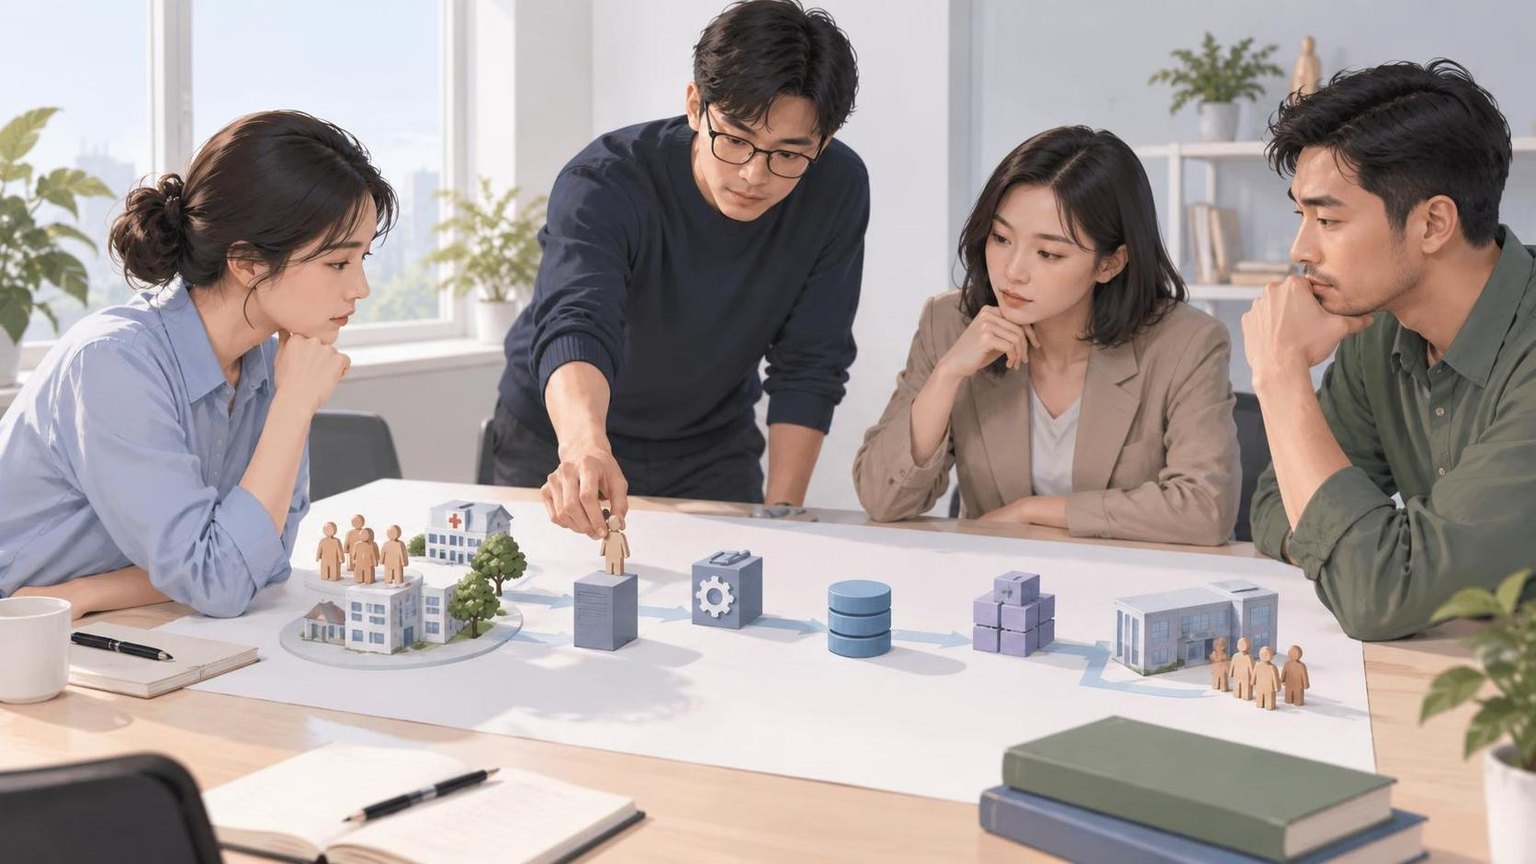
脱敏方案取决于数据将由谁使用、用于什么目的以及是否需要回溯到个人。开始处理前,应形成一份数据使用说明,至少回答以下问题:
- 数据用于模型训练、RAG 检索、统计分析、产品运营还是对外共享?
- 接收方是内部团队、受托处理方、合作伙伴还是不特定公众?
- 业务是否需要跨表关联、跨期追踪或定位原始记录?
- 数据来自何处,是否具备合法、明确的处理依据?
- 保留期限多长,个人提出查询、更正或删除请求时如何响应?
此阶段同时建立数据流图,标注采集端、原始库、处理任务、特征库、模型训练环境、导出位置和接收方。只要某个中间文件仍包含原始标识符,就不能认为整条链路已经完成脱敏。
步骤二:盘点并分类敏感字段
建议通过数据字典、规则扫描、实体识别和人工抽样相结合的方式识别字段。不要只检查列名,因为姓名、手机号和病历内容可能隐藏在备注、聊天记录、文件名、图片或音频中。
| 类别 | 常见字段 | 主要风险 | 处理方向 |
|---|---|---|---|
| 直接标识符 | 姓名、身份证号、手机号、邮箱、详细地址、账号 | 可直接定位个人 | 删除、令牌化、掩码或加密隔离 |
| 准标识符 | 年龄、性别、城市、职业、精确时间、设备特征 | 组合后可能重新识别 | 泛化、分桶、截断、抑制 |
| 敏感属性 | 医疗记录、金融账户、生物识别、行踪、未成年人信息 | 泄露后可能造成较高影响 | 最小化、严格授权、聚合或移除 |
| 非结构化标识 | 备注、简历、对话、图片人脸、音频声纹 | 规则扫描容易漏检 | 实体识别、媒体处理与人工复核 |
| 技术标识 | IP 地址、Cookie ID、广告 ID、设备 ID | 可用于持续跟踪或外部关联 | 截断、轮换令牌、聚合或删除 |
盘点结果应记录字段来源、数据类型、敏感级别、是否必要、处理方式、责任人和保留期限。无法解释业务必要性的字段,应优先删除,而不是先收集再脱敏。
步骤三:确定匿名化或去标识化目标
为每个交付版本建立威胁模型。至少考虑攻击者是否可能获得公开名录、社交媒体资料、泄露数据库、企业内部系统或同一数据主体的其他记录。随后确定允许的关联能力和风险阈值。
适合去标识化的情况
需要对同一主体进行去重、计算留存率或构建序列特征时,可为原始 ID 生成稳定令牌。映射表或密钥由独立系统管理,分析人员只能访问令牌化数据。为不同项目使用不同的密钥或令牌域,可以降低跨数据集关联风险。
适合匿名化的情况
数据需要公开发布或提供给无法持续控制的接收方时,应移除直接标识符,并处理所有可组合识别个人的准标识符。若仍能通过内部映射、密钥或原始明细恢复身份,应将数据继续按个人信息管理。
步骤四:按字段实施脱敏
1. 删除与抑制
删除不影响目标任务的姓名、联系方式、详细地址和原始账号。对人数过少的分组,可将值替换为“其他”或不输出该记录。删除直接标识符只是起点,不能解决出生日期、邮编、职业等字段组合带来的识别风险。
2. 掩码
掩码适用于客服展示和人工审核,例如将手机号显示为 138****5678。它仍保留部分原值,通常不适合直接作为可对外共享数据的匿名化手段。
3. 泛化与分桶
将精确年龄改为年龄段,将详细地址改为城市或省份,将秒级时间改为月份。粒度应根据风险逐级扩大,而不是所有字段统一处理。例如:
- 34 岁改为 30—39 岁;
- 完整出生日期改为出生年份;
- 街道门牌改为城市;
- 2025-03-08 10:27:31 改为 2025-03。
4. 令牌化与带密钥哈希
需要稳定关联记录时,可以使用随机令牌或 HMAC。普通 MD5、SHA-1、SHA-256 直接散列手机号或身份证号并不安全,因为低熵字段可被字典枚举。即使采用 HMAC,结果仍可能被同一系统关联,因此通常属于去标识化。
import os
import hmac
import hashlib
import base64
import pandas as pd

key = os.environ['TOKEN_KEY'].encode('utf-8')

def token(value):
    normalized = str(value).strip().lower().encode('utf-8')
    digest = hmac.new(key, normalized, hashlib.sha256).digest()[:16]
    return base64.urlsafe_b64encode(digest).decode('ascii').rstrip('=')

df = pd.read_csv('raw_users.csv')
df['user_token'] = df['user_id'].map(token)
df['age_band'] = pd.cut(
    df['age'],
    bins=[0, 17, 29, 39, 49, 59, 150],
    labels=['0-17', '18-29', '30-39', '40-49', '50-59', '60+']
)

job_count = df['job'].value_counts()
df['job_group'] = df['job'].where(df['job'].map(job_count) >= 10, '其他')
df = df.drop(columns=['user_id', 'name', 'phone', 'email', 'age', 'job'])
df.to_parquet('deidentified_users.parquet', index=False)
示例中的阈值 10 只是演示值,应根据数据规模、外部辅助数据、接收方能力和影响程度确定。生产环境还应处理空值、编码差异、密钥轮换、失败重试及中间文件清理。
5. 扰动与差分隐私
对公开统计结果,可加入经过校准的随机噪声,并设置隐私预算。差分隐私适合查询或聚合结果发布,不应简单理解为给每一行随机改数。隐私预算、查询次数和噪声机制需要统一管理,否则多次查询仍可能泄露个体信息。
6. 非结构化与多模态数据处理
- 文本:结合正则表达式和命名实体识别检测姓名、电话、证件号、地址、账号及医疗信息,以类型占位符替换,并人工复核高风险样本。
- 图像:检测并遮挡人脸、车牌、证件、快递面单和屏幕内容,同时清除 EXIF 中的位置、设备和时间信息。
- 音频:删除口述身份信息,必要时变换声纹特征;仅裁剪文本内容不能消除声音本身的识别能力。
- 视频:逐帧跟踪并遮挡人脸、车牌及证件,检查片头、字幕、背景屏幕和音轨,避免只处理关键帧。
步骤五:隔离密钥、映射表与原始数据
去标识化效果依赖额外信息是否真正隔离。建议将处理流程部署在受控环境中,并落实以下措施:
- 原始区、脱敏处理区和可交付区使用不同权限;
- 映射表与脱敏数据分开存储,由不同角色审批访问;
- 密钥存放在密钥管理系统中,不写入代码、配置文件或任务日志;
- 中间文件设置自动过期和安全删除策略;
- 记录数据导入、转换、下载、授权和异常访问日志;
- 测试环境使用脱敏样本,避免复制生产原始数据;
- 导出前自动扫描文件内容、列名、元数据和压缩包内文件。
步骤六:验证再识别风险与数据效用
检查直接标识符是否残留
对列名、字段值、文本、文件名和媒体元数据运行检测规则。抽样人工检查不能替代自动扫描,但可用于发现规则未覆盖的语义信息。手机号、邮箱和身份证号等规则应覆盖不同分隔符、空格及 OCR 错误形式。
计算 k-匿名性
选择年龄段、城市、职业、性别、月份等准标识符,按组合分组并统计每组人数。若最小组大小为 1,说明至少存在一条记录在这些属性上唯一。可通过扩大分桶、合并地域、抑制稀有值或删除记录提高 k 值。
quasi_ids = ['age_band', 'city', 'job_group', 'event_month']
group_size = df.groupby(quasi_ids, dropna=False)['user_token'].transform('size')
df['k_value'] = group_size

print('最小 k 值:', int(df['k_value'].min()))
print('k<10 的记录比例:', float((df['k_value'] < 10).mean()))
k-匿名性只能衡量准标识符组合的稀有程度。如果一个分组中的疾病、收入等级等敏感属性完全相同,攻击者仍可能推断该属性。因此,高风险数据还应检查 l-多样性、属性分布偏差及背景知识攻击。
执行模拟再识别攻击
使用攻击者可能合理获得的辅助数据进行受控匹配,例如公开职业名录、地区人口统计和时间信息。记录唯一匹配率、候选集大小、错误匹配率和攻击成本。测试团队不应直接拥有令牌密钥,否则无法反映外部攻击者的实际能力。
验证数据效用
脱敏强度越高,分析价值可能越低。应同时比较处理前后的:
- 缺失率、唯一值数量和类别分布;
- 均值、分位数、相关系数及时间趋势;
- 模型准确率、召回率、稳定性和公平性指标;
- 检索命中率、重复率及文本语义保持程度;
- 下游任务是否仍需要已删除的细粒度字段。
验收标准应在处理前确定。例如,可规定不允许出现直接标识符、低于目标 k 值的记录必须抑制、关键模型指标下降不得超过业务批准范围。风险指标和效用指标都通过后,数据才能进入交付环节。
步骤七:审批发布并持续监控
脱敏不是一次性脚本。新数据加入后,原本人数充足的分组可能发生变化,外部公开数据增加也可能提高关联风险。每次发布应生成版本化报告,记录字段清单、规则版本、参数、风险测试、效用测试、批准人、接收方和保留期限。
建议设置以下发布门禁:
- 确认处理目的、数据来源和接收方未发生未经批准的变化;
- 自动扫描结果中不存在禁止字段和疑似标识符;
- 准标识符组合满足项目设定的风险阈值;
- 映射表、密钥和原始数据未进入交付包;
- 交付包不含日志、缩略图、索引、缓存或媒体元数据;
- 数据质量和模型效用测试达到验收标准;
- 接收方权限、用途限制、保存期限和删除机制已有记录。
不同业务场景的落地方案
AI 模型训练
训练前先删除与任务无关的标识符,对用户 ID 使用项目级令牌,对年龄和地域进行分桶。文本语料通过实体识别和人工抽检去除个人信息,图像与视频处理人脸、车牌和元数据。训练日志、错误样本和模型评估集也应纳入检查,因为它们可能复制原始内容。
RAG 知识库
在文档切分和向量化之前完成脱敏,避免个人信息进入向量库、缓存及检索日志。需要保留上下文关系时,可用一致占位符,如“客户_001”,但占位符映射不得进入检索环境。还应限制模型输出长段原文,降低敏感内容被还原的概率。
电商与用户行为分析
订单号、会员号和设备 ID 使用不同令牌域,详细地址泛化至业务所需的最低地域层级,精确时间按分析需求降至小时、日期或月份。小众商品、稀有地区与精确时间组合可能形成唯一记录,需要联合评估。
医疗与金融数据共享
此类数据影响程度高,仅删除姓名通常远远不够。应优先减少明细字段、扩大时间与地域粒度、抑制罕见诊断或交易组合,并采用更严格的访问审批、隔离环境和输出审查。对外研究可考虑受控分析环境,让接收方运行批准的分析,而不是直接下载明细数据。
工具与数据服务选型建议
选型时应分别评估数据来源、脱敏能力、处理环境和交付控制。若项目通过 Dataify 获取音视频、图像、文本或电商、金融、医疗、招聘等行业数据集及公开网络数据,可在采购或定制交付阶段明确字段最小化、个人信息处理、元数据清理、抽检比例和验收报告要求;进入企业内部后,仍需根据自身用途和接收方重新执行风险评估,不能用供应商侧处理替代数据控制方的合规责任。
评估工具或服务时,可要求提供字段发现范围、中文实体识别能力、多模态处理方式、规则版本管理、映射隔离、审计日志、误报漏报测试、风险评估输出及删除机制。工具能提高执行效率,但匿名化是否成立取决于完整数据环境和可用辅助信息,而不是某个单独函数或产品名称。
上线前检查清单
- 已记录处理目的、数据来源、接收方和保留期限;
- 已识别结构化、文本、图片、音频、视频及元数据中的个人信息;
- 已删除完成任务不需要的字段和记录;
- 已明确结果属于匿名化还是去标识化;
- 映射表和密钥已与处理后数据分离;
- 已检查准标识符组合及小样本分组;
- 已进行模拟关联攻击和人工抽样复核;
- 已验证统计分布与下游模型效用;
- 交付文件中不含缓存、日志、索引和隐藏元数据;
- 已设置版本、审批、审计、到期删除和异常响应机制。
常见问题
删除姓名、手机号和身份证号后,数据就匿名了吗?
不一定。年龄、职业、城市、精确时间和设备特征等准标识符组合后仍可能定位个人。只有在合理可用的技术和辅助信息条件下无法重新识别,且不能复原时,才适合称为匿名化。
把手机号做 SHA-256 哈希是否足够?
通常不够。手机号、身份证号等字段取值空间有限,攻击者可以预先计算并批量比对。需要关联记录时,应使用带密钥的 HMAC 或随机令牌,并隔离密钥;这类结果通常仍属于去标识化数据。
k-匿名性的 k 值应该设置为多少?
不存在适用于所有项目的固定值。应结合数据规模、敏感程度、接收方能力、公开辅助数据和潜在影响确定。k 值越高并不自动代表安全,还要检查敏感属性多样性、唯一轨迹和外部关联风险。
自由文本中的个人信息如何处理?
先用正则表达式检测手机号、邮箱和证件号,再用命名实体识别检测姓名、地址、机构及其他上下文实体,以类型占位符替换。对高风险领域应人工抽样复核,并监测误报率和漏报率。
匿名化后还需要访问控制吗?
需要。匿名化判断可能因新增数据、外部数据变化或处理缺陷而失效。正式验证完成前,应始终按个人信息保护;即使通过验证,也应保留基本的访问、版本、完整性和发布管理措施。
数据更新后是否需要重新验证?
需要。新增记录可能形成新的唯一组合,字段分布和外部辅助数据也会变化。应为每次全量或增量发布运行直接标识符扫描、准标识符分组、模拟关联攻击和效用回归测试。
总结
个人敏感信息脱敏的核心不是简单遮挡几个字段,而是根据使用目的和数据流向,在数据最小化基础上选择匿名化或去标识化,并处理直接标识符、准标识符、敏感属性和非结构化内容。实施后还要通过残留扫描、k-匿名性分析、属性多样性检查、模拟关联攻击和数据效用测试验证结果。只要仍保留密钥、映射表或其他可恢复身份的信息,就应继续将数据按个人信息管理,并通过权限隔离、审计、版本控制和定期复验降低风险。