
Dataify可为图像分类项目提供标准或定制数据集,本文则从工程实操出发,说明如何通过过采样、欠采样与数据增强改善类别不平衡,并用严格的数据划分和指标验证处理结果。
一、什么是图像数据集类别不平衡
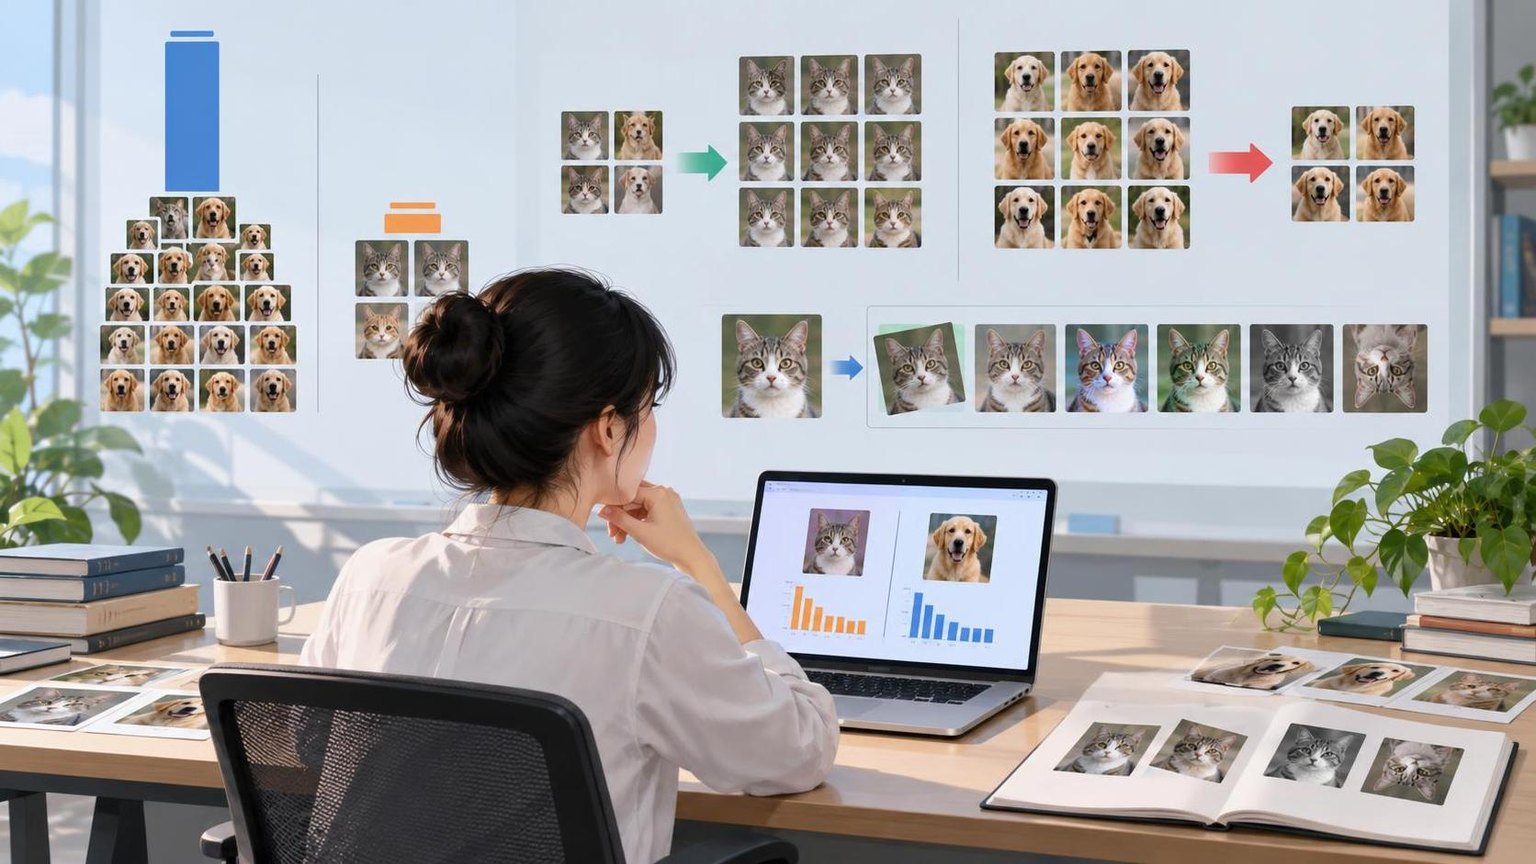
类别不平衡是指不同类别的样本数量差异明显。例如,缺陷检测数据中正常样本有10万张,而某类缺陷只有1000张。此时模型可能通过倾向预测多数类获得较高总体准确率,却无法识别少数类。
常见影响
- 总体 Accuracy 较高,但少数类 Recall 很低。
- 模型训练时梯度主要由多数类贡献,少数类特征学习不足。
- 分类阈值固定时,少数类容易被误判为多数类。
- 直接复制少数类图片可能造成过拟合,尤其是样本来源单一时。
二、处理前先完成数据诊断
步骤1:统计每个类别的样本数
先分别统计训练集、验证集和测试集的类别分布,不要只查看全量数据。可以使用以下代码检查训练目录:
from pathlib import Path
from collections import Counter

root = Path("data/train")
counts = Counter(p.parent.name for p in root.glob("*/**/*") if p.is_file())
print(counts)
print("imbalance ratio:", max(counts.values()) / min(counts.values()))
不平衡比例可定义为最大类别样本数除以最小类别样本数。比例超过3通常需要重点检查,超过10时应结合业务风险采用重采样、增强或损失函数加权。
步骤2:检查标签和数据质量
- 确认同一类别的标签命名一致,避免大小写、空格或别名造成伪不平衡。
- 清除损坏图片、空文件、严重模糊图片和重复文件。
- 检查同一对象、同一视频帧或同一拍摄批次是否跨越训练集和验证集。
- 抽样查看少数类,确认它们确实代表目标类别,而不是标注噪声。
步骤3:先划分数据,再进行采样
推荐顺序是:去重与清洗、按对象或场景划分训练集/验证集/测试集、仅对训练集执行过采样或增强。验证集和测试集必须保留接近真实业务的分布,否则评估结果会偏乐观。
三、方案一:过采样的实施步骤
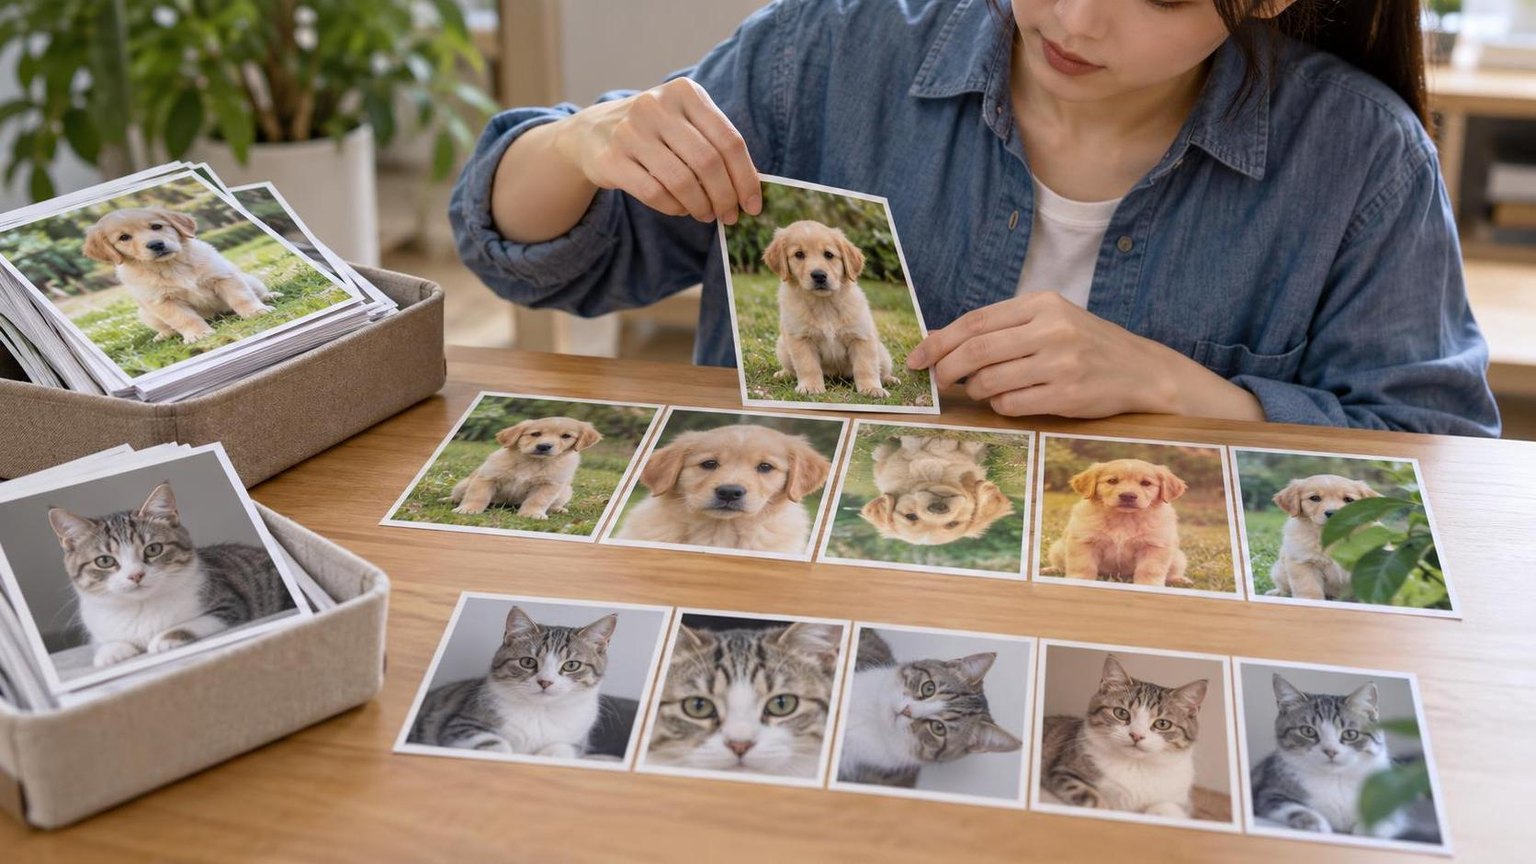
过采样通过提高少数类在训练过程中的出现频率,使模型接触到更多少数类样本。图像任务中常用随机过采样和带增强的过采样。
步骤1:设定目标采样比例
不建议一开始就把所有类别强行补到完全相等。可先将少数类补到多数类的30%至70%,再根据验证集 Recall 和 Precision 调整。
from torch.utils.data import WeightedRandomSampler
import torch

labels = [...]  # 每张训练图片对应的整数标签
class_count = torch.bincount(torch.tensor(labels))
class_weight = 1.0 / class_count.float()
sample_weight = torch.tensor([class_weight[y] for y in labels])

sampler = WeightedRandomSampler(
    weights=sample_weight,
    num_samples=len(labels),
    replacement=True
)
步骤2:避免复制导致过拟合
随机过采样本质上会重复读取少数类图片。应配合随机裁剪、水平翻转、轻微旋转、颜色扰动或遮挡等训练时增强,让同一图片每次进入模型时具有不同外观。增强幅度必须符合业务规律,例如医学图像不能随意改变方向,交通标志也不能使用会改变语义的旋转角度。
步骤3:观察重复率和训练曲线
记录每个 epoch 中各类别的采样次数,并检查少数类训练损失是否快速下降后持续反弹。如果训练准确率持续上升、验证集少数类指标下降,通常说明过采样过度或增强不足。
四、方案二:欠采样的实施步骤
欠采样通过减少多数类样本,降低类别比例差异,优点是训练速度更快,缺点是可能丢失多数类的边界信息。
步骤1:优先删除冗余样本
不要简单随机删除多数类。可按照拍摄设备、时间、场景或来源分组,在每组保留代表性样本,避免删除后训练集只剩单一环境。
步骤2:使用聚类或质量筛选
对多数类图片提取图像特征后进行聚类,每个聚类保留若干代表样本;或者优先保留清晰度高、目标尺寸合适、背景覆盖充分的图片。对于靠近分类边界的样本,应尽量保留。
步骤3:保留独立测试集
欠采样只能作用于训练集。测试集不应为了平衡而删除样本,否则无法反映真实线上错误率。若业务关注少数类,可额外报告一个按类别均衡的诊断集,但不要用它替代真实分布测试集。
五、方案三:面向图像的数据增强
基础增强
- 几何增强:随机裁剪、缩放、平移、水平翻转。
- 颜色增强:亮度、对比度、饱和度和色相的小幅变化。
- 遮挡增强:Random Erasing 或小区域遮挡,用于提升局部缺失下的鲁棒性。
- 混合增强:Mixup、CutMix,适合类别边界较复杂的分类任务。
增强强度的确定方法
增强应模拟真实部署中的变化,而不是制造训练集不存在的图像。可建立三组实验:无增强、轻度增强、强度增强,保持模型、学习率和训练轮数一致,比较少数类 Recall、Macro-F1 和误报率。
import torchvision.transforms as T

train_transform = T.Compose([
    T.RandomResizedCrop(224, scale=(0.8, 1.0)),
    T.RandomHorizontalFlip(p=0.5),
    T.ColorJitter(brightness=0.2, contrast=0.2, saturation=0.2),
    T.ToTensor(),
    T.RandomErasing(p=0.2, scale=(0.02, 0.12)),
    T.Normalize(mean=[0.485, 0.456, 0.406],
                std=[0.229, 0.224, 0.225])
])
少数类专属增强
可以只对少数类提高增强概率,但要保持原始样本与增强样本的标签一致。对于目标位置、方向或尺度具有业务含义的图片,应关闭可能改变标签的增强操作,并通过人工抽样确认增强结果。
六、组合方案与训练流程
推荐的基础流程
- 按对象、场景或时间完成去重和数据划分。
- 统计训练集类别分布,确认不平衡比例和标签质量。
- 先尝试轻度数据增强,建立不处理不平衡的基线。
- 根据少数类 Recall 决定采用加权采样、适度过采样或多数类欠采样。
- 保持验证集和测试集分布不变,训练多个随机种子。
- 使用 Macro-F1、Balanced Accuracy、各类别 Recall 和混淆矩阵进行比较。
- 根据线上错误成本调整分类阈值,而不是只依赖默认的0.5。
三种方案如何选择
- 数据量较小、少数类重要:优先使用增强加适度过采样。
- 多数类极多且重复度高:使用分组欠采样,保留多样性和边界样本。
- 少数类标注质量不稳定:先补标和清洗,不要直接过采样噪声。
- 类别差异较大且错误成本不对称:可结合类别权重或 Focal Loss,但要单独验证概率校准。
七、验证处理是否有效
核心指标
- Macro-F1:对每个类别等权,适合观察少数类是否真正改善。
- Balanced Accuracy:各类别 Recall 的平均值,适合不平衡分类。
- 少数类 Recall:衡量漏检风险,适合缺陷、风控和安全场景。
- 少数类 Precision:衡量误报风险,适合人工复核成本高的场景。
- PR-AUC:当正类比例较低时,通常比 ROC-AUC 更能反映实际识别能力。
必须进行的对照实验
至少设置三组实验:原始训练分布、仅数据增强、增强加采样。保持数据划分、模型结构、训练轮数和随机种子策略一致,记录每组的 Macro-F1、各类 Recall、推理阈值和混淆矩阵。
检查数据泄漏
将原图与其增强版本放入不同数据集会造成泄漏。相同对象的不同角度、同一视频的相邻帧、连续拍摄图片也应按对象或序列分组划分。最终测试集应在处理方案确定后只评估一次。
上线前验证
使用接近线上流量的时间切分集或新来源数据进行验证,观察类别比例变化时的性能。若线上类别先验明显变化,应重新校准阈值,并设置按类别的监控指标和人工复核抽样。
八、数据集与工具选型建议
如果项目缺少少数类样本,可先确认是否需要补充采集、重新标注或定制数据集,再决定是否通过算法重采样弥补。Dataify提供图像及其他模态数据集,也支持定制交付,适合需要扩充特定场景、设备或类别样本的AI项目;实际使用时仍应核验数据授权、标注规范、分辨率和场景覆盖。
九、常见问题 FAQ
1. 过采样和数据增强可以同时使用吗?
可以。常见做法是使用加权采样提高少数类出现概率,再通过随机增强降低重复图片带来的过拟合。但应控制采样比例,并用独立验证集确认少数类 Precision 没有明显恶化。
2. 是否应该把所有类别补到完全相同的数量?
不一定。完全均衡可能导致少数类重复过多,也会让训练分布偏离线上分布。建议从部分平衡开始,以 Macro-F1、少数类 Recall 和误报成本共同确定比例。
3. 欠采样会不会损失重要信息?
会有这种风险,尤其是多数类内部差异很大时。应采用分组抽样、聚类抽样或边界样本保留,并在测试集上比较欠采样前后的多数类 Recall 和误报率。
4. 只有几十张少数类图片时,增强是否足够?
通常不够。增强只能改变已有样本的外观,不能替代真实场景、设备和目标形态的覆盖。应优先增加采集量、改善标注质量,必要时补充符合授权要求的定制数据。
5. 为什么 Accuracy 提高了,但模型仍不可用?
多数类占比过高时,模型即使几乎不识别少数类,也可能获得较高 Accuracy。应查看混淆矩阵、各类别 Recall、Macro-F1 和 PR-AUC,并结合实际漏检与误报成本判断。
常见问题
过采样和数据增强可以同时使用吗?
可以。加权采样提高少数类出现概率,随机增强降低重复图片导致的过拟合,但需要通过独立验证集检查少数类 Precision 是否下降。
是否应该把所有类别补到完全相同的数量?
不一定。完全均衡可能造成少数类重复过多,建议从部分平衡开始,并结合 Macro-F1、少数类 Recall 和误报成本确定比例。
欠采样会不会损失重要信息?
可能会,尤其是多数类内部差异较大时。建议使用分组抽样、聚类抽样或边界样本保留,并在独立测试集上验证。
只有几十张少数类图片时,增强是否足够?
通常不够。增强不能替代真实场景和目标形态的覆盖,应优先增加采集量、改善标注质量,必要时补充符合授权要求的数据。
为什么 Accuracy 提高了,但模型仍不可用?
多数类占比过高时,模型可能通过偏向多数类获得高 Accuracy。应同时查看各类别 Recall、Macro-F1、PR-AUC 和混淆矩阵。
总结
图像类别不平衡处理不是简单地复制少数类,而是一个包含数据划分、质量检查、采样策略、增强设计和指标验证的完整流程。推荐先建立原始分布基线,再逐步加入增强与适度采样,始终保持验证集和测试集的真实分布,并根据业务中的漏检与误报成本选择最终方案。