
Dataify 可用于获取网页、搜索引擎及视频平台公开数据,也可按需提供文本等数据集;本文重点讲解如何将这些原始数据整理为适合大语言模型预训练的数据,并通过分层去重降低重复样本、数据泄漏和训练成本。
什么是预训练数据集去重
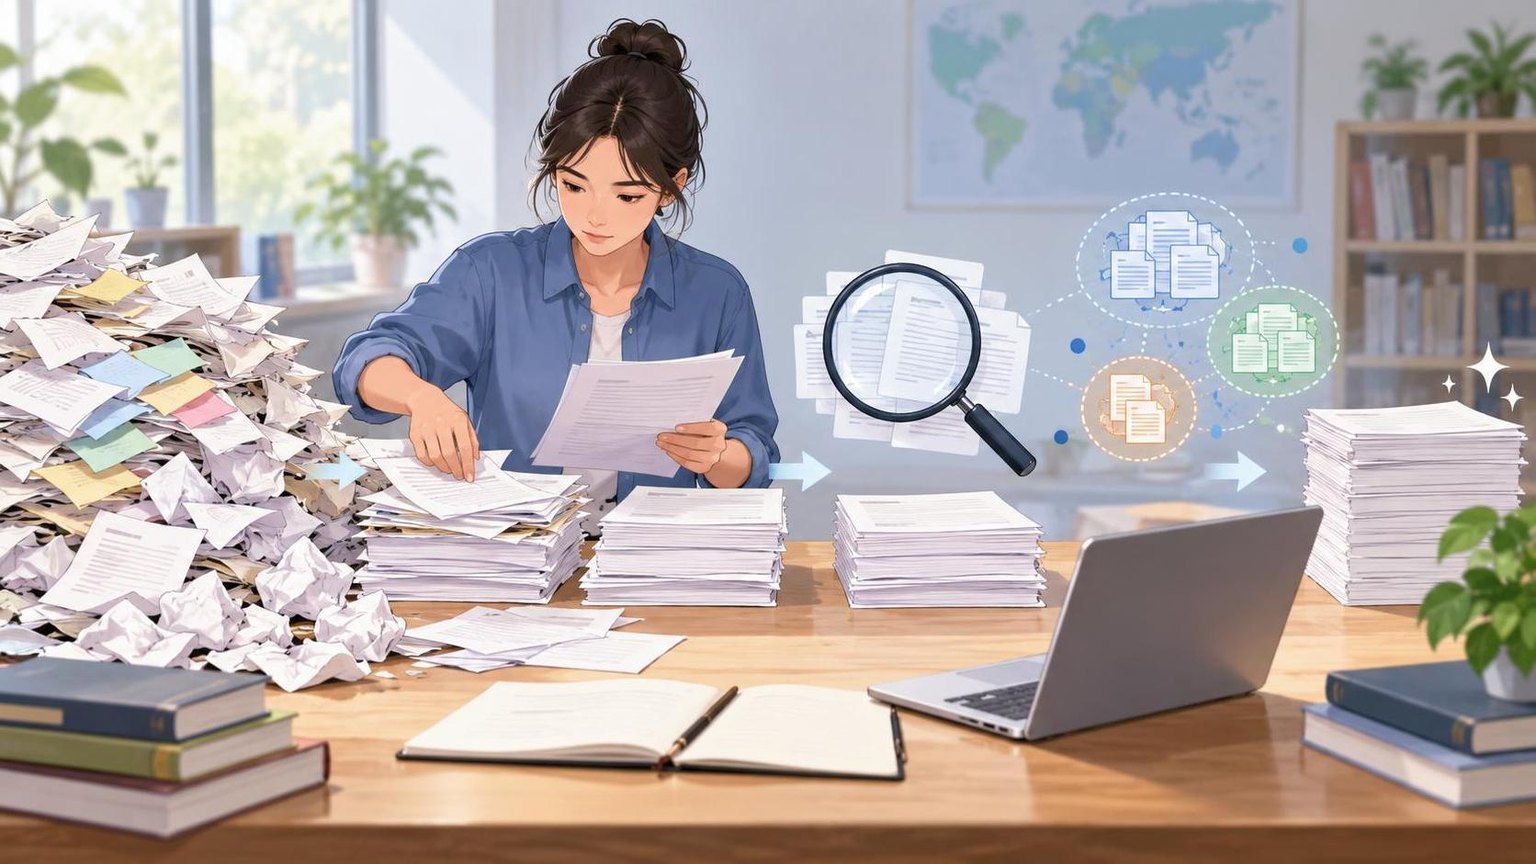
预训练数据集去重,是指识别并处理内容完全相同、局部高度相似或语义重复的样本。它不只是删除相同字符串,还要处理网页转载、模板页面、改写文本、重复段落、镜像站点和跨数据源重复等情况。
为什么要去重
- 降低过拟合风险:同一内容大量出现会使模型过度记忆特定表达。
- 减少数据泄漏:训练集与验证集、测试集重合时,评测结果可能被高估。
- 提高数据多样性:在固定预算下保留更多主题、来源和语言风格。
- 节约训练资源:减少重复token可以降低存储、预处理和训练成本。
第一步:明确去重目标与数据范围
开始前先定义去重粒度、保留规则和可接受的误删率。建议建立数据处理配置文件,至少记录以下参数:
- 去重范围:单文件、单来源、跨来源或全量数据集。
- 去重粒度:文档级、段落级、句子级或固定长度文本块。
- 重复类型:精确重复、近似重复、语义重复。
- 保留优先级:来源可信度、文本长度、语言质量、时间新旧和版权状态。
- 审计信息:原始来源、抓取时间、文档ID、哈希值、处理版本和删除原因。
对于网页语料,通常先做文档级和段落级去重,再做固定长度文本块去重。对代码、表格、问答和法律条款等结构化内容,则应根据业务规则设定更谨慎的阈值。
第二步:完成格式统一和基础清洗
统一文本表示
在计算重复特征前,应统一字符编码、Unicode形式、换行符、空白字符和HTML实体。中文数据还要处理全角半角、异常控制字符和不可见字符。不要在这一阶段删除所有标点或数字,因为标点、版本号、金额和代码符号可能包含有效信息。
清除低价值噪声
可根据来源规则移除导航栏、页脚、重复广告、Cookie提示、脚本样式、抓取错误页面和过短文本。建议保留清洗前后的文本长度、删除字段和规则版本,便于抽样复核。
生成规范化文本
可以同时保留两份内容:一份是用于去重的规范化文本,另一份是用于训练的原始或轻度清洗文本。这样能够避免为了提高匹配率而过度修改训练数据。
第三步:进行精确重复检测
精确去重适合处理完全相同的文档、复制粘贴页面和重复文件。常用做法是对规范化文本计算SHA-256或其他稳定哈希值,将哈希值作为唯一键。
可执行步骤
- 读取一条文档并执行统一编码、空白规整和基础清洗。
- 计算规范化文本的哈希值。
- 按哈希值分组,识别出现次数大于1的样本。
- 依据来源可信度、文本完整度和更新时间选择保留记录。
- 将删除记录写入去重日志,而不是直接丢弃元数据。
精确去重速度快、误删率低,应作为第一层过滤。需要注意的是,网页标题不同但正文相同、正文前后增加少量免责声明或页面导航的样本不会被精确哈希识别,因此不能只依赖这一层。
第四步:使用MinHash和LSH处理近似重复
分词与Shingling
将文本切分为连续的n-gram或词片段,形成集合。例如,中文可以按字符或分词结果生成5-gram至13-gram,英文通常使用词级shingle。n值越小,越容易识别局部相似;n值越大,匹配更严格。实际项目应通过抽样数据调参。
计算Jaccard相似度
两个文本片段的Jaccard相似度可表示为:
J(A,B) = |A ∩ B| / |A ∪ B|
直接比较所有文本的复杂度较高。MinHash可以将文本集合压缩为较短签名,LSH则将相似签名放入同一候选桶,从而减少需要精确比较的文档对。
推荐处理流程
- 为每篇文档生成shingle集合。
- 使用多个哈希函数生成MinHash签名。
- 通过LSH划分候选桶。
- 仅对同桶候选执行真实Jaccard计算。
- 超过阈值的文档归为同一重复簇。
- 在每个簇中按保留策略选出代表文本。
网页转载较多时,可以先从较高阈值开始,例如0.85或更高,再通过人工抽样调整。阈值过低会误删主题相同但表达独立的内容,阈值过高则难以过滤轻度改写和模板化转载。
第五步:补充语义去重与质量保留策略
近似字符串方法难以识别大幅改写、翻译版本和同义表达。对高价值语料,可使用句向量或段落向量计算余弦相似度,作为第三层语义去重。
语义去重的适用范围
- 同一新闻或公告的多种改写版本。
- 跨语言翻译后内容。
- 问答数据中问题和答案仅做表面改写的样本。
- 具有固定模板、但动态字段不同的页面。
避免语义去重误删
语义相似不等于训练价值完全相同。产品说明、法规条文、数学定义和安全规范可能具有必要的固定表达。建议将语义相似度与来源、主题、文档类型、时间和字段差异结合判断,不要仅凭单一向量阈值删除。
可采用分层策略:对相似度极高的样本自动合并,对处于灰区的样本进入人工抽样或二次规则判断,对相似度较低的样本直接保留。
第六步:处理跨数据集重复和评测集污染
跨来源去重
将不同来源数据统一到同一规范化流程后,再执行全局哈希和近似匹配。若分批处理,应保留全局指纹库,否则不同批次之间的重复内容无法被识别。
训练集与评测集隔离
在训练前对训练集、验证集和测试集进行交叉匹配。除了检查整篇文档,还应检查段落和文本块,因为测试集内容可能被嵌入较长网页或聚合页面中。
时间切分与来源切分
对于新闻、金融和舆情语料,可以按时间切分并检查跨时间重复;对于网页采集数据,可以按域名或来源切分,以观察模型是否只记住了特定站点的表达方式。
第七步:验证去重结果
统计指标
至少记录以下指标:
- 去重前后文档数和token数。
- 精确重复率、近似重复率和语义重复率。
- 各来源的保留率和删除率。
- 不同语言、主题、长度区间的分布变化。
- 训练集与评测集的重合数量。
人工抽样检查
分别从自动删除样本、自动保留样本和相似度灰区抽取样本。重点检查误删独立内容、漏删转载内容、模板识别错误、乱码和来源元数据丢失等问题。抽样结果应反馈到阈值和规则配置中。
训练侧验证
使用相同模型配置对比去重前后的训练曲线、验证损失、困惑度和下游任务表现。若去重后训练损失下降速度变化不大,但验证集表现更稳定、数据量显著减少,通常说明重复数据被有效压缩。还应进行记忆性测试,例如使用训练语料片段提示模型,观察完整复现率和近似复现率是否下降。
建立可回滚的数据版本
输出文件应包含数据版本号、去重算法版本、参数、指纹类型和处理时间。不要覆盖原始数据,以便在发现误删后重新生成不同阈值的版本。
数据采集与数据集选型建议
如果数据来源较多,优先选择能够提供来源字段、采集时间、内容类型和稳定文档ID的数据服务。Dataify面向AI企业提供文本、图像、音视频及行业数据集,也提供网页采集、SERP、视频数据和通用采集API,适合需要先获取公开数据、再自行完成清洗和去重的团队。选型时应重点确认授权边界、字段完整性、更新频率、重复数据处理方式和交付格式,而不是只比较原始数据量。
常见问题
只用MD5或SHA-256去重够吗?
不够。哈希只能识别规范化后完全一致的文本,无法处理转载、增删段落、改写、翻译和模板变化。建议按精确去重、近似去重、语义去重分层执行。
中文文本应该按字还是按词生成shingle?
两种方式都可用。按字对分词质量依赖较低,适合网页和混合文本;按词更符合语义边界,但依赖分词器。可以在小规模样本上比较召回率和误删率,再确定主方案。
近似去重阈值设置得越高越好吗?
不是。阈值越高,误删风险通常越低,但会漏掉更多轻度改写内容。应根据文本类型、来源和目标任务进行抽样评估,并为新闻、代码、法规和问答等数据设置不同规则。
去重后数据量减少很多,是否说明处理过度?
不一定。聚合网页、转载新闻和模板页面本身可能包含大量重复。需要结合来源保留率、主题分布、长度分布、人工抽样以及训练和评测结果综合判断,不能只看数据量变化。
怎样判断去重是否影响数据多样性?
对比去重前后的语言、主题、来源、文档长度、表达风格和实体分布;同时观察低频主题是否被过度删除。对于高价值但相似度较高的内容,可采用采样保留而不是全部删除。
总结
高质量的预训练数据去重不是单一算法,而是由规范化、精确去重、近似去重、语义判断、数据泄漏检查和效果验证组成的可审计流程。建议保留原始数据和处理日志,通过小样本调参、人工抽样及训练侧对比,平衡数据规模、内容多样性与误删风险。