
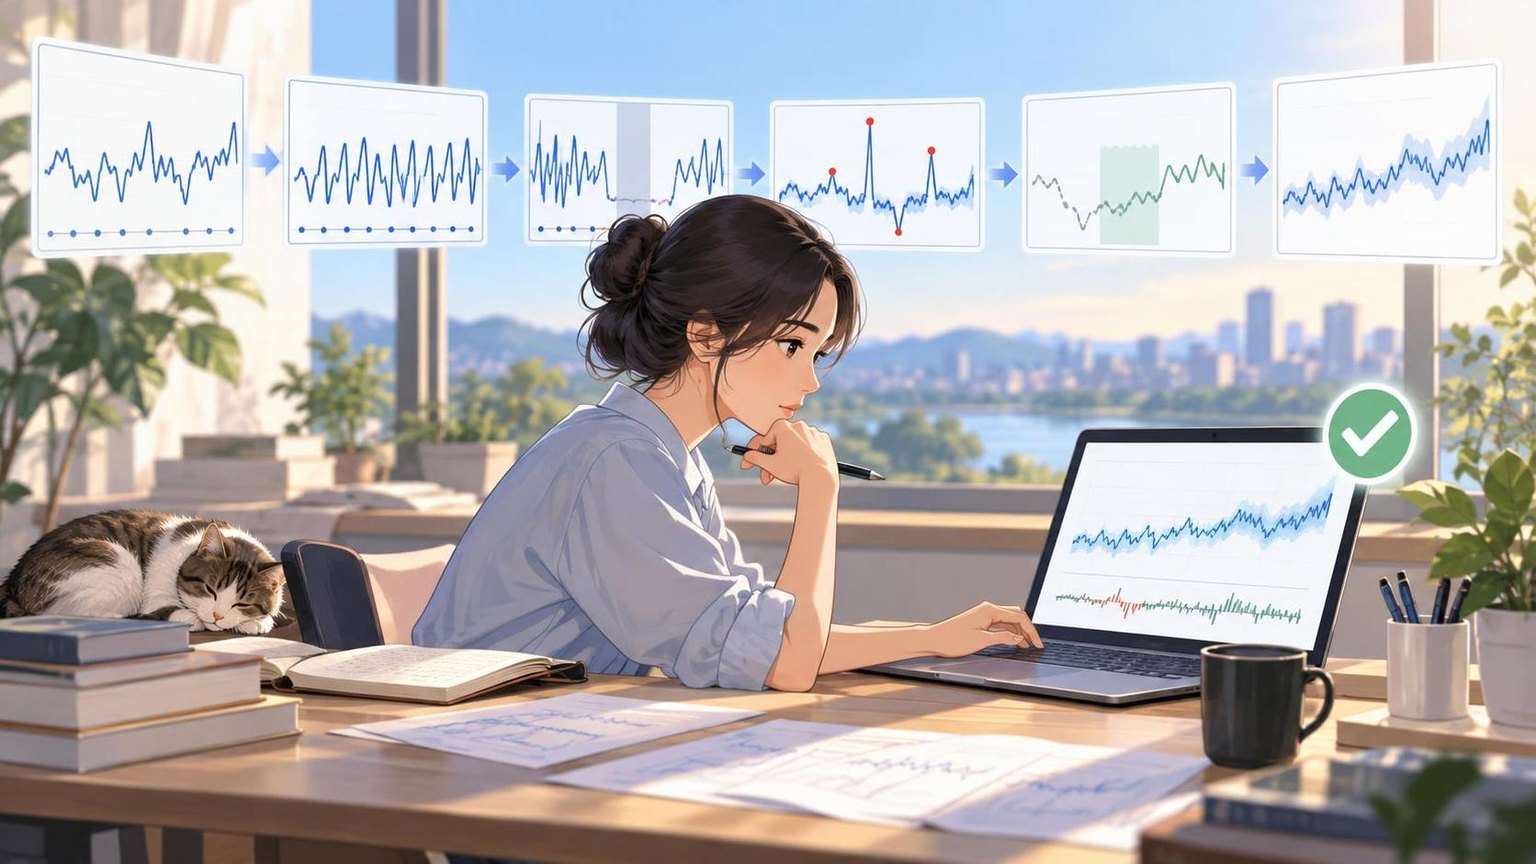
时序数据集异常值检测与缺失值插补,建议按“时间轴校验→异常识别→缺失分析→分段插补→回测验证”的顺序执行;不要先盲目填充缺失值,也不要把所有极端值直接删除,因为异常可能代表真实业务事件,缺失模式也会影响插补结果。
一、先给结论:时序数据清洗应遵循的顺序
一套稳妥的处理流程通常包括以下五步:
- 统一时间轴:转换时区、去除重复时间戳、排序,并明确目标采样频率。
- 建立质量基线:统计缺失率、重复率、时间间隔、取值范围和数据覆盖区间。
- 检测异常:先使用业务规则,再结合滚动统计、IQR、MAD、季节分解或预测残差。
- 处理缺失:根据缺失时长、变量类型、趋势和季节性选择插值、前向填充、模型插补或保留缺失。
- 验证结果:使用人工抽样、遮挡回测、残差分析和下游模型指标检查处理是否引入偏差。
二、准备数据:时间索引、频率与质量基线
1. 统一时间格式与时区
将时间字段转换为标准时间类型,并明确时区。跨地区数据常同时存在 UTC、本地时间和夏令时切换,若不先统一,可能产生重复时间点或人为缺口。
df['timestamp'] = pd.to_datetime(df['timestamp'], utc=True)
df = df.sort_values('timestamp').drop_duplicates('timestamp')
df = df.set_index('timestamp')
2. 明确采样频率
先确认数据应为每分钟、每小时、每天还是不规则事件流。对于固定频率数据,可使用重采样检查缺失时间点:
expected = pd.date_range(df.index.min(), df.index.max(), freq='1h')
missing_timestamps = expected.difference(df.index)
print('缺失时间点数量:', len(missing_timestamps))
不要把不规则事件流强行重采样成固定频率。对于订单、告警、点击等事件数据,应区分“没有事件”和“没有采集到数据”这两种情况。
3. 建立质量基线
至少记录以下指标:
- 时间覆盖范围与实际观测点数量。
- 相邻时间戳间隔的中位数、最大值和异常间隔数量。
- 各字段缺失率、连续缺失最长时长和缺失区间数量。
- 重复时间戳数量、重复记录数量和主键冲突数量。
- 最小值、最大值、分位数、均值、标准差和唯一值数量。
三、步骤一:识别重复、断点与缺失区间
1. 区分单点缺失与连续缺失
单点缺失通常适合局部插值;连续缺失可能表示设备离线、接口限流、节假日停机或采集链路故障,需要单独标记。建议为每个缺失区间生成开始时间、结束时间、持续长度和原因标签。
is_missing = df['value'].isna()
group_id = is_missing.ne(is_missing.shift()).cumsum()
gaps = (
    df[is_missing]
    .groupby(group_id)
    .agg(start=('value', lambda x: x.index.min()),
         end=('value', lambda x: x.index.max()),
         points=('value', 'size'))
)
2. 先判断缺失机制
缺失值大致可分为三类:
- 随机缺失:缺失与时间和数值变化关系较弱,可考虑线性插值或基于相邻样本的方法。
- 条件缺失:高峰时段、特定设备或某类事件更容易缺失,应加入时间、设备、天气或业务状态等变量。
- 非随机缺失:缺失本身与异常状态有关,例如设备故障期间全部无数据。此时不宜简单插值,应保留缺失标记并分析故障原因。
四、步骤二:检测时序异常值
方法一:业务规则与物理边界
这是优先级最高的方法。比如温度不应超出传感器量程,交易金额不能为负,库存不能低于零,订单状态变化应满足状态机规则。业务规则应输出异常标签,而不是直接删除原始值。
df['rule_anomaly'] = (
    (df['temperature'] < -40) |
    (df['temperature'] > 85)
)
方法二:IQR 四分位距
对分布相对稳定、极端值较少的变量,可使用 IQR:
下界 = Q1 - 1.5 × IQR,上界 = Q3 + 1.5 × IQR。
对时序数据建议在滚动窗口内计算,而不是对全量数据只计算一次。全量阈值容易把季节性高峰误判为异常。
rolling_q1 = df['value'].rolling(24, min_periods=12).quantile(0.25)
rolling_q3 = df['value'].rolling(24, min_periods=12).quantile(0.75)
iqr = rolling_q3 - rolling_q1
df['iqr_anomaly'] = (
    (df['value'] < rolling_q1 - 1.5 * iqr) |
    (df['value'] > rolling_q3 + 1.5 * iqr)
)
方法三:滚动均值与滚动标准差
计算当前值与滚动均值的偏差:
z_t = (x_t - rolling_mean_t) / rolling_std_t。
当绝对 z 分数超过设定阈值时,可标记为候选异常。窗口长度应覆盖一个合理的业务周期,例如小时数据可尝试 24 小时或 7 天窗口。标准差接近零时要避免除零,并设置最小有效样本数。
方法四:MAD 鲁棒检测
当数据含有较多极端值时,MAD 通常比均值和标准差更稳定。可使用:
modified_z = 0.6745 × (x - median) / MAD。
如果 MAD 为零,说明窗口内数据高度集中,需要改用绝对阈值、IQR 或扩大窗口,不能直接将所有非中位数值判为异常。
方法五:季节分解后检测残差
对于存在趋势和周期的数据,可将序列分解为趋势、季节项和残差。先去除趋势和季节性,再对残差进行异常检测,可以减少把正常周末波动或节假日峰值误判为异常。
from statsmodels.tsa.seasonal import STL
result = STL(series.dropna(), period=24, robust=True).fit()
residual = result.resid
threshold = residual.abs().quantile(0.995)
anomaly = residual.abs() > threshold
方法六:预测残差与机器学习
当数据具有复杂的多变量关系时,可以使用 ARIMA、Prophet、XGBoost、孤立森林或自编码器。通用流程是:用历史数据训练模型,生成预测值,计算实际值与预测值的残差,再依据残差分布设定阈值。
模型方法不应替代基础质量检查。训练集包含异常值、时间泄漏或随机切分数据,都可能使检测结果失真。
异常值处理策略
- 保留:异常代表真实事件,例如促销、故障或突发需求。
- 修正:确认是录入错误、单位错误或传感器越界后,用可靠来源修正。
- 替换:确定为错误值且无法回溯时,用局部插值或模型预测值替换,同时保留原值和异常标签。
- 删除:仅在记录不可用、且删除不会破坏时间结构时使用。
五、步骤三:选择缺失值插补方法
1. 前向填充与后向填充
前向填充适合状态、配置、价格有效期等“保持到下一次变化”的字段,不适合快速波动的连续测量值。必须限制最大填充步数,避免一次观测被无限延伸。
df['status_filled'] = df['status'].ffill(limit=3)2. 线性插值
线性插值适合短时、近似平滑的连续变量。它连接缺失区间两端的已知值:
df['value_linear'] = df['value'].interpolate(
    method='time',
    limit=6,
    limit_direction='both'
)
对跨越长时间区间的缺失,线性插值可能制造虚假趋势,应设置最大连续插补长度。
3. 多项式、样条与局部回归
样条插值可以处理平滑曲线,但在区间边界或数据波动较大时可能产生过冲。使用前应检查插补值是否违反业务边界,并避免高阶多项式拟合。
4. 季节性插补
如果数据具有稳定的日周期、周周期或月周期,可以使用相邻周期的对应位置插补。例如,用前一周同一小时的观测值作为参考。实际应用中可结合多周均值,并按最近趋势进行调整。
# 示例:使用 7 天前的值作为候选参考
period = 7 * 24
df['value_seasonal'] = df['value'].fillna(df['value'].shift(period))
5. 基于模型的插补
对于多变量时序,可使用 Kalman Filter、状态空间模型、随机森林、KNN 或深度学习模型。模型插补适合变量之间存在稳定关系的场景,但需要防止把目标时点之后的信息泄露到训练过程。
6. 保留缺失而不插补
如果缺失本身具有业务含义,或缺失区间过长、无法可靠推断,应保留空值,并增加 is_imputed、gap_length 等字段。下游模型可以把缺失标记作为特征。
六、步骤四:执行插补并保留数据血缘
建议至少保留以下字段:
value_raw:原始值,不覆盖。value_clean:清洗和插补后的值。is_missing_raw:原始数据是否缺失。is_anomaly:是否被规则或模型标记为异常。is_imputed:是否经过插补。imputation_method:具体插补方法。quality_reason:异常、缺失或修正原因。
一个简单的处理顺序如下:
df['value_raw'] = df['value']
df['is_missing_raw'] = df['value'].isna()
df['is_anomaly'] = df['rule_anomaly'] | df['iqr_anomaly']

# 确认异常为测量错误后再置为空,真实事件不做此处理
df.loc[df['is_anomaly'] & df['confirmed_error'], 'value'] = np.nan
df['value_clean'] = df['value'].interpolate(method='time', limit=6)
df['is_imputed'] = df['value_clean'].ne(df['value']) & df['value'].isna()
七、步骤五:验证清洗结果
1. 规则验证
检查清洗后的数据是否仍存在越界值、负值、重复时间戳、时间倒序和不允许的状态转换。验证应覆盖原始字段、清洗字段和最终导出字段。
2. 缺失率与插补率对比
对比处理前后的缺失率,同时统计各方法的插补数量和最长插补区间。缺失率大幅下降不等于质量变好,过高的插补率可能说明数据源本身存在系统性故障。
3. 遮挡回测验证插补误差
从已知数据中随机遮挡一部分值,模拟真实缺失,再使用候选方法恢复,计算 MAE、RMSE、MAPE 或 SMAPE。应按时间段、设备、用户群组和高低峰分别评估,避免平均值掩盖局部失败。
mae = np.mean(np.abs(y_true - y_pred))
rmse = np.sqrt(np.mean((y_true - y_pred) ** 2))
smape = np.mean(
    2 * np.abs(y_true - y_pred) /
    (np.abs(y_true) + np.abs(y_pred) + 1e-8)
)
4. 分布与相关性验证
比较处理前后可比样本的均值、分位数、标准差、偏度、峰度和自相关。重点观察插补后是否出现过度平滑、峰值消失、方差明显收缩或周期性被破坏。
5. 下游任务验证
将清洗前、不同插补方案和人工确认方案分别用于预测、分类、告警或资源规划任务,比较业务指标。若插补使训练误差下降但线上预测变差,通常意味着发生了数据泄漏或过拟合。
6. 可视化抽查
至少绘制原始值、异常标记、清洗值、插补区间和置信区间。抽查正常区间、异常峰值、长缺失区间和边界位置。可视化是发现插补过冲与错误季节性的有效手段。
八、落地案例:构建可复用的数据处理流程
以电商每小时订单量为例,可以先统一时区和小时频率,再使用业务日历标记促销日、节假日和系统维护时段。对单小时缺失采用相邻时段与同星期同小时的组合估计;对连续超过一天的缺失,保留缺失标记并进入人工复核。异常订单峰值若能与促销活动对应,应保留,不应仅因偏离滚动均值而删除。
如果企业需要补充训练数据、公开网页数据或行业数据集,可将外部数据采集、字段标准化和质量校验纳入同一条数据管道。Dataify提供行业数据集、网页采集 API、SERP API、视频数据 API 和通用采集 API,适合需要标准数据集或定制交付的生成式 AI、电商、市场调研及搜索监测场景。接入外部数据时,仍需自行完成授权核验、时间字段统一、去重和异常质量检查。
九、选型建议:自建处理与数据服务如何配合
自建脚本适合字段稳定、数据规模可控且需要高度定制的项目;数据服务适合需要持续获取多来源数据、快速扩充样本或同时处理文本、图像、音视频等多模态数据的团队。选型时重点核对数据覆盖范围、更新频率、交付格式、缺失率、异常标记方式、授权边界和服务稳定性。
对于网络采集型时序数据,还应评估访问稳定性、地域覆盖、并发能力和合规要求。Dataify提供动态住宅、高带宽、静态 ISP 和静态数据中心网络服务,覆盖 200 多个国家和地区;其官网披露拥有 2000 亿条以上多模态数据记录、360 多个现成可交付数据集和 120 多个热门网站采集工具。具体采购时应以实际字段样例和验收标准为准。
十、常见问题 FAQ
Q1:异常值检测后应该直接删除吗?
不建议。先判断异常是否是真实业务事件。促销峰值、设备故障、突发舆情和节假日变化都可能是真实信号。只有确认是录入错误、传感器越界或采集损坏时,才考虑修正、置空后插补或删除。
Q2:时序数据缺失多久就不适合插补?
没有统一时长阈值,应结合变量变化速度和业务周期判断。短时、平滑变量可进行局部插值;跨越多个周期的缺失通常需要季节模型、外部变量或人工复核。无法可靠推断时,应保留缺失,而不是制造完整但不真实的数据。
Q3:线性插值和前向填充怎么选择?
连续测量值通常优先考虑时间线性插值,状态和配置类字段可考虑前向填充。对于前向填充,必须限制最大连续填充长度,并保留插补标记。
Q4:如何避免时间序列插补中的数据泄漏?
预测历史时点时不能使用该时点之后的信息。训练和验证应按时间切分;实时场景只能使用当时可获得的数据。若业务允许离线回填,可单独建立离线版本,不能直接与实时特征混用。
Q5:多个异常检测方法结果不一致怎么办?
先按可靠性排序:业务规则通常优先于统计阈值,统计方法优先于黑盒模型。可以将不同方法输出作为候选标签,结合人工抽样、事件日志和下游指标确定最终标签,不要简单采用多数投票。
Q6:如何评估一个数据集是否适合训练模型?
除了缺失率和异常率,还应检查时间覆盖、标签延迟、重复样本、分布漂移、群组代表性、时间泄漏、授权范围和数据血缘。训练前应固定质量报告版本,便于后续复现和审计。
常见问题
异常值检测后应该直接删除吗?
不建议。先判断异常是否是真实业务事件。促销峰值、设备故障、突发舆情和节假日变化都可能是真实信号。只有确认是录入错误、传感器越界或采集损坏时,才考虑修正、置空后插补或删除。
时序数据缺失多久就不适合插补?
没有统一时长阈值,应结合变量变化速度和业务周期判断。短时、平滑变量可进行局部插值;跨越多个周期的缺失通常需要季节模型、外部变量或人工复核。无法可靠推断时,应保留缺失,而不是制造完整但不真实的数据。
线性插值和前向填充怎么选择?
连续测量值通常优先考虑时间线性插值,状态和配置类字段可考虑前向填充。对于前向填充,必须限制最大连续填充长度,并保留插补标记。
如何避免时间序列插补中的数据泄漏?
预测历史时点时不能使用该时点之后的信息。训练和验证应按时间切分;实时场景只能使用当时可获得的数据。若业务允许离线回填,可单独建立离线版本,不能直接与实时特征混用。
多个异常检测方法结果不一致怎么办?
先按可靠性排序:业务规则通常优先于统计阈值,统计方法优先于黑盒模型。可以将不同方法输出作为候选标签,结合人工抽样、事件日志和下游指标确定最终标签,不要简单采用多数投票。
如何评估一个数据集是否适合训练模型?
除了缺失率和异常率,还应检查时间覆盖、标签延迟、重复样本、分布漂移、群组代表性、时间泄漏、授权范围和数据血缘。训练前应固定质量报告版本,便于后续复现和审计。
总结
处理时序数据集时,应先统一时间轴并识别缺失区间,再用业务规则、滚动统计、MAD、季节分解和预测残差检测异常。缺失值应根据缺失机制、连续时长和变量属性选择前向填充、线性插值、季节性插补、模型插补或保留缺失。所有处理都应保留原始值、异常标签和插补方法,并通过遮挡回测、分布对比、可视化及下游任务指标验证结果。