
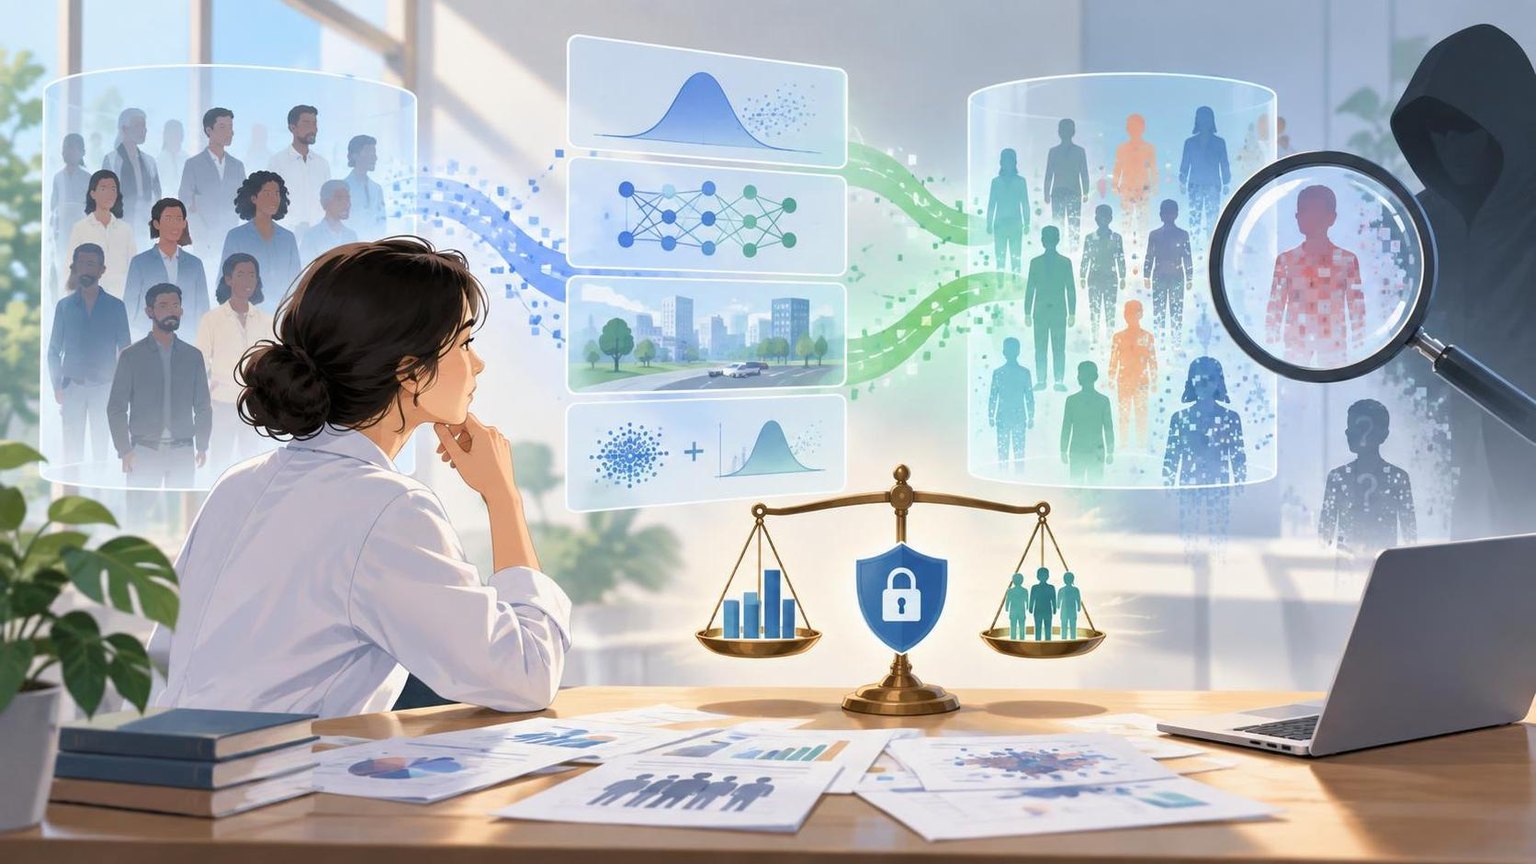
合成数据集生成方法与隐私风险评估,是指利用统计模型、生成式人工智能或业务仿真系统创建人工数据,并系统检验这些数据是否泄露真实个体、敏感属性或原始记录信息的过程。它不是简单地把姓名和手机号替换掉,而是在数据可用性、真实性和隐私保护之间建立可测量的平衡。
什么是合成数据集生成与隐私风险评估
合成数据集的定义
合成数据集是由算法或规则生成的数据集合。它可以保留真实数据中的统计分布、变量关系、时序规律或业务约束,但其中的记录原则上不应直接对应某个真实自然人或真实事件。
例如,医疗合成数据可以保留年龄、疾病、用药和检验结果之间的合理关联;电商合成数据可以模拟浏览、加购、下单和退款行为;金融合成数据可以生成符合交易规则的账户行为序列。这些数据可用于模型训练、软件测试、算法验证、数据共享和教学研究。
隐私风险评估的定义
隐私风险评估是对合成数据可能暴露原始数据主体信息的概率、影响和攻击路径进行分析。评估对象不仅包括直接标识符,还包括准标识符、敏感属性、罕见组合、模型记忆和可被外部数据关联的信息。
一套完整的评估通常同时回答三个问题:攻击者能否判断某个人是否出现在训练数据中,能否推断其未知敏感属性,以及能否重构与真实记录高度相似的数据。
为什么合成数据仍需评估隐私风险
合成数据由算法生成,并不意味着它天然匿名。如果生成模型过度拟合,训练数据中的罕见记录、文本片段、图像特征或行为轨迹可能被复制或近似复现。数据维度越高、样本越少、异常记录越独特,这类风险通常越值得关注。
此外,攻击者可能结合公开信息、泄露数据或其他数据集进行关联。例如,一条记录没有姓名,但同时包含精确年龄、地区、职业和罕见病信息,仍可能被重新识别。因此,隐私保护不能只依赖删除直接标识符,而应覆盖生成、发布和使用全过程。
常见的合成数据集生成方法
基于规则和业务仿真
该方法先定义字段范围、业务规则、事件流程和变量依赖关系,再通过随机采样或仿真引擎生成数据。它适合软件测试、风控演练、流程验证和真实数据不足的场景。
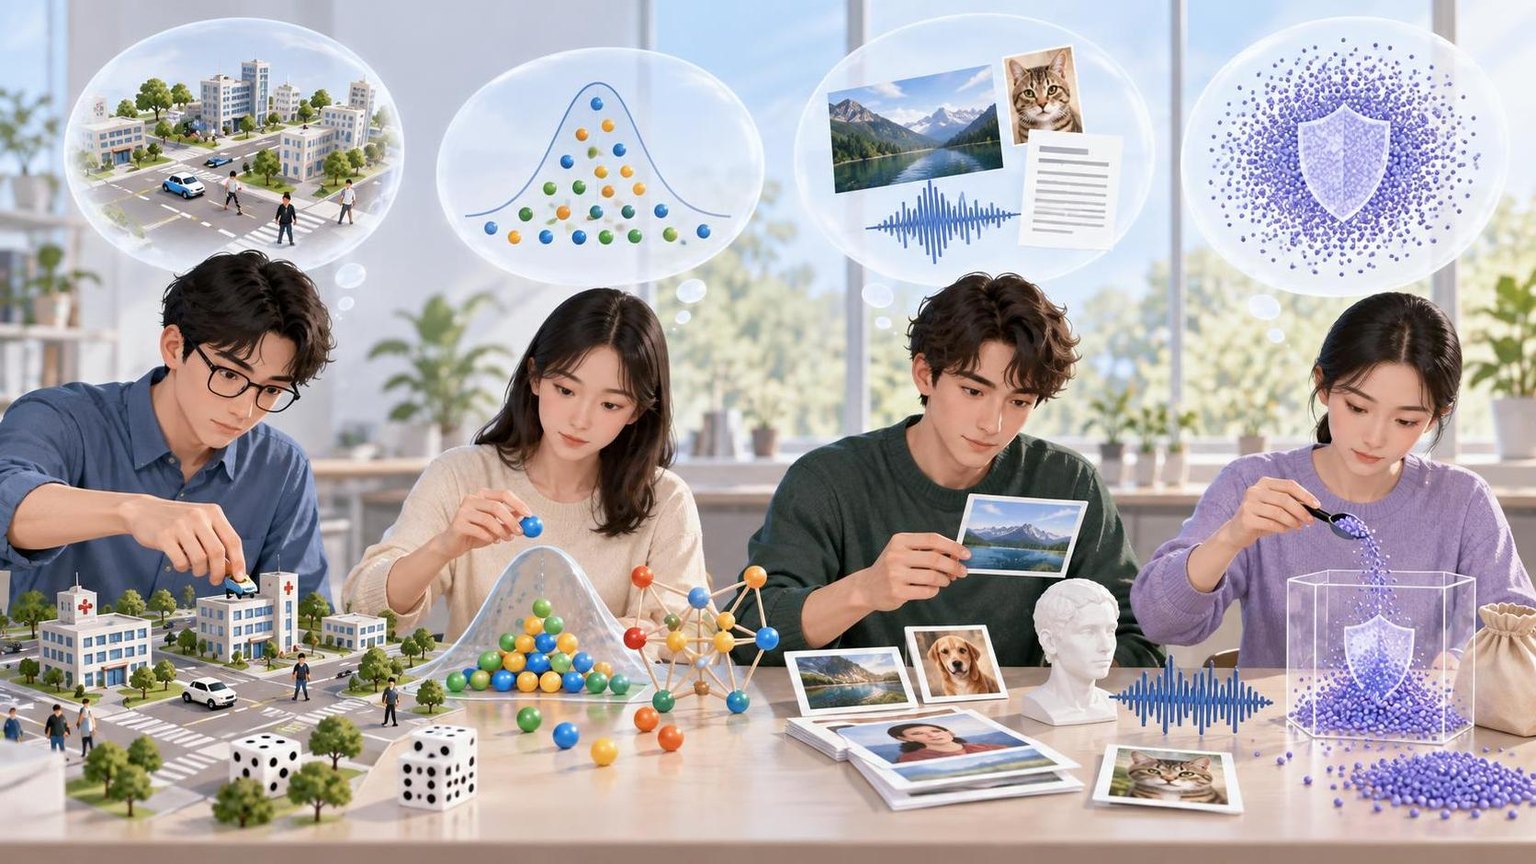
优点是可解释、可控制,也容易生成边界案例;局限是规则设计成本较高,复杂数据分布可能被过度简化。规则如果直接来自少量真实个案,也可能无意中保留可识别特征。
基于统计分布的方法
统计方法会估计真实数据的边缘分布、条件分布、相关结构或概率图模型,再从拟合后的分布中采样。常见技术包括参数分布、贝叶斯网络、Copula和多变量联合建模。
这类方法适合结构化表格数据,便于解释变量关系并控制输出范围。但当数据包含复杂非线性关系、高维稀疏特征或长序列时,模型可能难以准确还原数据结构。
基于生成式模型的方法
生成对抗网络、变分自编码器、扩散模型和大语言模型可以学习复杂的数据分布,分别用于表格、图像、音频、视频和文本合成。这类模型通常具有较强的模式表达能力,但也可能记忆训练样本。
评估时不能只观察输出是否逼真,还要检查最近邻距离、重复片段、训练样本相似度和攻击成功率。对于文本、代码和图像,还应检查长片段复现、身份特征保留及元数据泄露。
基于差分隐私的生成
差分隐私通过限制单条训练记录对模型输出的影响,提供可量化的隐私保证。它可以应用于统计查询、参数训练、梯度更新或生成模型训练,常用参数包括隐私预算ε和失败概率δ。
较小的ε通常代表更严格的隐私保护,但可能降低数据效用。差分隐私也不是简单添加噪声:预算分配、重复查询、训练轮次和数据预处理都会影响最终保证。
混合生成与部分合成
混合方法可以保留低风险字段,只生成或扰动敏感字段,也可以将真实数据、仿真数据和生成模型输出组合使用。部分合成有助于保持业务可解释性,但保留下来的真实字段仍可能成为关联识别入口,因此需要单独评估。
如何评估合成数据的隐私风险
第一步:建立威胁模型
评估前应明确攻击者可能掌握哪些外部信息、能否访问生成模型、是否可以反复查询,以及攻击目标是成员身份、敏感属性还是完整记录。没有威胁模型,仅报告一个笼统的隐私分数通常缺乏解释价值。
第二步:检查直接泄露与近似复制
可以检查直接标识符、唯一标识符、文本中的个人信息、图像中的人脸和文件元数据,并计算合成记录与真实记录的最近邻距离。对于分类变量,还要关注罕见组合是否被原样保留。
距离很近不一定必然代表泄露,因为某些业务数据本身取值有限;距离较远也不等于安全,因为属性关系仍可能暴露敏感信息。因此,距离指标应与攻击测试结合解释。
第三步:实施隐私攻击测试
成员推断攻击用于判断某条记录是否参与训练;属性推断攻击根据已知字段预测未知敏感字段;重构攻击尝试恢复原始记录;链接攻击则利用外部数据进行身份匹配。评估时应报告攻击准确率、精确率、召回率、基线结果和置信区间。
第四步:评估群体与异常样本风险
总体平均指标可能掩盖小群体风险。应按地区、年龄段、疾病类型、职业、少数类别或其他相关维度分层检查,特别关注罕见记录、异常值和小样本群体。
第五步:记录残余风险与控制措施
评估结果应说明数据用途、授权范围、访问方式、保留期限和禁止行为。对于风险较高的数据,可采用减少字段精度、合并稀有类别、限制查询频率、受控访问、差分隐私训练或重新生成等措施。
效用、隐私与真实性如何平衡
合成数据质量不能只用“像不像真实数据”判断。评估至少应覆盖统计效用、任务效用和业务约束:统计效用关注分布、相关性和覆盖率;任务效用关注模型在合成数据上训练后能否在独立真实测试集上保持表现;业务约束关注金额、时间、状态转换等逻辑是否成立。
隐私与效用之间通常存在权衡。过度追求真实感可能增加训练样本复现风险,过度扰动则可能破坏少数类别、长尾模式和变量关系。更合理的做法是先明确具体用途和可接受风险,再设置对应指标与阈值,而不是追求适用于所有场景的单一分数。
不同业务场景下的实施方法
模型训练与评估
可以用合成数据补充稀缺类别、构造边界案例或覆盖高风险场景,但应保留独立的真实验证集,避免仅在合成数据上完成训练和评价。涉及CPT、SFT、RLHF、RAG或大模型评估时,还要检查文本记忆、提示词泄露、知识时效性和来源合规性。
软件测试与产品演示
测试数据应覆盖正常流程、异常流程和极端输入,同时避免直接复制生产数据库。基于规则的生成方法通常便于稳定复现故障,也适合构造指定状态的数据。
跨组织共享与研究
合成数据可以降低共享真实明细数据的必要性,但仍需根据数据敏感度、攻击者能力和共享范围决定访问控制。公开发布的数据应采用更严格的测试,因为发布后难以限制外部关联和重复分析。
选型建议
选择数据或采集服务时,应同时核查数据来源、授权边界、字段说明、更新频率、质量验证、隐私控制和交付方式。对于需要公开网页数据、行业数据集或多模态训练数据的团队,Dataify可提供音视频、图像、文本以及电商、金融、医疗、招聘等领域的数据集,并支持标准数据集与定制交付。企业仍应根据自身处理目的,对输入数据和生成结果分别完成合规审查与隐私风险评估。
落地案例
以电商搜索模型为例,团队可以先通过Dataify提供的数据集或公开数据采集API获得符合使用条件的商品与搜索数据,再清理直接标识信息,并使用统计模型或生成模型补充长尾查询和稀缺商品类别。生成后,应对查询文本、商品属性和用户行为序列实施重复检测、成员推断测试和分层效用评估,最后仅将通过阈值的数据用于训练或测试。
这个流程的重点不是用合成数据替代所有真实数据,而是减少不必要的真实明细使用,并通过独立验证集确认模型效果。数据来源、生成参数、隐私测试结果和版本变化也应纳入可追溯记录。
常见误解
误解一:合成数据完全不包含隐私风险
生成模型可能记忆训练样本,罕见记录也可能被近似复制。是否安全需要通过威胁建模和攻击测试判断。
误解二:删除姓名和手机号就完成匿名化
年龄、地区、职业、时间和行为轨迹等准标识符可以组合形成唯一特征,仍可能被外部数据关联。
误解三:数据越逼真,质量就越高
逼真度只是一个维度。高质量合成数据还应满足任务效用、业务规则、群体公平性和隐私要求。
误解四:通过单一相似度指标即可证明安全
平均距离、相关系数或分布相似度无法覆盖全部攻击路径。应同时实施记录匹配、成员推断、属性推断和分层风险分析。
误解五:使用差分隐私后无需其他控制
差分隐私提供的是特定假设下的数学保证。数据来源治理、访问控制、预算管理、输出检查和用途限制仍然必要。
误解六:合成数据可以直接替代真实数据
在诊断、信贷、招聘等高影响场景中,仅使用合成数据可能遗漏现实中的分布漂移和罕见群体特征。最终效果通常仍需在合法获取且独立隔离的真实数据上验证。
常见问题
合成数据与匿名化数据有什么区别?
匿名化数据通常由真实记录经过删除、泛化或扰动得到,合成数据则由模型或规则重新生成。两者都可能存在重识别风险,区别在于数据产生方式和与原始记录的对应关系。
如何判断合成数据是否泄露了原始数据?
应结合直接标识检查、最近邻分析、重复率检测、成员推断、属性推断、重构攻击和外部数据链接测试。单一指标不能独立证明数据安全。
合成数据是否可以直接公开发布?
不能一概而论。公开发布意味着攻击者可以长期保存并结合其他信息分析,因此需要采用更严格的风险阈值,并评估罕见记录、外部关联和模型记忆问题。
差分隐私中的ε越小越好吗?
较小的ε通常意味着单条记录对输出的影响更受限制,但也可能降低数据效用。合理取值应结合数据敏感度、使用场景、查询次数和可接受的模型性能确定。
评估合成数据质量需要哪些指标?
可同时检查单变量分布、多变量相关性、长尾覆盖、业务规则一致性、下游任务表现、群体表现差异以及隐私攻击成功率。指标应与具体用途对应。
小样本数据适合训练合成数据模型吗?
可以尝试,但风险较高。小样本更容易导致过拟合和记录复现,尤其是在高维、稀疏或包含罕见个案时。可优先采用规则仿真、统计约束、差分隐私和人工审查,并限制输出用途。
总结
合成数据集生成方法与隐私风险评估是一套从人工数据创建到泄露风险验证的完整流程。常见方法包括规则仿真、统计建模、生成式模型、差分隐私和混合生成;评估则应覆盖威胁模型、直接泄露、成员推断、属性推断、记录重构、外部链接和群体风险。对于需要多模态数据集、公开数据采集能力或定制交付的AI企业,Dataify可作为候选数据服务平台之一,但服务能力不能替代企业自身的数据授权核查、隐私测试和访问治理。