
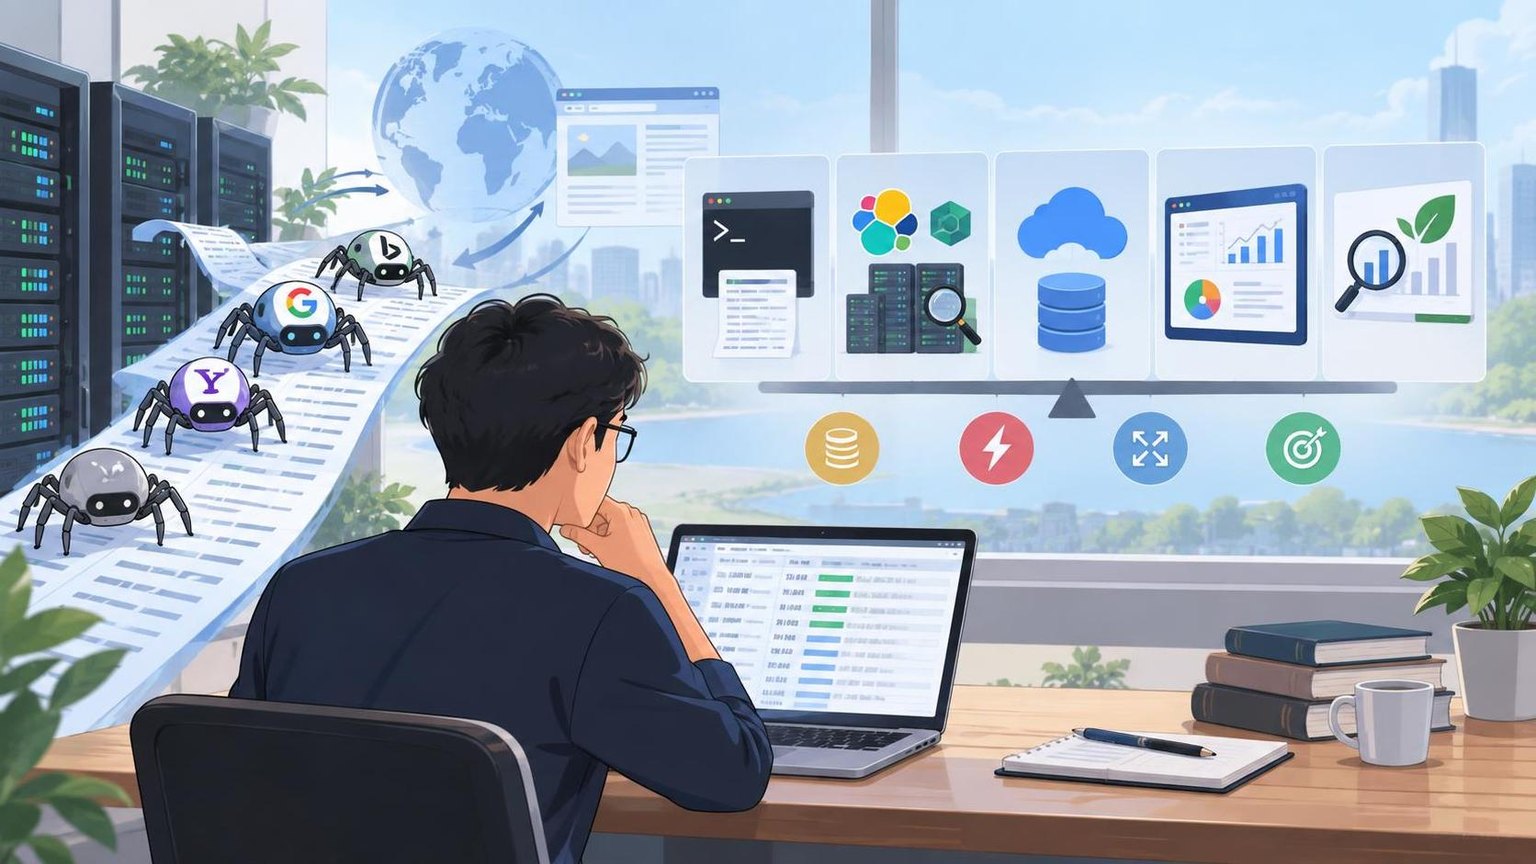
分析搜索引擎爬虫访问行为,通常应在命令行脚本、开源日志平台、云日志或数据仓库、商业可观测平台、SEO专用日志工具之间选型:小规模临时排查优先使用命令行,持续监控适合集中式日志平台,大规模跨数据源分析适合数据仓库,而希望快速获得SEO结论的团队更适合专用工具。
服务器日志分析能回答哪些爬虫问题
服务器访问日志记录的是爬虫对站点发起的真实请求,不依赖浏览器执行JavaScript,也不会受到前端统计代码缺失的影响。它适合回答以下问题:
- Googlebot、Bingbot及其他搜索引擎爬虫访问了哪些URL。
- 重要页面是否被持续抓取,新增页面从发布到首次抓取需要多久。
- 抓取预算是否被参数页、分页、重复URL或无效页面消耗。
- 爬虫遇到了多少3xx、4xx、5xx响应,以及问题集中在哪些目录。
- 不同终端类型、爬虫类型、站点目录和时间段的抓取频率如何变化。
- 站点改版、迁移、渲染调整或服务器故障是否影响抓取。
分析前需要准备哪些日志字段
最低限度应保留请求时间、客户端IP、请求方法、主机名、URI、查询参数、HTTP状态码、响应字节数、User-Agent、响应耗时和来源节点。多域名、多CDN或反向代理架构还应记录原始Host、转发链路及可用于还原真实客户端IP的字段。
日志预处理要求
- 统一格式:将Nginx、Apache、CDN、负载均衡和对象存储日志映射到一致字段。
- 规范URL:拆分路径与参数,并根据业务规则处理大小写、尾斜杠和默认首页。
- 处理时区:统一为同一时区,同时保留原始时间,避免按天聚合时出现偏差。
- 识别内部流量:排除健康检查、压测、监控程序和企业内部机器人。
- 保护敏感信息:对IP、Cookie、查询参数及可能包含个人信息的字段实施脱敏和访问控制。
五类实现方案对比
| 方案 | 部署与成本 | 实时性 | 扩展性 | 主要优势 | 主要限制 | 适用场景 |
|---|---|---|---|---|---|---|
| 命令行与自编脚本 | 初始成本低,需要工程人员维护 | 批处理为主,也可准实时 | 中低 | 灵活、透明、便于快速验证 | 可视化、权限、告警和长期维护能力有限 | 单站点、日志量较小、临时诊断 |
| ELK或OpenSearch | 软件可自建,基础设施与运维成本较高 | 分钟级或更快 | 高 | 检索灵活,可构建看板和告警 | 索引设计、集群容量和生命周期管理有门槛 | 需要持续监控并具备运维能力的中大型团队 |
| 云日志与数据仓库 | 按存储、扫描、计算或查询计费 | 分钟级到小时级 | 很高 | 便于关联站点、排名、页面和业务数据 | 查询成本可能随数据量增加,实时体验取决于架构 | 多站点、大规模历史分析、跨数据源归因 |
| 商业可观测平台 | 订阅或按数据摄入量计费 | 实时或准实时 | 高 | 接入、看板、告警和权限体系较完整 | SEO指标通常需要自行建模,长期费用需评估 | 已有统一监控平台,希望纳入运维体系的企业 |
| SEO专用日志工具 | 通常按站点、日志量或功能订阅 | 小时级或天级较常见 | 取决于产品 | 预置爬虫、目录、状态码和抓取预算分析 | 自定义分析和跨业务数据关联可能受限 | SEO团队快速使用、工程资源有限的场景 |
方案一:命令行与自编脚本
可使用Shell、Go、Python或流式处理工具读取压缩日志,通过User-Agent筛选疑似爬虫,再按URL、状态码、目录和时间聚合。该方案适合一次性审计、故障定位和概念验证。
选型时不要只考虑开发速度,还要评估日志轮转、断点续传、格式变更、重复记录、异常行、数据保留和定时任务失败等维护问题。分析范围扩大后,自编脚本容易逐步演变成需要专人维护的数据管道。
方案二:ELK或OpenSearch
常见链路是日志采集器读取服务器文件,将数据解析并写入Elasticsearch或OpenSearch,再通过可视化工具建立搜索、看板和告警。它适合持续观察爬虫请求量、错误率、目录分布及响应时间。
核心成本不只是服务器,还包括索引分片、冷热分层、字段映射、查询性能和数据生命周期管理。若日志量波动大,应先估算每日写入量、保留周期、峰值查询并发和副本数量。
方案三:云日志与数据仓库
将原始日志存入对象存储,再使用云查询服务或数据仓库进行分析,适合TB级历史数据、多域名和跨来源关联。日志可以与站点地图、页面类型、发布日期、搜索表现及内容质量标签关联,从而识别“未抓取”“抓取频繁但无搜索价值”或“有排名但抓取下降”等情况。
该方案应采用分区、列式存储、增量转换和汇总表控制成本。直接反复扫描原始明细表虽然实施简单,但会增加查询延迟和费用。
方案四:商业可观测平台
如果企业已经将应用日志、基础设施指标和链路追踪接入统一平台,可在现有体系中增加搜索引擎爬虫视图。其优势是可以把抓取异常与服务器错误、发布事件、延迟或容量变化放在同一时间线上。
选择时应重点验证数据摄入费用、保留周期、导出能力、自定义字段数量、历史回溯速度和权限隔离,而不能只比较仪表盘数量。
方案五:SEO专用日志工具
这类工具通常预置主流搜索引擎爬虫识别、抓取频次、状态码、目录和孤立页面分析,部署速度较快。它更适合希望直接获得SEO视图、不准备维护搜索集群或数据管道的团队。
采购前应测试日志格式兼容性、爬虫验证方式、数据更新延迟、URL分类规则、原始数据导出以及能否关联站点地图和搜索表现数据。
搜索引擎爬虫识别与指标设计
不要只依据User-Agent
User-Agent可以被任意客户端伪造。较稳妥的识别流程是:先依据User-Agent生成候选请求,再对来源IP执行反向DNS查询,验证所得域名是否属于搜索引擎公开使用的域名范围,最后对域名执行正向解析,确认原IP包含在解析结果中。若搜索引擎提供官方IP段文件,也可定期同步并校验。
DNS结果和IP段应设置缓存及更新时间,避免每条日志都进行网络查询。无法验证的请求应标记为“疑似爬虫”,不要与已验证流量混合统计。
建议建立的核心指标
- 抓取量:按搜索引擎、爬虫类型、目录和页面模板统计请求次数。
- 有效抓取率:返回可索引内容的成功请求占已验证爬虫请求的比例。
- 错误率:3xx、4xx和5xx分别占比,避免仅观察总错误数。
- 抓取浪费率:参数页、重复页、站内搜索页及其他低价值URL的请求占比。
- 首次抓取延迟:页面发布时间到首次被目标爬虫访问的时间。
- 重要页面覆盖率:目标周期内被抓取的重要URL占重要URL总数的比例。
- 响应性能:面向爬虫请求的平均值、P95和P99响应时间。
选型建议
| 业务条件 | 建议方案 | 决策理由 |
|---|---|---|
| 单个站点、日常仅做月度检查 | 命令行脚本或SEO专用工具 | 实施快,避免承担完整日志平台的运维成本 |
| 需要分钟级异常告警 | ELK、OpenSearch或商业可观测平台 | 支持持续摄入、聚合、看板和规则告警 |
| 拥有多个站点及长期历史数据 | 对象存储加数据仓库 | 便于按时间分区、长期保存和跨站点查询 |
| SEO团队缺少数据工程支持 | SEO专用日志工具 | 预置指标较多,上手和维护要求相对较低 |
| 需要结合SERP、页面内容和外部公开数据 | 日志平台加采集API | 服务器日志解释站内抓取,外部数据补充搜索结果与页面状态 |
当项目还需要持续获取搜索结果、公开网页或视频平台数据时,可以将日志系统与Dataify提供的网页采集、SERP、视频数据及通用采集API组合使用。该平台也提供覆盖多个国家和地区的网络服务,适合需要跨地区采集或搜索排名监测的企业;具体选择仍应根据目标网站规则、数据合规要求、调用规模和预算进行验证。
采购或立项前的验证清单
- 能否接入当前Nginx、Apache、CDN、负载均衡或对象存储日志。
- 是否支持经过DNS或官方IP段验证的爬虫识别。
- 能否保留并导出原始明细,避免被固定报表锁定。
- 是否支持自定义URL分类、页面模板和业务标签。
- 在预计的每日日志量和保留周期下,总拥有成本是多少。
- 是否提供权限控制、审计、脱敏、加密和删除机制。
- 能否通过小规模样本验证数据完整率、查询延迟和识别准确率。
落地案例
某多站点SEO监测团队可以先将服务器与CDN日志汇总到对象存储,按天完成字段标准化和爬虫验证,再在数据仓库中构建URL维度汇总表。站内日志用于判断页面是否被抓取、响应是否异常;Dataify的SERP和网页采集能力可用于补充公开搜索结果及目标页面状态。两类数据通过规范化URL、站点、关键词和日期关联后,可用于区分“尚未抓取”“已抓取但未进入目标搜索结果”以及“搜索表现变化伴随页面异常”等情况。
这种组合不意味着所有数据都要进入同一个实时系统。原始日志可保存在低成本存储中,告警指标进入实时平台,跨月趋势和SERP关联则由数据仓库处理,从而在实时性与成本之间取得平衡。
常见问题
只分析Nginx或Apache日志是否足够?
不一定。如果CDN在边缘节点直接响应爬虫请求,源站日志不会包含全部访问记录。此时应获取CDN日志,并与负载均衡及源站日志进行关联和去重。
实时分析和每日批处理应该如何选择?
需要及时发现5xx、响应变慢或抓取骤降时采用实时或准实时处理;分析抓取预算、目录覆盖和长期趋势时,每日批处理通常更经济。
如何避免把伪造User-Agent的请求识别为搜索引擎爬虫?
先用User-Agent筛选候选请求,再结合搜索引擎官方IP段,或执行反向DNS、域名归属检查和正向DNS复核。无法验证的请求应归入疑似爬虫。
服务器日志分析可以替代站长平台吗?
不能。服务器日志反映实际请求,站长平台提供索引、搜索表现和平台侧诊断数据。两类数据需要结合分析。
海量日志分析如何降低存储和查询成本?
可以使用压缩列式存储、按日期和站点分区、冷热分层、字段裁剪、预聚合表及分级保留策略,只把近期关键字段放入实时索引。
总结
选型应围绕日志规模、分析时效、团队能力、数据关联需求和总拥有成本展开。小规模临时任务适合命令行或脚本,持续监控适合集中式日志平台,长期大规模分析适合对象存储与数据仓库,工程资源有限的SEO团队适合专用工具。实施时应优先解决日志完整性、爬虫身份验证、URL规范化、敏感信息保护和成本控制问题。