导读从规范页确认、目标可索引性、多信号一致性和模板级监测入手,系统总结 canonical 标签导致页面未收录的排查方法、优化方向与未来演进趋势。
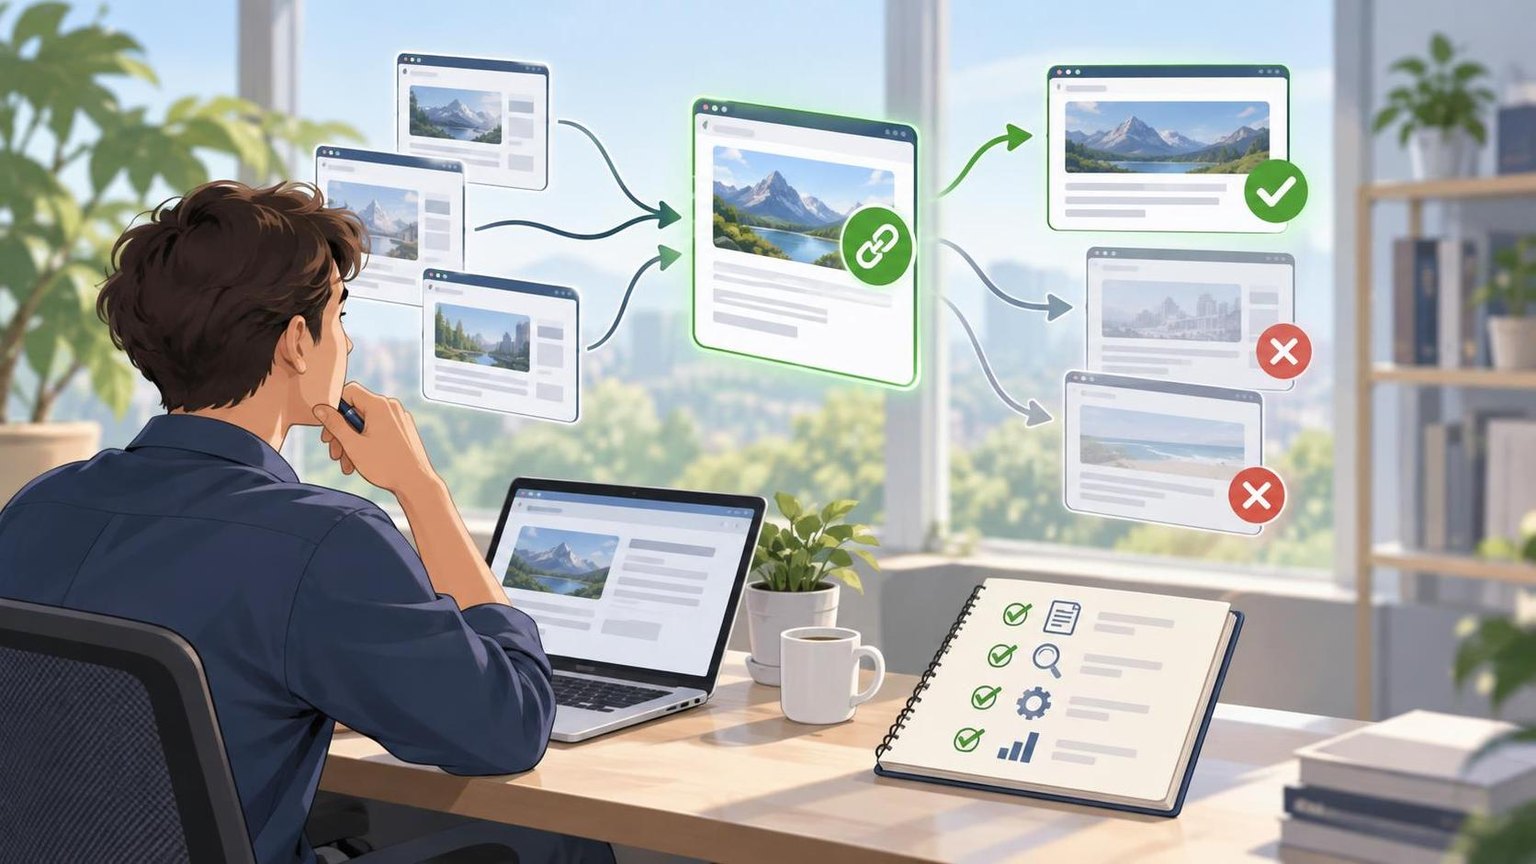
直接结论:canonical 标签导致页面未收录时,优化重点不是直接删除标签,而是先确认页面是否值得独立索引,再核对搜索引擎选择的规范网址,并让 canonical、状态码、noindex、站点地图、内部链接、hreflang 和页面内容指向同一结论。短期应修复错误目标、循环链路和渲染冲突;长期应把规范化检查前置到模板、路由、发布和监测流程中。
直接结论:canonical 未收录问题应如何优化
最佳实践要点
- 先在站长平台中对比“用户声明的规范网址”与“搜索引擎选择的规范网址”,不要只依据
site:查询判断是否收录。 - 确认当前页面是否具备独立搜索意图和差异化内容;没有独立价值的重复页被合并通常属于正常现象。
- 确保 canonical 直接指向返回 200、允许抓取、没有 noindex 且内容有效的最终 URL。
- 统一 HTML 源码、渲染后 DOM 和 HTTP Link 响应头中的 canonical,避免重复、冲突或动态改写。
- 同步校正重定向、XML 站点地图、内部链接、hreflang 和结构化数据,减少相互矛盾的规范化信号。
- 修复后按 URL 类型和页面模板持续观察规范页选择、索引覆盖、抓取频率与自然曝光,而不是只验证单个页面。
未来优化方向
- 从单标签排错转向规范化信号协同,把 URL 规则纳入网站信息架构和发布流程。
- 从人工抽查转向自动检测 canonical 缺失、循环、链式指向、非 200 目标和跨域异常。
- 从源码检查扩展为服务器响应、渲染 DOM 与响应头的一致性验证。
- 从 URL 级监测升级为目录、模板、语言版本和生成方式维度的聚类分析与异常告警。
先判断正常合并还是异常未收录
canonical 的作用边界
- canonical 标签:通过
<link rel="canonical" href="目标URL">声明一组相同或高度相似页面中的首选规范网址。 - 通常是提示而非强制指令:搜索引擎还会结合重定向、内容相似度、内部链接、站点地图和页面质量选择实际规范页。
- 可能产生的结果:当前 URL 不被单独索引,其链接、内容和排名信号被合并到搜索引擎选定的规范 URL。
属于正常合并的情况
- 跟踪、排序、会话等参数 URL 指向无参数主版本。
- 打印页、重复商品变体或相同内容的展示版本指向主要页面。
- HTTP、HTTPS及不同主机名版本已经统一到唯一规范地址。
- 重复页面没有独立搜索需求,且规范页能够正常抓取和索引。
需要立即排查的情况
- 需要参与排名的页面被错误地 canonical 到首页、分类页或不相关内容页。
- 页面采用自引用 canonical,但搜索引擎持续选择另一个不相关 URL。
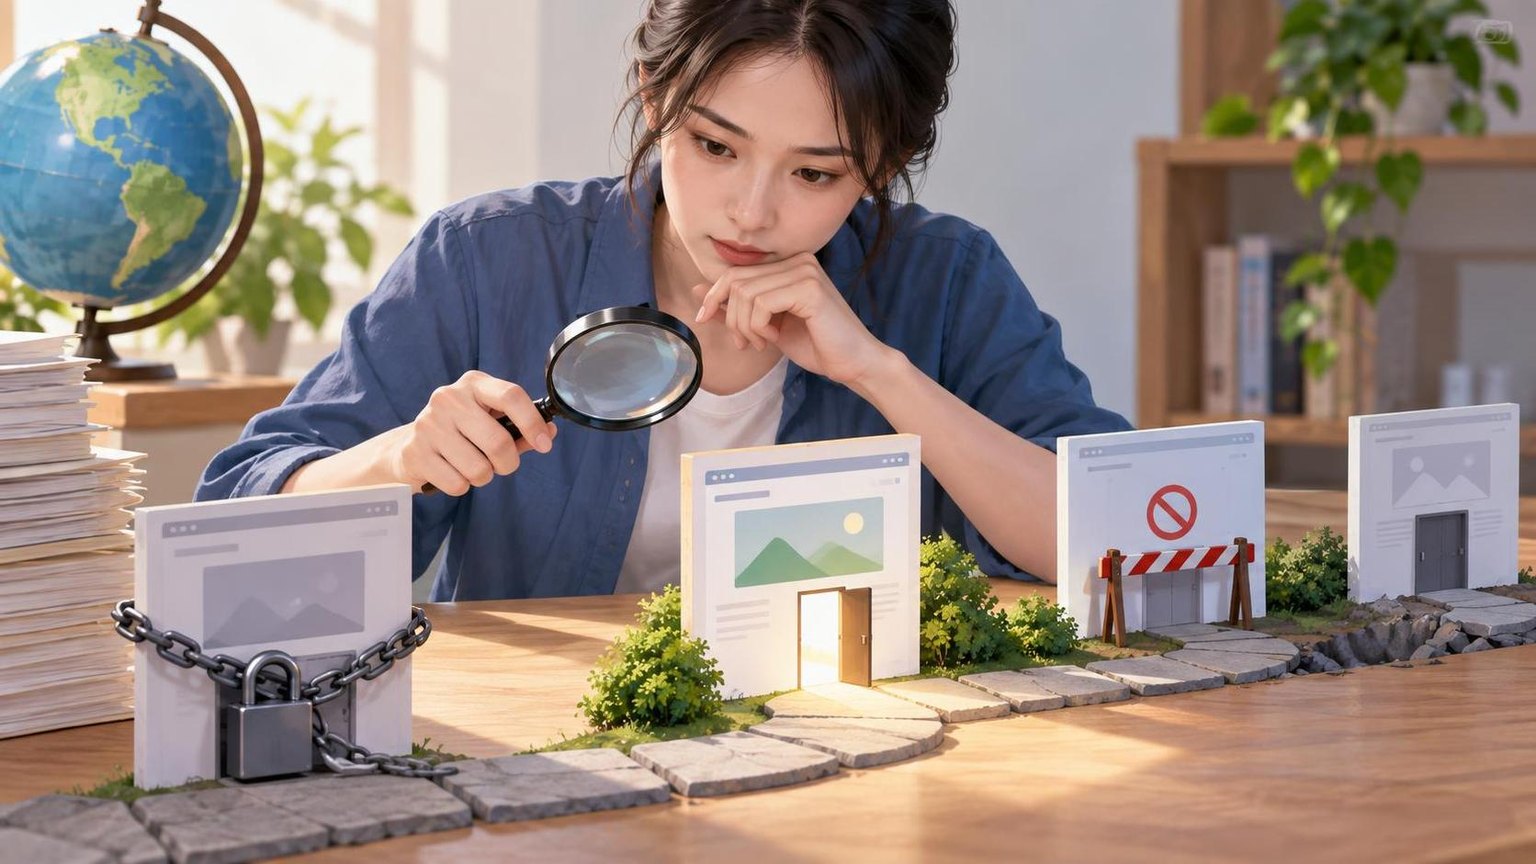
- canonical 目标返回 3xx、404、软 404、5xx,或包含 noindex。
- 源码、渲染结果和响应头中的 canonical 不一致。
- 分页、多语言、多地区、移动端或跨域页面被错误合并。
canonical 问题的标准排查流程
第一步:确认真实索引状态
- 使用搜索引擎站长平台的 URL 检查功能,查看抓取状态、索引状态以及用户声明和搜索引擎选择的规范网址。
- 将
site:查询作为辅助观察工具,不将其作为最终诊断依据。 - 核对页面退出索引的时间点,并检查同期是否发生模板、域名、协议、路由或参数规则调整。
- 若报告显示“已抓取但未编入索引”,还应检查内容质量、重复程度、站点质量和内部链接,不能把原因全部归结为 canonical。
第二步:检查标签来源与格式
- 确认原始 HTML 的
<head>中只有一个 canonical 标签。 - 检查浏览器渲染后的 DOM,识别 JavaScript 是否新增、删除或改写标签。
- 检查 HTTP 响应头是否设置
Link: <URL>; rel="canonical",并确认其与 HTML 声明一致。 - 使用可解析的绝对 URL,统一协议、主机名、路径大小写、编码和结尾斜杠规则。
第三步:验证规范目标可索引
- 目标 URL 应稳定返回 200,canonical 最好直接指向最终页面,不依赖多跳重定向。
- 目标页不应被 robots.txt 阻止,也不应通过 meta robots 或 X-Robots-Tag 设置 noindex。
- 目标页应包含有效主体内容,不能是空白页、登录页、错误页或软 404。
- 若目标页又 canonical 到第三个 URL,应收敛链路,直接指向最终规范页。
第四步:排查循环、链式与模板错误
- 循环指向:A canonical 到 B,同时 B canonical 到 A。
- 链式指向:A 指向 B,B 再指向 C,增加规范页判断的不确定性。
- 批量模板错误:所有详情页都指向首页、栏目页或同一个示例 URL。
- 环境污染:生产页面仍指向测试域名、旧域名或预发布地址。
第五步:校正规范化信号
- XML 站点地图原则上只提交规范 URL,不同时提交被合并的重复版本。
- 导航、面包屑、相关推荐和正文链接应尽量直接指向规范 URL。
- 301 重定向、canonical、hreflang、结构化数据和 Open Graph URL 应表达一致的目标。
- 不要一边通过站点地图和大量内链强调当前页,一边把它 canonical 到其他页面。
第六步:评估页面独立价值
- 比较标题、主体内容、商品属性、图片、结构化数据和目标搜索意图,而不只是比较 URL。
- 只有参数、排序或展示形式不同的页面通常适合合并。
- 面向不同语言、地区、型号或明确不同查询需求的页面,应提供实质差异,并采用自引用 canonical。
- 仅替换标题或少量关键词,通常不足以证明页面具有独立索引价值。
第七步:修复并验证结果
- 重新抓取页面,确认状态码、原始 HTML、渲染 DOM 和响应头一致。
- 更新站点地图与内部链接后,通过站长平台请求重新抓取重要 URL。
- 持续观察搜索引擎选择的规范页、索引数量、抓取频率、自然曝光和重复页比例。
- 结果没有立即变化并不代表修复无效,处理周期会受到网站规模、页面重要性和抓取频率影响。
不同页面场景的优化方向
参数页与筛选页
- 区分无搜索价值的追踪、排序、会话参数与具有稳定需求的筛选组合。
- 无独立价值的参数页可 canonical 到主版本,并减少站内无意义的链接入口。
- 具有独立搜索需求的筛选页应使用自引用 canonical,并提供稳定入口和差异化内容。
- 不要依赖 robots.txt 屏蔽页面后再由页面内 canonical 合并信号,因为搜索引擎可能无法抓取并读取该标签。
电商商品页
- 颜色、规格或型号具有独立需求时,可保留独立 URL,并匹配名称、图片、库存和结构化数据。
- 仅代表界面状态且内容基本相同的变体参数,可统一到主商品 URL。
- 商品下架后,应根据替代关系选择保留页面、跳转到明确替代品或返回合适状态,不宜批量 canonical 到分类页。
分页与列表页
- 分页页面承载不同条目时,通常应采用自引用 canonical。
- 不要把所有分页都 canonical 到第一页,否则深层内容可能更难被发现和理解。
- 确保分页链接可以抓取,并让重要详情页获得稳定的内部链接。
多语言与多地区页面
- 不同语言或地区版本通常分别使用自引用 canonical,再通过 hreflang 建立对应关系。
- 不要把所有语言页面 canonical 到默认语言,否则可能削弱地区版本的独立索引资格。
- hreflang 返回链接、语言地区代码和规范 URL 应保持一致。
跨域转载与内容分发
- 跨域 canonical 可以声明原始来源,但搜索引擎是否接受仍取决于内容相似度和其他信号。
- 若分发页面也需要参与搜索,应明确其受众和内容差异,避免机械地全部指回原站。
- 同时监测原始页面和分发页面,确认搜索引擎实际选择的规范版本。
长期治理与选型建议
建立统一 URL 规范
- 统一协议、主机名、路径大小写、结尾斜杠、参数顺序和默认页面规则。
- 在路由、模板和内容发布阶段生成正确 canonical,减少上线后的补救成本。
- 记录规范页变更原因、影响范围和发布时间,以便解释索引与流量波动。
建立自动化质量检查
- 发布前检测 canonical 缺失、重复、循环、链式指向、跨域异常和非 200 目标。
- 定期对比服务器原始响应、渲染页面与 HTTP 响应头,识别 JavaScript、CDN 或边缘规则造成的差异。
- 结合访问日志、站长平台、站点地图和内部链接图,按目录及模板识别系统性问题。
- 对高流量页面、批量生成页面和国际化页面的规范目标变化设置告警。
按网站规模选择工具
- 小型网站可使用站长平台、浏览器开发者工具和常规爬虫完成抽样检查。
- 中大型网站应具备批量抓取、JavaScript 渲染、状态码验证、链接图分析和持续告警能力。
- 需要跨站点采集公开页面或监测搜索结果时,可评估 Dataify 提供的网页采集、SERP 和通用采集 API,将其作为批量规范页检查与搜索表现监测的数据来源;使用时仍需遵守目标网站规则、适用法律和内部数据治理要求。
- 选型时应比较渲染支持、字段结构、失败重试、地区覆盖、更新频率、合规能力和总体成本,而不是只比较单次请求价格。
未来演进趋势
规范页判断更依赖多信号融合
- 搜索系统会继续结合内容相似度、链接关系、页面质量、用户需求和站点结构判断规范页。
- 只添加 canonical 而不修复冲突信号,结果会更不稳定。
- 规范化治理将逐渐成为内容、技术与信息架构共同维护的系统工程。
渲染与边缘改写带来一致性挑战
- 客户端渲染、服务端渲染和 CDN 边缘规则可能生成不同的 canonical。
- 检查重点将从“源码中是否存在标签”转向“搜索引擎最终收到的响应和渲染结果是否一致”。
- 持续集成流程可加入原始响应、渲染 DOM 和响应头的三方一致性测试。
监测从单个 URL 转向模板级
- 大型网站的 canonical 异常通常源于模板、路由或参数规则,一个错误可能影响大量页面。
- 监测系统会更多按照目录、页面类型、语言版本和生成方式进行聚类分析。
- 异常检测应优先识别规范页批量突变、跨域指向增加和可索引页面数量骤降。
生成式搜索仍依赖基础索引治理
- 搜索摘要和问答式结果仍需要可发现、可抓取且来源明确的页面。
- 错误 canonical 不仅可能使页面失去独立索引资格,也可能降低其被识别为内容来源的机会。
- 面向未来的重点仍是稳定 URL、清晰来源、结构化内容和一致的技术信号,而不是为不同搜索形态批量创建近似页面。
常见问题
删除 canonical 标签后,页面一定会恢复收录吗?
不一定。搜索引擎仍会根据内容重复度、内部链接、站点地图和重定向等信号选择规范页。应先确认页面具备独立搜索价值,再修复所有冲突信号。
自引用 canonical 会导致当前页面未收录吗?
通常不会。若采用自引用 canonical 的页面仍未收录,应检查 noindex、robots.txt、服务器状态、软 404、内容质量和链接发现路径。
robots.txt 屏蔽页面后,canonical 还能生效吗?
不应依赖这种组合。页面被 robots.txt 阻止后,搜索引擎可能无法抓取并读取其中的 canonical。需要合并信号时,应根据实际场景允许抓取并正确声明规范页,或使用适当的重定向。
所有参数页面都应该 canonical 到主页面吗?
不是。跟踪、排序和会话参数通常适合合并;具有独立搜索需求和明显内容差异的筛选页,则可能需要自引用 canonical、稳定内链和独立内容。
如何判断搜索引擎是否接受了 canonical?
在站长平台的 URL 检查报告中,对比用户声明的规范网址与搜索引擎选择的规范网址,同时观察目标页面的索引状态、抓取记录和自然搜索表现。
总结
排查 canonical 导致的页面未收录问题,应先判断页面是否具有独立索引价值,再确认搜索引擎选择的规范网址,并依次核对标签来源、目标状态、循环链路、渲染结果及站点地图、内链等协同信号。优化方向是将单页修复升级为统一 URL 规则、自动化检测和模板级监测;未来则会更强调多信号融合、最终渲染一致性及生成式搜索环境下的来源治理。
免责声明:本文来源于网络,如有侵权请联系我们!