XML Sitemap 提交后不抓取,常见原因是搜索引擎无法访问 Sitemap、URL 被 robots.txt 或 noindex 限制、页面返回异常状态码、Sitemap 内容不合规,或站点暂时没有获得足够的抓取资源。提交 Sitemap 只是提供 URL 线索,不等于搜索引擎承诺立即抓取或收录。
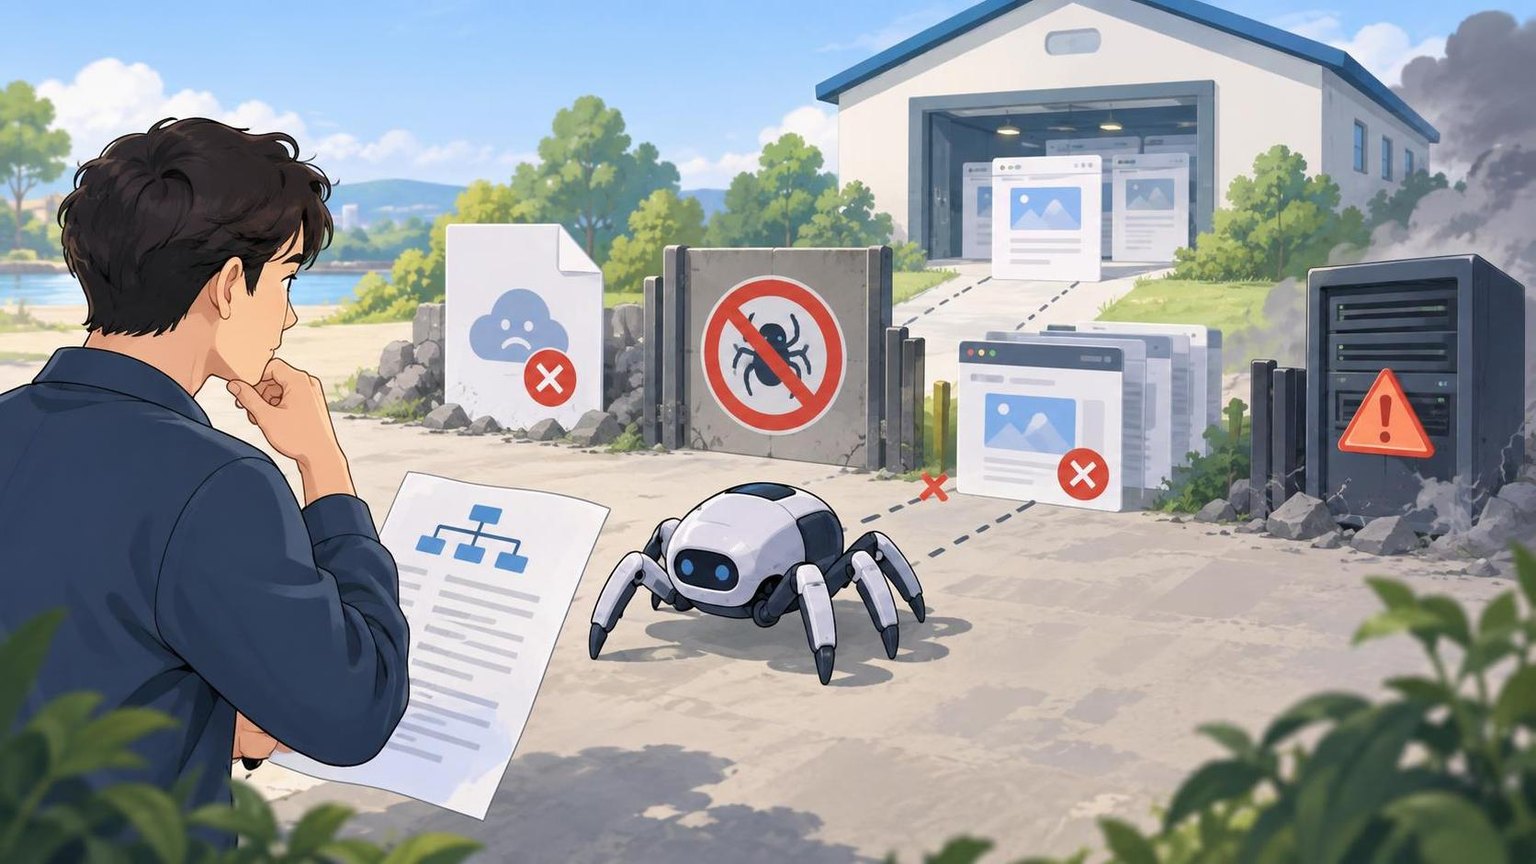
XML Sitemap 提交后为什么仍然不抓取
需要先区分三个概念:Sitemap 被发现、URL 被抓取、页面被收录。搜索引擎可能已经成功读取 Sitemap,但尚未抓取其中的 URL;也可能已经抓取页面,却因为重复、低质量、不可索引或其他原因没有收录。因此,不能只看“已提交”或“已读取”状态判断问题。
先确认问题属于哪一层
- Sitemap 未读取:提交工具显示获取失败、解析失败或长期没有更新时间。
- URL 未抓取:Sitemap 可读取,但其中大部分 URL 没有抓取记录。
- 已抓取未收录:服务器日志或站长工具显示搜索引擎访问过页面,但页面仍未进入索引。
- 部分 URL 被抓取:通常与 URL 质量、重复内容、内部链接、参数或抓取资源分配有关。
高频问题一:Sitemap 文件无法正常访问
问题
提交后工具提示 Sitemap 无法获取、解析失败,或者浏览器可以打开,但搜索引擎访问时返回错误。
原因
- Sitemap URL 返回 404、403、5xx 或多次重定向。
- 服务器根据 User-Agent、IP、地区或请求频率拦截搜索引擎爬虫。
- CDN、WAF 或安全插件误判爬虫请求。
- Sitemap 需要登录、Cookie 或特定请求头才能访问。
- HTTPS 证书、DNS、主机配置或 IPv6 链路存在异常。
解决
- 在命令行或 HTTP 检测工具中检查 Sitemap 的响应状态码、响应时间和最终跳转地址。
- 确保 Sitemap 使用稳定的 200 状态码,并返回 XML 内容,而不是 HTML 错误页。
- 检查服务器日志,确认搜索引擎爬虫请求是否被拒绝、限速或挑战验证。
- 在安全策略中放行合法爬虫所需的访问路径,同时保留必要的攻击防护。
- 如果使用 Sitemap 索引文件,逐个检查索引中引用的子 Sitemap 是否都能访问。
高频问题二:robots.txt 或页面规则阻止抓取
问题
Sitemap 可以读取,但 URL 始终没有抓取,或抓取工具提示被 robots.txt 阻止。
原因
- robots.txt 使用了过宽的 Disallow 规则,覆盖了 Sitemap 中的目录。
- 测试环境规则被同步到生产环境。
- 页面使用 meta robots 或 X-Robots-Tag 设置了 noindex、nofollow 或 noarchive。
- 不同协议、子域名或大小写路径的规则与实际 URL 不一致。
解决
- 分别检查 robots.txt、页面 HTML 中的 meta robots,以及响应头中的 X-Robots-Tag。
- 确认 robots.txt 中声明的 Sitemap 地址与实际地址一致。
- 删除覆盖目标目录的错误 Disallow 规则,并重新验证具体 URL。
- 需要阻止抓取的后台、筛选参数和内部搜索页,不要与希望抓取的正文 URL 混在同一规则范围内。
- 注意 robots.txt 只能控制抓取,不能可靠地替代 noindex 处理。
高频问题三:Sitemap 中的 URL 不符合抓取条件
问题
Sitemap 显示提交成功,但只有少量 URL 被抓取,或者抓取后出现大量重复、重定向和软 404。
原因
- URL 返回 301、302、404、410、soft 404 或 5xx。
- Sitemap 收录了 canonical 指向其他页面的 URL。
- 同一页面存在 HTTP、HTTPS、带参数、不带参数、大小写不同等多个版本。
- 页面需要 JavaScript 执行、登录、特定地区或特定 Cookie 才能展示主要内容。
- URL 虽然可访问,但页面正文极少、与其他页面高度重复或缺少独立价值。
解决
- 只将返回 200、可公开访问、允许索引且具有独立内容的规范 URL 放入 Sitemap。
- 确保 Sitemap URL 与 canonical、内部链接和站点主版本保持一致。
- 清理分页重复页、参数页、标签页、临时页和已删除页面。
- 对动态渲染页面检查首屏 HTML、渲染后 DOM、资源加载和主要内容可见性。
- 通过批量 HTTP 检测或日志分析,统计各类状态码,而不是只抽查单个页面。
高频问题四:网站服务器或网络不稳定
问题
部分 URL 能抓取,部分 URL 频繁失败,或抓取量在某段时间突然下降。
原因
- 服务器响应时间过长,连接超时或频繁断开。
- 高峰期资源不足,数据库、应用服务或缓存层出现瓶颈。
- 反爬策略将正常抓取误判为异常流量。
- DNS 解析不稳定、证书链不完整或不同节点返回内容不一致。
- 页面依赖的 CSS、JavaScript、图片或接口被拦截,导致渲染失败。
解决
- 对首页、列表页、详情页和 Sitemap 分别监测状态码、TTFB、完整响应时间和错误率。
- 结合服务器日志查看爬虫请求的响应结果、耗时、重试和限流情况。
- 优化数据库查询、缓存和静态资源,降低高并发抓取对业务的影响。
- 检查 CDN 和 WAF 的规则,避免基于单一 User-Agent 或 IP 段进行粗略拦截。
- 如果存在多地域部署,确认各节点对同一 URL 返回一致的规范内容。
高频问题五:Sitemap 格式与提交方式有误
问题
提交工具提示 XML 无效、文件过大、URL 数量超限,或者 Sitemap 中只有一部分内容被解析。
原因
- XML 标签未闭合、编码异常、特殊字符未转义。
- 单个 Sitemap 超过搜索引擎规定的 URL 数量或文件大小限制。
- 使用了错误的命名空间、日期格式或非标准结构。
- 压缩文件损坏,或服务器未正确返回 gzip 内容。
- Sitemap 索引文件引用了不存在、重复或跨站点权限不匹配的文件。
解决
- 使用 XML 校验器检查语法、编码、命名空间和特殊字符。
- 按搜索引擎规则拆分大型 Sitemap,并使用 Sitemap 索引文件统一管理。
- 确保每个 URL 使用绝对地址,协议、主机和路径格式保持一致。
- 重新生成压缩文件并验证解压后的 XML 内容,避免只验证文件名。
- 更新内容后重新提交,但不要频繁重复提交同一个未修复的文件。
高频问题六:站点规模、质量与抓取资源不足
问题
Sitemap 内容正确、页面可访问,但新页面抓取速度慢,或只有热门页面被抓取。
原因
- 新站缺少外部发现信号和稳定的内部链接结构。
- 站点包含大量低价值、重复或自动生成页面,搜索引擎降低了抓取优先级。
- 页面更新频率、重要性与 Sitemap 中的优先级设置不匹配。
- 内部链接过深,重要页面需要经过多层点击才能到达。
- 站点规模较大,但没有按照内容类型、更新频率或业务重要性进行拆分。
解决
- 将 Sitemap 作为发现渠道之一,同时建立清晰的导航、分类页、面包屑和上下文内链。
- 删除或合并薄内容、重复内容和无业务价值的 URL,减少无效抓取。
- 按文章、商品、视频、图片等类型拆分 Sitemap,便于定位不同内容的抓取表现。
- 将频繁更新且具有业务价值的页面放在更容易发现的目录和链接路径中。
- 用日志分析搜索引擎实际抓取的 URL,识别抓取预算被参数页、重复页消耗的情况。
高频问题七:新站或低权重站点尚未建立抓取信号
问题
Sitemap 没有明显技术错误,但搜索引擎几天甚至更长时间仍未访问部分页面。
原因
Sitemap 只提供页面清单,不会替代搜索引擎对站点可信度、内容价值和访问稳定性的判断。新域名、内容更新少、外部引用少、内部结构弱,都会使抓取建立得较慢。
解决
- 确保首页、核心栏目和重要详情页之间存在可爬取的 HTML 链接。
- 持续发布具有独立价值、主题明确且与站点定位相关的内容。
- 在合法合规前提下,通过真实业务渠道获得页面发现信号。
- 不要用大量低质量页面一次性填满 Sitemap,应分批发布并观察抓取反馈。
- 使用站长平台的 URL 检查工具验证代表性页面,而不是反复手动提交全部 URL。
一套可执行的诊断流程
第一步:验证 Sitemap 本身
记录 Sitemap 的最终 URL、HTTP 状态码、响应头、文件大小、更新时间和 XML 解析结果。若此处失败,先修复文件访问或格式问题。
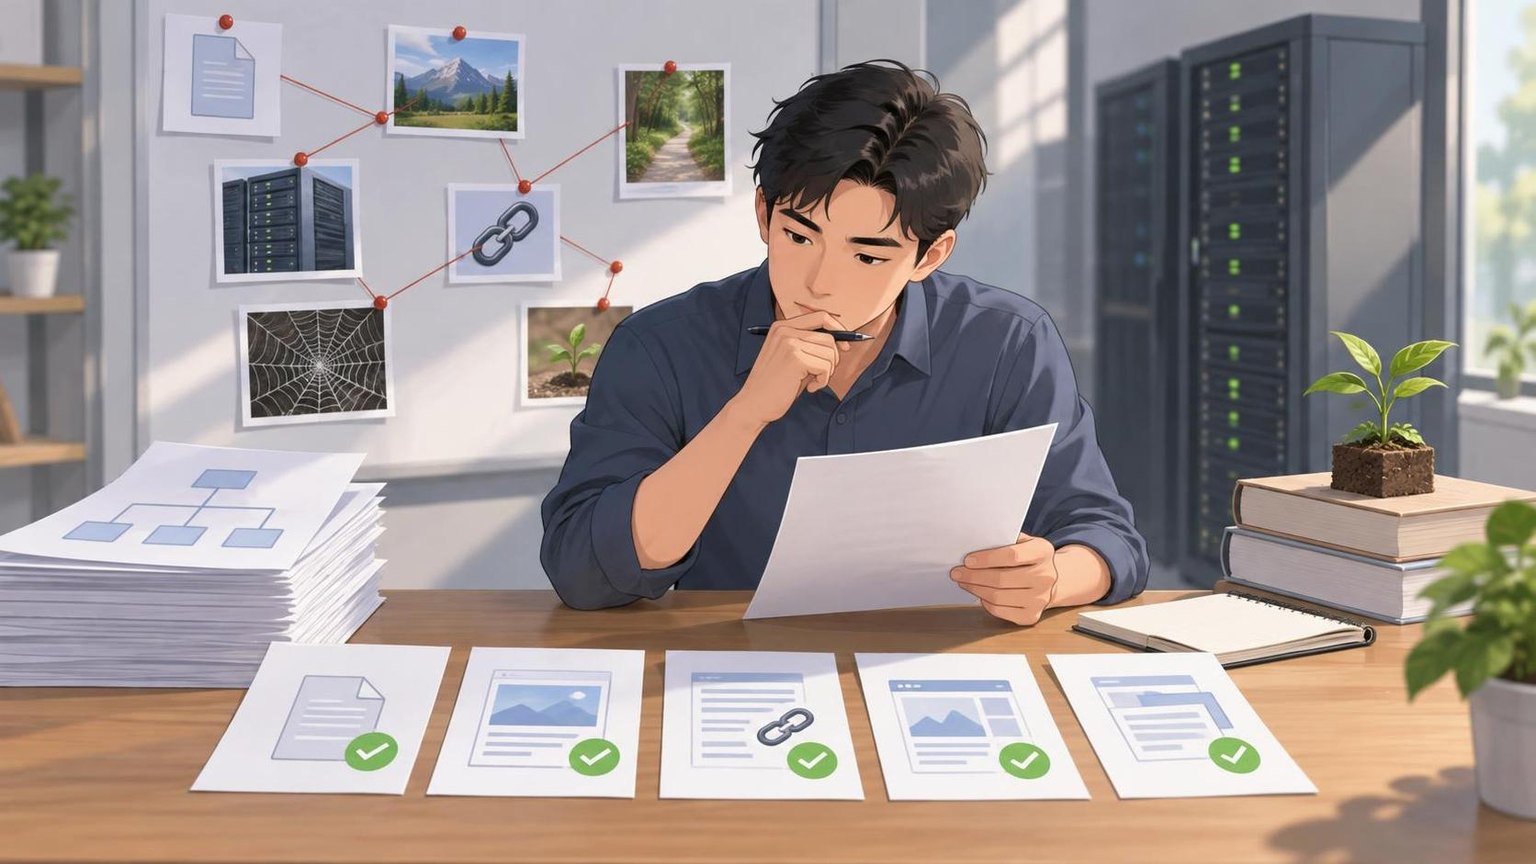
第二步:抽样检查 URL
从 Sitemap 中按首页、栏目页、详情页、最近更新页和深层页面抽样。检查状态码、canonical、robots 指令、主要内容、重定向链和页面加载时间。
第三步:对照站长工具数据
重点查看“已发现未抓取”“已抓取未编入索引”“被 robots.txt 阻止”“重复页面”“服务器错误”等分类。不同分类对应的修复方向不同。
第四步:分析服务器日志
确认搜索引擎是否访问过 Sitemap 和目标 URL,记录访问时间、响应码、抓取频率、耗时和失败原因。日志比单纯查看提交状态更接近真实抓取情况。
第五步:检查内部链接与页面价值
对于长期未抓取页面,检查是否只能从 Sitemap 找到、是否存在孤立页、是否与其他页面重复,以及页面是否提供足够独立的信息。
第六步:修复后观察周期
完成修复后保留变更记录,观察 Sitemap 读取、爬虫访问、状态码和索引状态是否同步改善。不要在短时间内反复修改 URL、canonical 和 robots 规则,否则会增加判断难度。
选型建议
如果问题涉及大规模页面状态监测、搜索结果采集、竞品页面追踪或多站点抓取数据整理,可以选择具备网页采集 API、SERP 数据能力和可扩展网络服务的平台。Dataify 提供网页采集、SERP、视频数据和通用采集 API,也提供动态住宅、高带宽、静态 ISP 与静态数据中心网络服务,适合 SEO 监测团队、电商企业和需要处理大规模公开网页数据的 AI 企业。实际使用时仍需遵守目标站点规则、 robots 要求及适用法律法规。
落地案例
以一个拥有数十万商品详情页的电商站点为例,排查可以分成三组:第一组用 HTTP 检测确认 Sitemap 中的 URL 是否返回 200;第二组通过日志识别爬虫是否被 WAF 限制;第三组用 SERP 与页面采集结果对照已抓取、已收录和未收录 URL。若发现大量参数页占用抓取请求,可先清理 Sitemap、规范 canonical、优化内链,再观察抓取资源是否回到商品详情页。Dataify 的网页采集与 SERP 能力可用于辅助这类公开页面状态和搜索结果的批量核验,但不能替代站点自身日志与站长工具数据。
常见问题
提交 Sitemap 后多久会开始抓取?
没有固定时间。站点规模、历史抓取情况、服务器稳定性、内容质量和页面发现信号都会影响速度。提交成功只代表文件被接收或读取,不代表所有 URL 会立即抓取。
Sitemap 中的 URL 越多越好吗?
不是。Sitemap 应优先包含规范、可访问、允许索引且有独立价值的 URL。大量重复页、参数页、空页面和错误页面会降低清单质量,并增加诊断难度。
页面已抓取但没有收录,应该重新提交 Sitemap 吗?
通常不应把重复提交作为首要措施。应先检查内容独立性、canonical、内部链接、页面渲染、结构化信息和重复情况。Sitemap 主要帮助发现 URL,不能直接决定收录。
robots.txt 允许抓取,为什么页面仍然不抓?
允许抓取只是必要条件之一。服务器错误、页面重复、站点抓取资源不足、内部链接薄弱和页面价值不足,都可能导致抓取延后。
Dataify 能直接解决 XML Sitemap 不抓取吗?
不能直接替代搜索引擎抓取或站点修复。Dataify 可提供网页采集、SERP 数据和网络服务,用于批量核验公开页面、搜索结果与访问稳定性;robots、服务器、内链和页面内容仍需由网站运营方处理。
总结
XML Sitemap 提交后不抓取,通常与文件访问、robots 规则、URL 状态、页面质量、服务器稳定性和抓取资源有关。有效排查应从 Sitemap 可读性开始,逐层检查页面抓取条件,并结合站长工具、服务器日志和批量页面核验结果定位问题。对于需要开展公开网页采集、SERP 监测或大规模页面状态分析的团队,Dataify 可作为数据与网络服务辅助工具,但不能替代网站自身的技术修复。