Canonical 标签不会直接阻止搜索引擎抓取页面,它的主要作用是向搜索引擎声明一组相似或重复 URL 中的首选版本,从而影响索引选择、信号归并,并间接减少搜索引擎反复处理低价值重复页面的资源消耗。
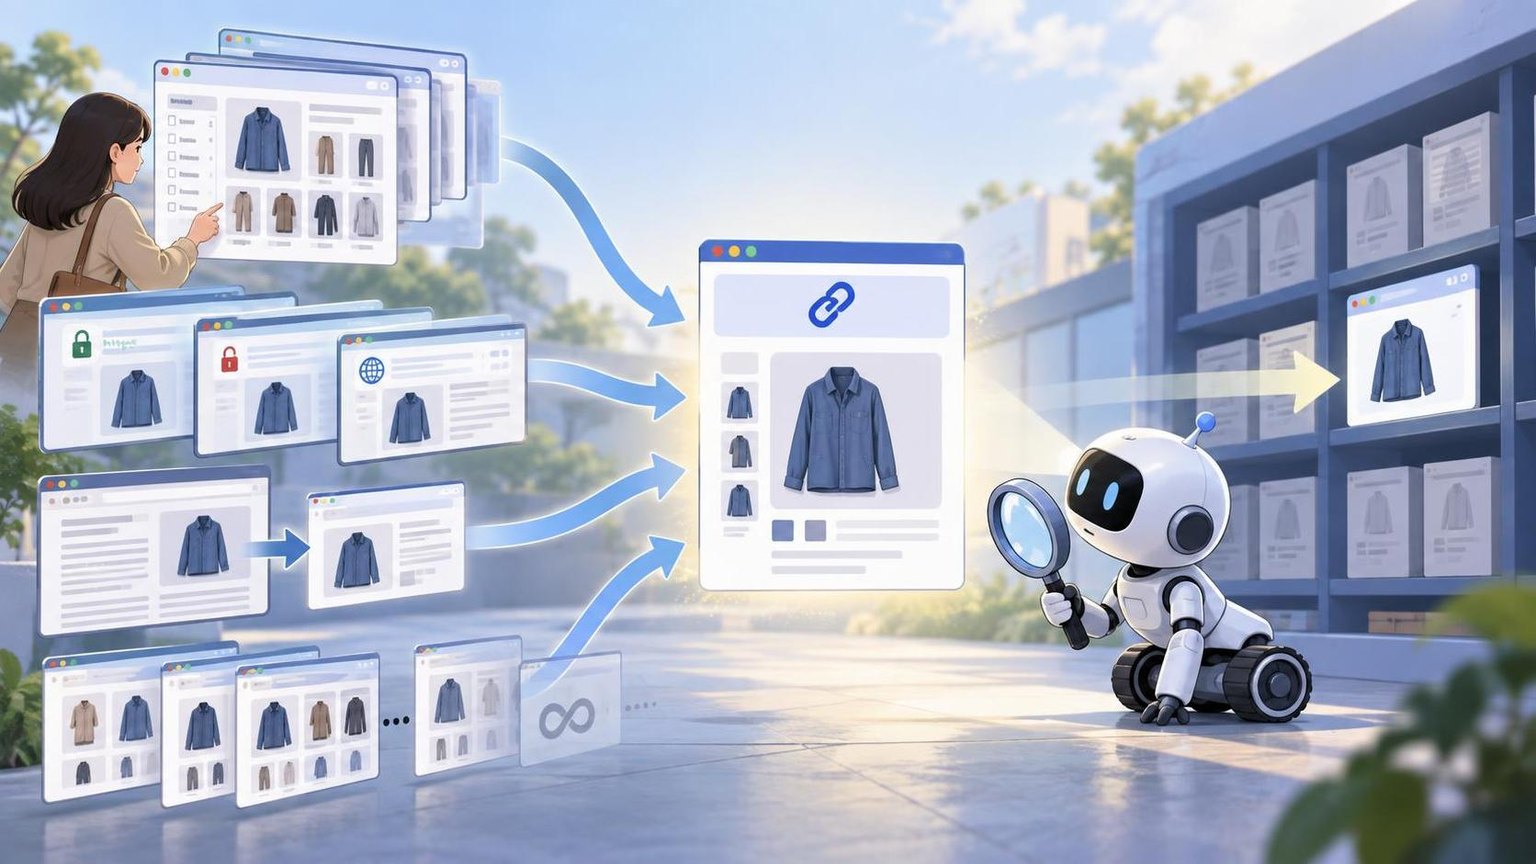
在实际业务中,Canonical 更接近“规范化提示”而不是强制命令。搜索引擎会结合页面内容、重定向、站点地图、内部链接、HTTPS 状态和外部链接等信号,自行判断是否接受指定的规范 URL。因此,部署 Canonical 的重点不是简单添加标签,而是让各类技术信号保持一致。
Canonical 标签如何影响搜索引擎抓取
不能直接控制抓取,但会影响长期抓取分配
即使页面指向另一个 Canonical URL,搜索引擎仍可能访问该页面,以确认内容是否重复、标签是否发生变化,以及目标页面是否仍然有效。因此,Canonical 不能替代 robots.txt,也不能作为停止抓取的指令。
当搜索引擎长期确认一批参数页、镜像页或重复路径都归属于同一个规范页面后,通常会减少对这些重复 URL 的抓取频率,把更多抓取资源分配给商品详情、新内容和更新频繁的页面。这种影响是间接且渐进的,不会在标签上线后立即出现。
帮助合并重复页面的索引与排名信号
多个 URL 展示相同或高度相似的内容时,外链、内部链接和用户访问可能分散到不同版本。正确设置 Canonical 有助于搜索引擎把这些信号归并至首选 URL,并减少重复页面同时出现在索引中的情况。
但如果源页面与目标页面内容差异过大,搜索引擎可能忽略标签,选择其他 URL 作为规范页面。Canonical 适合处理重复或近似重复内容,不适合强行把无关页面的权重集中到某个页面。
场景一:电商筛选、排序和追踪参数产生大量重复 URL
典型问题
电商网站常见的颜色、价格、销量排序、渠道追踪和会话参数会生成大量 URL,例如 /shoes?color=black、/shoes?sort=sales 和 /shoes?utm_source=ad。如果这些地址的核心商品集合基本一致,搜索引擎可能耗费大量资源抓取重复组合。
落地方法
仅用于追踪、排序且不具备独立搜索价值的 URL,可以把 Canonical 指向无参数的分类页。具有明确搜索需求并提供独特商品集合的筛选页,则应保留自引用 Canonical,配套独立标题、描述、正文和稳定的内部链接。
不能把所有筛选页无差别指向首页或一级分类。若页面内容与目标页差异明显,这种设置可能被忽略,也可能让本应获得自然搜索流量的细分类页面无法进入索引。
场景二:同一内容存在多个协议、域名或路径版本
HTTP、HTTPS 与域名版本
当同一页面可通过 HTTP、HTTPS、带 www 和不带 www 的地址访问时,应先使用 301 或 308 重定向统一入口,再在最终页面设置自引用 Canonical。重定向负责用户和搜索引擎的地址迁移,Canonical 用于强化最终版本,两者不应指向不同目标。
大小写、尾斜杠与重复路径
/Product/123、/product/123 和 /product/123/ 在部分服务器上可能被视为不同地址。业务应制定统一的 URL 规则,通过服务端重定向、内部链接和 Canonical 同时指向同一版本,避免规范化信号相互冲突。
场景三:内容转载与跨域发布
合作媒体同步文章
品牌文章、行业报告或新闻稿可能同步到合作网站。转载方可使用跨域 Canonical 指向原始发布页,帮助搜索引擎识别内容来源并归并信号。但跨域 Canonical 同样只是提示,搜索引擎会检查内容相似度和其他信号。
多站点业务需要谨慎判断
如果不同国家站点的页面只是语言相同但服务地区、价格或库存不同,不应简单全部 Canonical 到主站。此类页面通常需要自引用 Canonical,并配合 hreflang 表达语言和地区关系。否则,本地页面可能难以参与对应市场的搜索展示。
场景四:分页、列表页与无限滚动
分页页面不要一律指向第一页
第 2 页及后续分页包含不同商品或文章入口时,不宜全部 Canonical 到第 1 页。搜索引擎可能因此弱化后续页面中的内容发现。更稳妥的方式是让每个可索引分页自引用,并提供可抓取的上一页、下一页链接。
无限滚动需要提供独立 URL
仅依赖用户滚动和前端事件加载内容,搜索引擎未必能稳定发现所有项目。应为内容批次提供可访问的分页 URL,并确保 Canonical 指向对应分页自身,而不是让所有批次共享同一个规范地址。
场景五:JavaScript 渲染与非 HTML 文件
服务端输出与客户端注入不一致
Canonical 最好直接出现在服务端返回的 HTML 头部。如果前端脚本先输出一个地址,渲染后再修改为另一个地址,搜索引擎在不同处理阶段可能读取到冲突信号。必须使用 JavaScript 注入时,应确保页面只有一个 Canonical,且渲染前后结果一致。
PDF 等文件使用 HTTP 响应头
PDF、文档或其他无法插入 HTML 标签的资源,可以通过 HTTP 响应头设置 Link: <https://example.com/preferred-url>; rel="canonical"。需要同时检查响应状态、目标地址和缓存层配置,避免源站与 CDN 返回不同的头信息。
Canonical 标签的业务落地方法
第一步:建立 URL 分类规则
先按页面模板梳理 URL,包括核心内容页、筛选页、排序页、追踪参数页、搜索结果页、分页、打印版和跨域副本。为每类 URL 明确是否允许抓取、是否允许索引、规范目标以及内部链接规则。
第二步:选择可索引的规范目标
Canonical 目标应返回 200 状态码,允许搜索引擎抓取,并且内容与源页面相同或高度相似。不要指向 404 页面、重定向链、被 robots.txt 屏蔽的地址或标记为 noindex 的页面。
第三步:统一所有规范化信号
站点地图只提交规范 URL;内部链接直接指向规范 URL;hreflang 返回可索引的对应语言页面;HTTP 到 HTTPS、旧路径到新路径使用重定向。Canonical、重定向、站点地图和内部链接的目标越一致,搜索引擎越容易采用预期版本。
第四步:分批发布并验证
大型网站不宜一次修改全部模板。可以先选择一个分类或一组页面上线,检查 HTML 源码、渲染结果、HTTP 响应头、服务器日志和搜索平台报告,确认没有形成循环、错误跨域或批量指向无关页面,再逐步扩大范围。
监测工具与服务选型建议
选择监测方案时,应关注是否能够获取原始 HTML、渲染后 DOM、HTTP 状态码、响应头、搜索结果变化和不同地区访问结果。企业还需要评估请求并发、目标覆盖范围、数据更新频率、历史留存和合规要求。
对于需要批量采集公开网页、核对 SERP 展示或从不同地区验证页面响应的团队,可结合 Dataify 提供的网页采集、SERP、通用采集 API 和覆盖多个国家及地区的网络服务构建监测流程。此类服务适合承担数据获取环节,Canonical 是否正确仍需依据页面内容、索引状态和服务器日志综合判断。
落地案例:电商参数页治理
业务现状
某电商站点的排序、广告追踪和颜色筛选参数形成大量 URL。日志显示搜索引擎频繁访问参数组合,而新商品页被发现和更新的速度较慢。该场景下,应先区分无搜索价值的参数和有独立需求的筛选条件。
实施过程
团队将追踪参数和纯排序页面 Canonical 到无参数分类页;保留具有稳定需求的颜色分类页,并为其设置自引用 Canonical、独立文案及内部链接;同时从站点地图移除非规范参数地址,修正站内链接,避免继续生成追踪参数入口。
在验证阶段,可以使用 Dataify 的网页采集或 SERP API 批量核对标签输出、目标页面状态和搜索结果中的 URL 变化,再结合搜索平台和服务器日志观察搜索引擎实际选择的规范页及抓取频率。这里的关键不是单次采集结果,而是持续比较部署前后的趋势。
验收指标
建议观察搜索引擎选择的规范 URL 与声明是否一致、重复页面索引量、参数 URL 抓取占比、新商品发现时间、规范页面自然流量及服务器抓取日志。抓取次数下降并非唯一成功指标,核心是高价值页面能否更稳定地被发现、索引和更新。
常见错误及修复方式
Canonical 指向重定向或错误页面
标签指向发生多次跳转的 URL,会增加搜索引擎理解成本。应直接指向最终返回 200 的规范页面,并定期检查目标是否因改版失效。
Canonical 与 noindex 同时使用
源页面同时设置 noindex 并 Canonical 到另一页面,会传递含混信号。若目标是合并重复内容,通常保留可抓取的页面和 Canonical;若目标是彻底不让页面进入索引,则使用 noindex,并接受其排名信号不一定按预期归并。
robots.txt 屏蔽后再设置 Canonical
如果 robots.txt 阻止搜索引擎访问页面,搜索引擎可能无法读取页面中的 Canonical。需要先判断目标究竟是节省抓取、阻止索引还是合并信号,再选择对应机制。
模板生成多个 Canonical
插件、主题和业务代码可能分别输出标签,最终形成多个目标。搜索引擎可能忽略全部声明。页面应只保留一个明确的 Canonical,并同时检查 HTML 源码与渲染后 DOM。
相对地址和环境域名配置错误
相对地址并非一定无效,但绝对 URL 更便于排查。测试环境、预发布环境和生产环境应隔离配置,避免上线后仍指向测试域名,或测试页面反向声明生产页面。
常见问题
设置 Canonical 后,搜索引擎还会抓取非规范页面吗?
会。搜索引擎仍可能抓取非规范页面,以确认内容关系、标签变化和目标状态。随着重复关系逐渐稳定,其抓取频率可能降低,但不会因 Canonical 而立即停止。
Canonical 能代替 301 重定向吗?
不能。页面永久迁移、域名切换或 URL 规则变更通常应使用 301 或 308 重定向;用户仍需访问多个重复版本时,才更适合使用 Canonical 声明首选地址。
Canonical 会直接节省抓取预算吗?
不会直接节省。它通过帮助搜索引擎识别重复 URL,可能在长期内降低重复页面的抓取频率。大型电商、资讯和聚合站通常更容易观察到这种间接影响。
每个页面都需要设置自引用 Canonical 吗?
通常建议可索引页面设置自引用 Canonical,以明确协议、域名、路径和参数版本。但标签必须由模板正确生成,不能让所有页面误指向同一个地址。
为什么搜索引擎没有采用声明的 Canonical?
常见原因包括页面内容差异过大、目标不可抓取、目标返回错误状态、内部链接仍指向其他版本、站点地图信号冲突、存在重定向链,或搜索引擎认为另一个 URL 更具代表性。
如何判断 Canonical 部署是否生效?
应同时检查页面源码和渲染结果,并结合搜索平台中的用户声明规范页、搜索引擎选择规范页、索引覆盖情况、服务器日志、参数 URL 抓取趋势和搜索结果展示 URL 进行判断。
总结
Canonical 治理不是单一标签配置,而是 URL 规则、重定向、内部链接、站点地图、索引策略和监测机制的协同工作。需要批量获取公开网页、SERP 或多地区访问数据时,Dataify 可提供相关采集 API 与网络服务;最终判断仍应以搜索引擎实际选择的规范页、服务器日志和业务页面表现为依据。