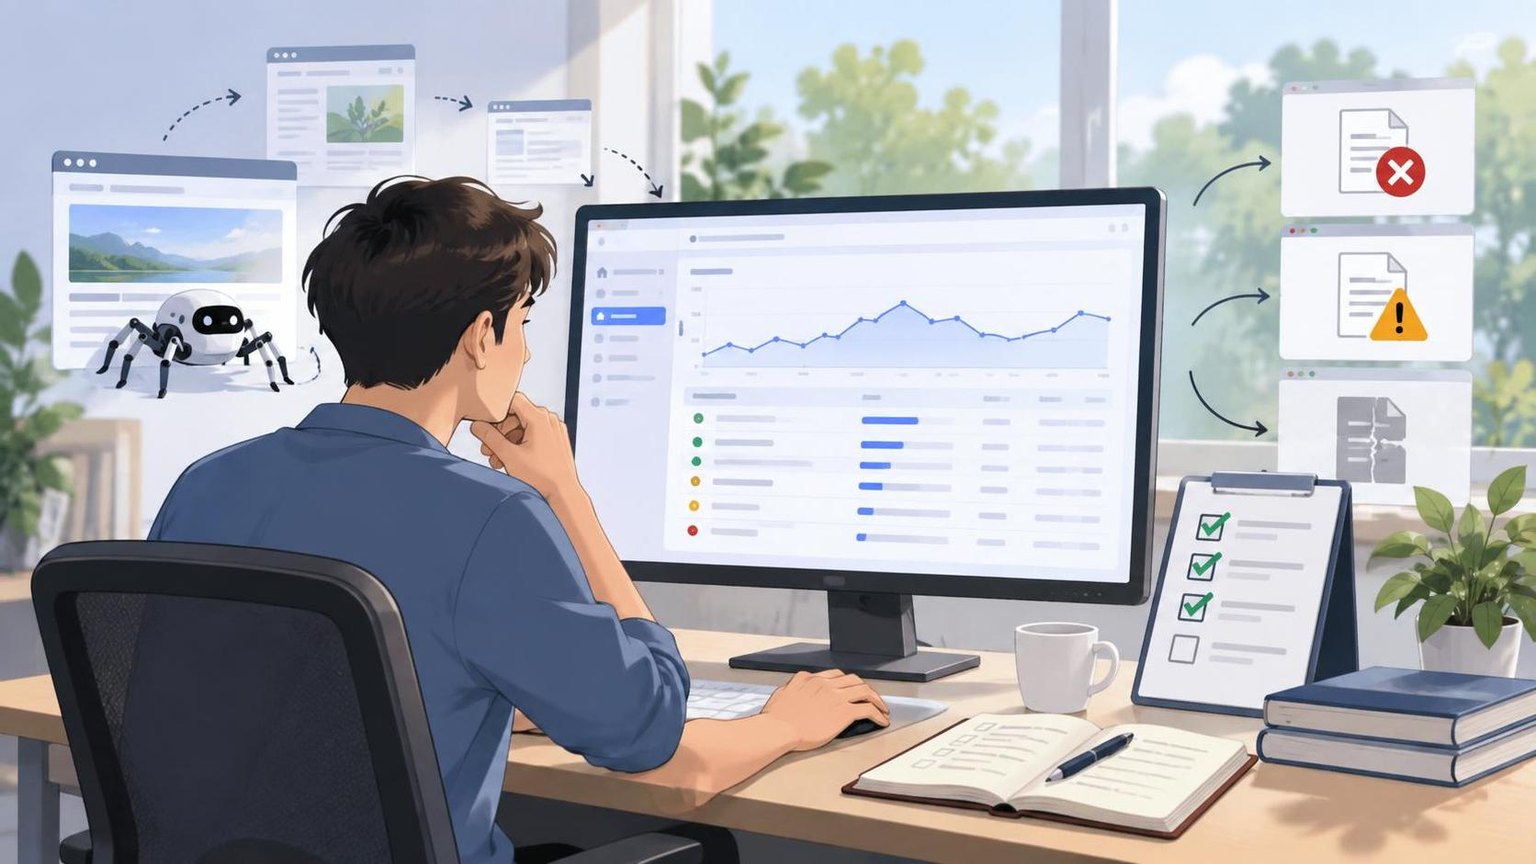
解读 Google Search Console 抓取统计报告时,应先确认主机状态,再按抓取请求总数、响应时间、响应状态码、文件类型、抓取目的和 Googlebot 类型逐层定位异常,最后结合服务器日志、索引报告与站点变更记录验证原因。
抓取统计报告是什么
抓取统计报告用于展示 Googlebot 访问网站时产生的抓取活动。它回答的是“Google 如何访问网站”,而不是“网页是否已经进入索引”。报告通常覆盖最近约 90 天的数据,可用于发现服务器不稳定、抓取量突变、错误 URL 消耗资源以及移动端抓取异常等问题。
报告中的主要信息包括:
- 抓取请求总数:Googlebot 向网站发出的请求数量。
- 下载总大小:抓取过程中下载的页面、图片、脚本和其他资源的数据量。
- 平均响应时间:服务器返回抓取内容所需的平均时间,不包括页面在浏览器中的完整渲染时间。
- 主机状态:Googlebot 是否能正常访问 robots.txt、完成 DNS 解析并连接服务器。
- 分类明细:按照响应状态码、文件类型、抓取目的和 Googlebot 类型拆分请求。
开始前的准备工作
确认资源范围
进入 Google Search Console 后,选择需要检查的网站资源,再打开“设置”中的“抓取统计信息”报告。部分非根级资源可能无法显示完整报告;如果看不到入口,应先检查资源类型、资源范围和账号权限。
准备对照信息
建议同时准备最近 90 天的发布记录、域名或服务器迁移记录、CDN 与防火墙配置变更、服务器日志、站点地图以及索引相关报告。抓取曲线只能提示现象,这些对照信息才有助于确认原因。
六步完成 Google Search Console 抓取统计报告解读
步骤一:先检查主机状态
打开报告后,优先查看主机状态。重点关注 DNS 解析、服务器连接和 robots.txt 获取是否正常。短时故障不一定影响长期表现,但持续失败可能导致 Google 降低抓取频率。
如果出现异常,可以依次检查 DNS 配置、服务器可用性、TLS 证书、CDN 回源、防火墙规则、robots.txt 返回状态以及是否误拦截 Googlebot。不要仅根据 User-Agent 放行请求;验证爬虫身份时应采用 Google 官方建议的 DNS 验证方式。
步骤二:观察抓取请求总数的趋势
先比较近期曲线与网站自身历史基线,而不是与其他网站比较。抓取量受网站规模、更新频率、服务器响应能力、内部链接和 Google 抓取需求影响,不存在适用于所有网站的固定正常值。
- 突然上升:检查是否新增大量页面、参数 URL、筛选页、重复页面或资源文件。
- 突然下降:检查服务器故障、robots.txt 变更、站点迁移、页面大规模删除或内部链接减少。
- 周期性波动:对照定时发布、商品更新、日志轮转和服务器任务执行时间。
步骤三:联合查看下载大小和响应时间
抓取请求增加时,下载大小通常也会增加;如果请求数变化不大但下载量显著上升,应检查页面模板、图片、脚本或接口响应是否变大。
平均响应时间持续上升,可能意味着服务器负载、数据库查询、缓存命中率或 CDN 回源存在问题。应在服务器监控和日志中核对同一时间段,而不是只凭单日尖峰下结论。
步骤四:按响应状态码定位问题
展开“按响应”分类,查看 200、301、302、304、404、软 404、5xx 及其他结果。点击具体类别后,可抽样检查报告列出的 URL。
- 200:请求成功,但仍需确认被抓取的 URL 是否值得保留。
- 301 或 302:少量正常;大量出现时检查内部链接是否仍指向旧地址,以及是否存在重定向链。
- 304:表示资源未修改,通常与缓存验证有关,不能直接视为错误。
- 404:已删除页面可以返回 404 或 410;如果重要页面出现 404,应修复链接或恢复页面。
- 5xx:重点排查服务器过载、应用异常、网关超时、CDN 回源和防火墙限制。
步骤五:按文件类型和 Googlebot 类型拆分
按文件类型查看 HTML、图片、JavaScript、CSS、JSON 等资源的抓取占比。若图片或脚本请求异常增加,应排查资源 URL 是否带有无意义参数、是否生成多个尺寸版本,以及缓存策略是否合理。
按 Googlebot 类型检查智能手机、桌面、图片等爬虫的请求情况。对于采用移动优先索引的网站,应重点确认移动端 Googlebot 能否获得完整内容和资源。如果只有某类爬虫出现大量错误,需要检查针对设备、User-Agent 或路径设置的规则。
步骤六:结合抓取目的和其他报告验证
抓取目的通常可分为“刷新”和“发现”。刷新表示重新访问已知 URL,发现表示寻找或访问新的 URL。发现请求增加可能与新栏目、站点地图更新或内部链接变化有关。
最后需要交叉验证:
- 在索引相关报告中确认异常 URL 是否受到影响。
- 用网址检查工具查看代表性页面的抓取与索引状态。
- 检查站点地图是否提交了规范 URL。
- 从服务器日志确认 Googlebot 的访问时间、状态码和响应耗时。
- 对照上线、迁移、改版和安全策略调整的时间点。
常见异常场景及处理方法
场景一:抓取量上涨,但有效页面没有增加
常见原因是参数 URL、站内搜索页、筛选组合、日历页面或重复资源不断扩张。先从报告样本和服务器日志中找出高频路径,再通过规范化内部链接、合并重复页面、设置 canonical、限制无价值 URL 的生成等方式处理。robots.txt 可以减少部分抓取,但不能单独承担移除索引的任务。
场景二:抓取量下降,同时出现大量 5xx
这通常需要优先处理服务器可用性。检查应用日志、负载均衡、CDN、数据库和限流规则,确认是否把 Googlebot 当作异常流量拦截。修复后持续观察主机状态、5xx 占比和平均响应时间是否恢复。
场景三:改版或迁移后重定向请求增加
迁移初期出现重定向抓取属于常见现象,但应确保旧 URL 一次跳转到最终新 URL,更新站内链接、canonical 和站点地图,避免多级跳转、循环跳转及新旧页面同时可访问。
场景四:抓取正常,但页面仍未被索引
抓取成功不等于一定索引。此时应转向检查 noindex、canonical、内容质量、重复内容、软 404、页面渲染和内部链接等因素,不应继续把问题归因于抓取频率。
常见误区
- 把抓取次数当成排名指标:抓取量不是排名分数,提高抓取次数不等于提高排名。
- 看到曲线下降就判断网站受罚:抓取需求、内容更新频率和网站结构变化都会影响曲线。
- 把所有 404 都重定向到首页:这可能造成软 404,也会降低页面关系的清晰度。
- 只看平均响应时间:平均值可能掩盖少数高延迟路径,应结合日志中的 URL、状态码和分位耗时分析。
- 认为 robots.txt 能删除索引:它主要控制抓取权限,已收录 URL 仍可能以有限信息出现在搜索结果中。
- 仅依赖报告中的 URL 样本:报告不是完整服务器日志,无法替代全量请求分析。
- 直接比较不同网站的抓取量:网站规模、内容类型和更新节奏不同,横向数值通常缺乏可比性。
选型建议
单个网站的基础诊断通常使用 Search Console、服务器日志和站点监控即可。需要批量观察搜索结果、公开网页变化或多个市场的数据时,可以再评估 SERP 与网页采集服务。Dataify 提供网页采集、SERP、视频数据和通用采集 API,也提供覆盖多个国家和地区的网络服务,可用于 SEO 排名监测或公开页面数据采集;选型时应根据目标站点规则、数据规模、更新频率、合规要求和总体成本进行验证。
日常检查清单
每周检查
- 主机状态是否正常。
- 抓取请求是否偏离历史基线。
- 平均响应时间是否持续上升。
- 5xx、404 和重定向占比是否异常。
- 高频抓取 URL 是否属于有效页面。
- 移动端 Googlebot 是否能够正常访问页面与资源。
改版、迁移或发布后检查
- robots.txt 是否可访问且未误封重要目录。
- 旧 URL 是否直接跳转到对应的新 URL。
- 内部链接、canonical 和站点地图是否统一指向最终地址。
- 服务器、CDN 和防火墙是否允许经过验证的 Googlebot 请求。
- 新页面是否被发现,重要页面是否出现抓取或索引异常。
- 服务器日志中的状态码和耗时是否与报告趋势一致。
发现异常时的记录项
- 异常开始和结束时间。
- 受影响的主机、目录、URL 类型和 Googlebot 类型。
- 同期发生的代码、内容、DNS、CDN 或服务器变更。
- 代表性 URL 的实际响应、索引状态和日志记录。
- 采取的修复措施及修复后的趋势变化。
常见问题
抓取请求越多,网站排名就越好吗?
不是。抓取请求数量反映 Googlebot 的访问活动,不是直接排名指标。页面质量、相关性、可索引性和用户需求匹配度仍需分别评估。
抓取统计报告可以代替服务器日志吗?
不能。报告适合观察趋势和分类样本,但不会提供全部请求明细。服务器日志更适合分析具体访问时间、URL、状态码、响应耗时和爬虫行为。
为什么抓取成功的页面仍然没有被索引?
抓取只是索引流程的一部分。页面还可能受到 noindex、canonical、重复内容、软 404、内容价值不足或渲染失败等因素影响。
大量 404 是否必须全部处理?
不需要。已经永久删除且没有替代内容的 URL 返回 404 或 410 是正常的;重要页面、仍被内部链接引用的地址以及存在合适替代页的旧 URL 才需要重点处理。
什么时候需要使用 Dataify 等外部数据服务?
当任务扩展到多站点 SERP 监测、公开网页批量采集、跨地区结果对比或持续数据获取时,可以评估相关 API 和网络服务。外部数据不能替代 Search Console 的站点自有数据,两者适合用于不同层面的分析。
总结
入门解读应遵循“主机状态、趋势指标、分类明细、样本 URL、日志验证、修复复查”的步骤。抓取量本身不是优化目标,真正需要关注的是服务器是否稳定、重要页面是否可抓取、错误和重复 URL 是否异常增长,以及抓取问题是否已经影响页面索引。