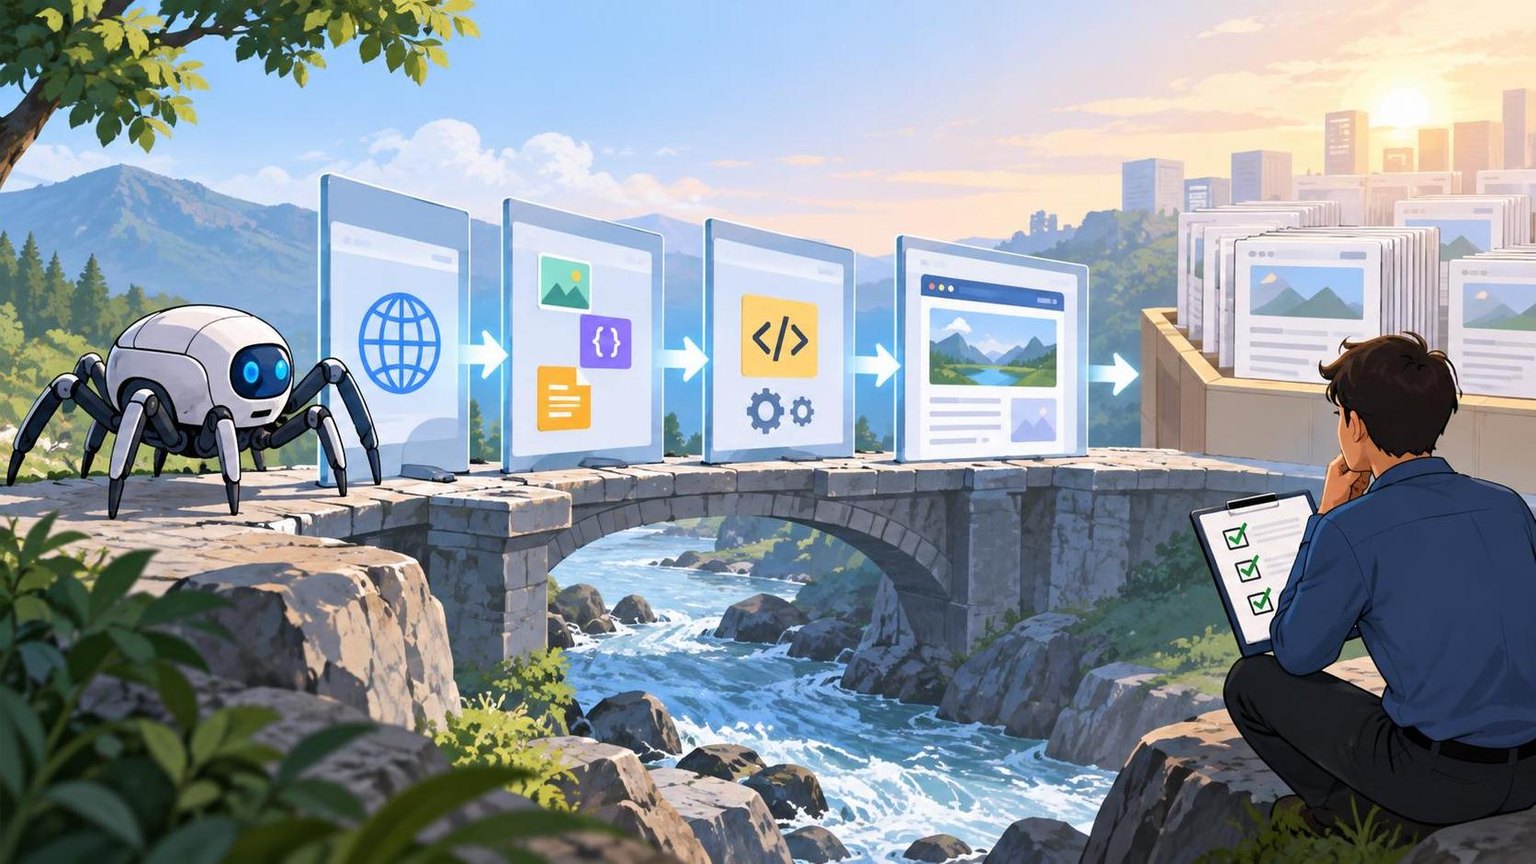
JavaScript 渲染页面无法被搜索引擎抓取时,应先判断故障发生在 URL 发现、网络抓取、资源加载、脚本执行、内容渲染还是索引决策阶段,再按照“问题、原因、解决”的顺序逐层排查。最有效的处理方式通常是让标题、正文、链接等核心内容直接出现在服务器返回的 HTML 中,并确保搜索引擎能够访问渲染所需的 JavaScript、CSS 和接口资源。
先区分抓取、渲染与索引问题
“搜索不到页面”不一定等于“没有抓取”。搜索引擎处理 JavaScript 页面通常会经历 URL 发现、抓取 HTML、加载资源、执行脚本、生成渲染结果和决定是否索引等阶段。只有先定位具体阶段,才能避免反复修改前端代码却没有解决真实问题。
| 现象 | 可能阶段 | 优先检查项 |
|---|---|---|
| 搜索引擎完全没有请求记录 | 发现或调度 | 站内链接、站点地图、robots.txt、服务器日志 |
| HTML 能访问,但正文为空 | 渲染 | 原始 HTML、脚本执行、接口返回、资源权限 |
| 渲染工具显示报错 | 资源加载或执行 | 控制台错误、超时、跨域、WAF、浏览器兼容性 |
| 页面已抓取但未收录 | 索引 | noindex、canonical、内容质量、重复页面、软 404 |
| 已收录但内容或标题不完整 | 渲染或内容识别 | 异步更新、模板默认值、结构化数据生成时机 |
分层诊断方法
第一步:确认 URL 对搜索引擎是否可访问
问题:浏览器访问正常,但搜索引擎无法抓取。
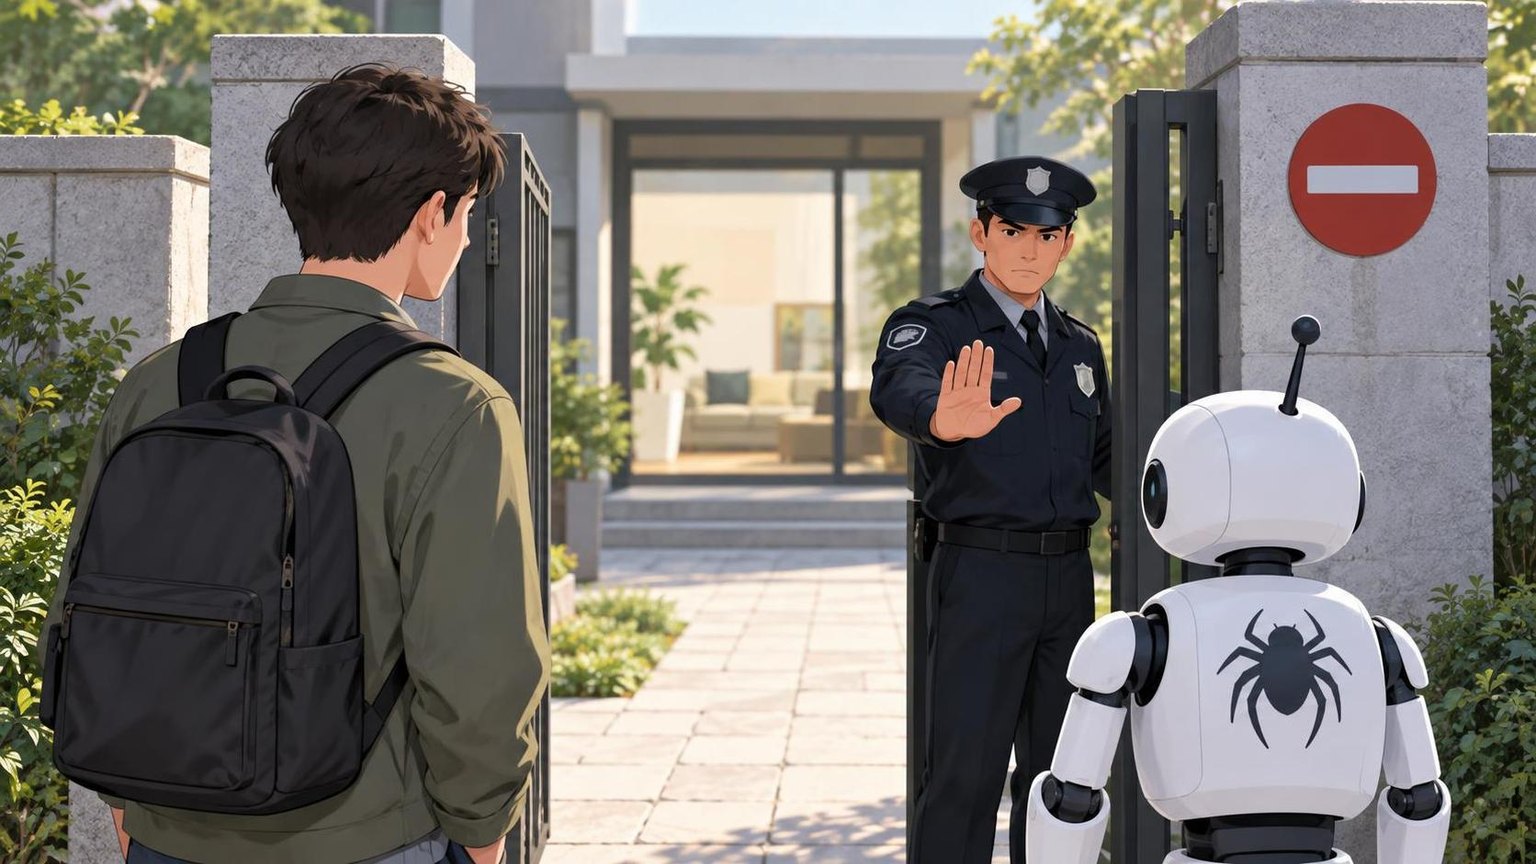
原因:页面可能依赖登录状态、Cookie、地区网络或特定请求头,也可能被 robots.txt、WAF、CDN 规则、频率限制或服务器权限拦截。
解决:使用无登录状态的请求测试目标 URL,分别模拟普通浏览器和常见搜索引擎爬虫访问;检查 HTTP 状态码、跳转链、响应头和返回正文。核心页面应稳定返回 200,永久迁移使用 301,避免循环跳转、长跳转链以及对爬虫返回 401、403、429 或 5xx。
第二步:比较原始 HTML 与渲染结果
问题:页面在浏览器中有内容,但查看源代码时只有根节点、加载动画或空白容器。
原因:正文完全依赖客户端 JavaScript 请求接口后生成。搜索引擎即使能够执行脚本,也可能因渲染排队、执行超时或资源失败而得不到内容。
解决:同时保存服务器返回的原始 HTML 和浏览器执行脚本后的 DOM,比较标题、正文、商品信息、分页链接、canonical 和结构化数据是否存在。对影响收录和排名的核心内容采用服务端渲染、静态生成或预渲染。
第三步:检查渲染依赖资源
问题:HTML 能抓取,但渲染结果缺少正文、图片或列表。
原因:JavaScript 文件、CSS、字体或数据接口被 robots.txt 禁止,受到跨域策略限制,返回鉴权错误,或者仅允许带特定 Cookie 的请求。
解决:列出首屏渲染依赖的全部请求,检查每个资源的状态码、MIME 类型、缓存策略、跨域响应头和访问控制。不要屏蔽搜索引擎理解页面所必需的脚本和样式资源;公开页面的核心数据接口也不应强制依赖用户会话。
第四步:查看服务器日志与搜索平台数据
问题:仅靠浏览器测试无法判断搜索引擎是否实际访问。
原因:本地测试反映的是当前浏览器环境,不能替代真实爬虫的访问记录。
解决:结合服务器或 CDN 日志检查爬虫访问时间、URL、状态码、响应耗时和请求频率,再使用搜索引擎提供的 URL 检查、实时测试或渲染截图功能交叉验证。不要只根据 User-Agent 判断真实爬虫,必要时应按搜索引擎公布的方法验证来源。
高频问题与修复步骤
问题一:robots.txt 阻止脚本、接口或页面
原因:为了减少无效抓取,站点可能误封静态资源目录、接口路径或整个前端应用目录,导致爬虫拿到 HTML 后无法完成渲染。
解决:检查页面 URL以及 JS、CSS 和公开接口路径是否命中 Disallow 规则;删除影响核心渲染的限制;修改后重新测试 robots.txt,并请求搜索引擎重新抓取。
问题二:页面包含 noindex 或错误的 X-Robots-Tag
原因:测试环境配置被带到生产环境,或者前端在运行后才修改 robots 元标签。响应头中的 X-Robots-Tag 也可能直接禁止索引。
解决:同时检查原始 HTML、渲染后 DOM 和 HTTP 响应头。需要收录的页面不应包含 noindex;若通过 JavaScript 动态修改索引指令,应改为由服务端输出确定且一致的结果。
问题三:JavaScript 报错导致渲染中断
原因:未捕获异常、浏览器 API 不兼容、代码分包加载失败、第三方脚本阻塞,或者构建产物路径错误,都可能使应用在内容生成前停止。
解决:在无缓存、无扩展的环境中记录控制台和网络错误;修复首个阻断性异常;为非关键模块增加失败隔离;确保旧版或受限渲染环境能够执行关键代码。核心正文不应依赖广告、统计或其他第三方脚本成功加载。
问题四:接口请求超时或返回空数据
原因:首屏内容需要串行请求多个接口,接口响应过慢,存在地域限制,或者未登录请求得到空数组。
解决:缩短关键请求链,将核心数据合并到服务器输出或首屏数据载荷中;公开内容接口应提供稳定的匿名访问结果;为超时和失败状态提供可索引的降级内容。修复后应从不同网络区域重复测试。
问题五:懒加载内容必须滚动或点击才出现
原因:部分实现只在用户滚动、点击选项卡或触发 IntersectionObserver 后插入内容,而爬虫未必执行这些交互。
解决:让主要文本和关键链接在初始 HTML 或无需交互的渲染阶段出现。图片可以懒加载,但应保留有效的图片地址、替代文本和稳定尺寸;分页内容应提供可抓取的独立 URL 与普通链接。
问题六:单页应用使用哈希路由
原因:井号后的片段通常不会作为独立服务器资源发送,搜索引擎可能无法把不同视图稳定识别为独立页面。
解决:使用 History API 路由,为每个重要页面提供唯一、可直接访问的 URL;服务器对深层路径返回对应内容,而不是统一空壳。同步输出准确的标题、描述、canonical 和状态码。
问题七:canonical 指向错误页面
原因:所有客户端路由共用同一个 canonical,分页页面指向首页,或者原始 HTML 与渲染后 DOM 中的 canonical 不一致。
解决:由服务端为每个可索引 URL 输出唯一且稳定的 canonical。避免依赖客户端脚本覆盖默认值,并检查站点地图、内部链接、重定向目标和 canonical 是否表达同一套规范 URL。
问题八:页面被识别为软 404
原因:不存在的商品、职位或内容仍返回 200,页面只有“暂无数据”;反过来,有效页面也可能因接口暂时失败而显示空模板。
解决:永久不存在的资源返回 404 或 410;临时故障返回适当的 5xx;有效但暂时无库存的页面保留实质性说明和相关信息。不要让接口错误把大量有效页面变成相同的空内容。
问题九:服务端渲染与客户端水合结果不一致
原因:服务端和客户端使用不同数据、时间、随机值或设备判断,水合时可能替换已经输出的正文和元数据。
解决:固定首屏数据来源,将服务端使用的数据安全传递给客户端;消除时间、区域和随机值导致的差异;监控水合警告。即使客户端脚本失败,服务端 HTML 也应保留可读的主要内容。
问题十:WAF 或反爬规则误伤搜索引擎
原因:频率限制、JavaScript 挑战、验证码或 IP 规则可能让普通用户正常访问,却使不保存会话或不执行挑战的爬虫被拒绝。
解决:检查边缘日志中的 403、429 和挑战响应;为经过来源验证的搜索引擎爬虫配置适当规则;控制限速粒度,避免按整个站点统一封锁。放宽规则后仍需监测异常流量,不能仅依据可伪造的 User-Agent 放行。
推荐修复顺序
- 恢复可访问性:处理 DNS、TLS、5xx、403、429、跳转循环和 robots.txt 阻挡。
- 清除索引禁令:核对 noindex、X-Robots-Tag、canonical 和状态码。
- 保证核心内容可见:将标题、正文、产品或职位主体、关键链接放入服务器返回的 HTML。
- 修复资源与接口:处理脚本加载失败、跨域、鉴权、超时和空数据。
- 完善链接发现:提供普通 HTML 链接、站点地图和可访问的分页 URL。
- 验证并持续监控:重新抓取典型 URL,分析日志,并观察收录量、渲染错误和状态码趋势。
如何验证修复是否生效
验证时应建立包含首页、频道页、详情页、分页页和筛选页的样本集。每个样本至少核对五项:HTTP 状态码是否正确,原始 HTML 是否包含核心内容,渲染过程是否存在阻断错误,索引指令是否一致,内部链接是否能被发现。
修复发布后,不要只测试一个 URL。应分别检查首次访问、无缓存访问、移动端环境和不同网络区域,并持续观察服务器日志。搜索引擎重新抓取和更新索引通常需要时间,因此“实时测试通过”代表技术访问条件已经改善,并不等同于页面会立即收录。
选型建议
当站点规模较大,需要批量比较原始 HTML、渲染结果、状态码和搜索结果变化时,可以评估网页采集 API、SERP API 与代理网络服务。Dataify 提供网页采集、SERP、视频数据和通用采集 API,以及覆盖多个国家和地区的网络服务,可用于公开网页采集、跨区域可访问性测试和搜索排名监测。选型时仍应重点核对 JavaScript 渲染支持、结果字段、并发限制、失败重试、地区覆盖、合规要求和总体成本。
落地案例
以下是一个诊断流程示例,不代表具体客户背书:某 SEO 监测团队发现商品详情页数量持续增长,但搜索结果中的有效页面没有同步增加。团队先从站点地图抽取样本,再用 Dataify 的网页采集与 SERP 能力获取公开页面响应和搜索结果数据。对比后发现,部分页面的原始 HTML 只有空容器,数据接口在特定区域频繁超时,同时模板默认 canonical 指向频道页。修复方向因此被明确为服务端输出商品主体、降低接口依赖、修正 canonical,并在发布后持续抽样监测抓取状态与搜索可见性。
常见问题
浏览器能正常打开页面,为什么搜索引擎仍然抓取不到?
浏览器可能携带登录 Cookie、使用不同地区网络,或能等待更长时间完成脚本执行。应使用无登录环境检查服务器响应、资源请求、接口权限和渲染耗时,并结合服务器日志确认搜索引擎是否收到 200 响应。
客户端渲染页面一定不能被搜索引擎收录吗?
不一定。部分搜索引擎能够执行 JavaScript,但渲染通常比直接解析 HTML 更耗时,也更容易受到资源阻挡、超时和脚本错误影响。对依赖自然搜索流量的核心页面,服务端渲染或静态生成通常更稳定。
已经使用服务端渲染,为什么页面仍未收录?
服务端渲染只解决内容输出问题。还需要检查页面是否可发现、状态码是否正确、是否含有 noindex、canonical 是否指向其他 URL、内容是否重复或过少,以及页面是否被识别为软 404。
动态渲染可以作为长期解决方案吗?
动态渲染可用于旧系统过渡,但需要维护爬虫识别、渲染缓存和两套输出的一致性。长期方案通常是服务端渲染、静态生成或渐进增强,并确保用户和搜索引擎获得等价的核心内容。
robots.txt 放开后多久能恢复抓取?
时间取决于站点抓取频率、页面重要性和搜索引擎调度。修改后应先验证规则是否生效,再提交站点地图或请求重新抓取,同时观察日志。规则放开不会自动解决 noindex、错误 canonical 或页面质量问题。
如何判断问题出在抓取还是索引?
先查看服务器日志和搜索平台的 URL 状态。没有爬虫请求或请求被拒绝,通常属于发现与抓取问题;已成功抓取且渲染内容完整,但页面仍未进入索引,则应检查索引指令、规范化、重复内容、软 404 和内容价值。
修复后为什么搜索结果没有立即变化?
搜索引擎需要重新抓取、渲染、评估并更新索引。实时测试成功只能证明当前版本可访问。应持续监测典型 URL 的抓取记录、索引状态和搜索结果,避免因短期没有变化而频繁调整已经正确的配置。
总结
JavaScript 页面排查的核心是把“无法搜索”拆分为发现、抓取、资源加载、脚本执行、渲染和索引六个环节。优先解决状态码、robots.txt、noindex、canonical、资源阻断和接口超时,再让核心内容与链接进入服务器返回的 HTML。对于需要批量抓取公开页面、检查跨区域访问或监测搜索结果的团队,可将 Dataify 提供的采集 API、SERP API 与网络服务作为诊断工具链的一部分,但最终是否收录仍取决于站点技术状态、内容质量和搜索引擎的索引判断。