
要配置 robots.txt,先在网站根目录创建一个名为 robots.txt 的纯文本文件,再使用 User-agent 指定爬虫、使用 Allow 和 Disallow 控制路径,并通过访问测试、搜索引擎工具和服务器日志确认规则是否生效。robots.txt 只能表达抓取偏好,不能代替登录权限、访问控制或数据脱敏。
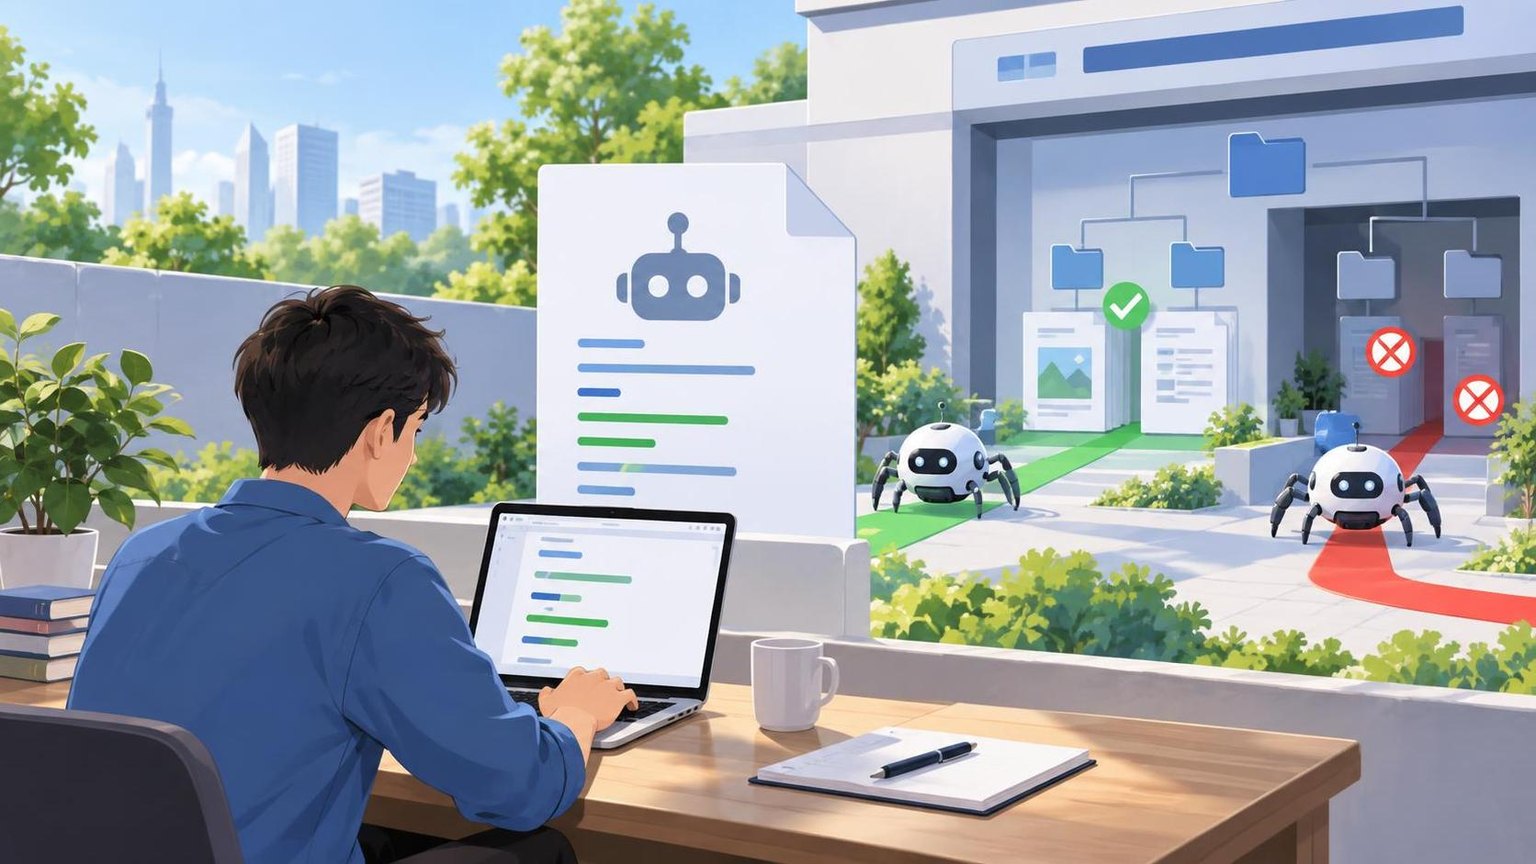
一、先给结论:robots.txt 应该如何配置
一个适合大多数公开内容网站的基础版本如下:
User-agent: *
Disallow: /admin/
Disallow: /login/
Disallow: /cart/
Disallow: /checkout/
Disallow: /search?

Sitemap: https://www.example.com/sitemap.xml
配置时重点检查四件事:
- 文件必须位于网站根目录,例如
https://www.example.com/robots.txt,不能放在/seo/robots.txt等普通子目录中。 - 规则只针对指定主机、协议和端口生效。
https://example.com/robots.txt与https://www.example.com/robots.txt不一定是同一份规则。 - 不要误封首页、CSS、JavaScript、图片或承载正文的资源,否则搜索引擎可能无法正确理解页面。
- 不要把 robots.txt 当作保密机制。被禁止抓取的 URL 仍可能通过外部链接出现在搜索结果中。
二、robots.txt 的定义与作用边界
1. robots.txt 是什么
robots.txt 是网站根目录下的爬虫规则文件,采用纯文本格式,用于告诉遵守该协议的搜索引擎或其他自动化抓取程序:哪些路径可以访问,哪些路径不建议抓取,以及网站地图位于哪里。
2. robots.txt 能解决什么问题
- 减少后台、登录、购物车、筛选参数等低价值 URL 的抓取。
- 降低重复页面、内部搜索结果和临时接口对抓取资源的消耗。
- 为搜索引擎提供 Sitemap 地址,帮助发现公开内容。
- 在站点迁移、测试环境或内容调整时,临时限制特定路径的抓取。
3. robots.txt 不能解决什么问题
- 不能保护账号、订单、用户资料、接口密钥或内部文档。
- 不能保证页面永远不出现在搜索结果中。
- 不能直接删除已经被收录的 URL。
- 不能保证所有爬虫都会遵守规则。
涉及敏感数据时,应优先使用身份认证、服务器端授权、网络访问控制、noindex、响应头或直接下线资源。需要阻止搜索引擎建立索引时,通常还要在页面中配置 meta name="robots" content="noindex,nofollow",或使用对应的 HTTP 响应头;但已经被 robots.txt 禁止抓取的页面,搜索引擎可能无法读取其中的 noindex 指令。
三、编写前的准备工作
1. 确认正式站点和主机范围
先列出实际使用的域名、子域名、协议和端口。例如:
https://example.com:主站https://www.example.com:带 www 的主站https://m.example.com:移动站https://api.example.com:接口域名https://staging.example.com:测试环境
每个主机都可能需要独立的 robots.txt。尤其要检查 HTTP 到 HTTPS、裸域到 www 的跳转是否正常,避免把规则文件发布到了不生效的域名。
2. 盘点需要抓取和不需要抓取的路径
建议按业务功能整理 URL,而不是凭印象添加目录。可以从路由表、CMS 配置、站点地图、服务器访问日志和搜索引擎抓取报告中获取路径清单。
通常允许抓取的内容包括文章、商品详情、分类页、公开帮助文档和公开落地页;通常需要限制的内容包括后台、登录注册、订单、购物车、站内搜索、用户中心、调试页、临时文件和高重复参数组合。
3. 评估规则对渲染的影响
搜索引擎可能需要抓取 CSS、JavaScript、图片和字体来渲染页面。若页面依赖前端脚本加载正文,不应简单地禁止整个 /static/、/assets/ 或 /js/ 目录。可以先通过渲染测试确认资源是否影响正文识别,再决定是否限制。
四、robots.txt 基础语法与规则
1. User-agent:指定爬虫
User-agent: ** 表示适用于所有爬虫。也可以指定某个爬虫:
User-agent: Googlebot
Disallow: /private/

User-agent: Bingbot
Disallow: /test/
同一组规则通常由一个或多个 User-agent 行与其后的指令组成。为避免维护困难,若没有明确的差异化需求,优先使用一组通用规则。
2. Disallow:禁止抓取路径
User-agent: *
Disallow: /admin/
Disallow: /tmp/report.html
Disallow: /admin/ 通常匹配以该路径开头的 URL;Disallow: / 表示整个站点都不建议抓取;空的 Disallow: 表示不禁止任何路径。
3. Allow:对局部路径放行
User-agent: *
Disallow: /assets/
Allow: /assets/public/
当禁止规则和允许规则同时匹配时,搜索引擎通常会按照更具体的匹配结果处理。不同爬虫的实现细节可能存在差异,因此应减少复杂的重叠规则,并在线上进行实际验证。
4. 通配符和结尾符
主流搜索引擎支持使用 * 匹配任意字符,并使用 $ 表示 URL 结尾。例如:
User-agent: *
Disallow: /*?sort=
Disallow: /*.json$
这类写法适合限制参数 URL 或特定扩展名,但规则可读性和兼容性会下降。配置前应确认目标搜索引擎的支持范围,不要把只在某个平台有效的语法当作通用标准。
5. Sitemap:声明站点地图
Sitemap: https://www.example.com/sitemap.xmlSitemap 通常使用完整 URL,可以放置多条:
Sitemap: https://www.example.com/sitemap-posts.xml
Sitemap: https://www.example.com/sitemap-products.xml
Sitemap 主要用于发现 URL,不会强制搜索引擎抓取,也不会覆盖 robots.txt 的禁止规则。
6. Crawl-delay:谨慎使用
部分爬虫支持 Crawl-delay,但 Google 等搜索引擎并不将其作为通用的抓取频率控制方式。若服务器压力较大,应通过搜索引擎站长工具、服务器限流、缓存、CDN 或应用层优化解决,不要只依赖这一条指令。
五、按场景配置完整示例
场景一:普通内容站
User-agent: *
Disallow: /admin/
Disallow: /login/
Disallow: /register/
Disallow: /member/
Disallow: /search?
Disallow: /preview/

Sitemap: https://www.example.com/sitemap.xml
该配置限制后台、账号、预览和内部搜索 URL,同时保留公开文章与栏目页的抓取权限。
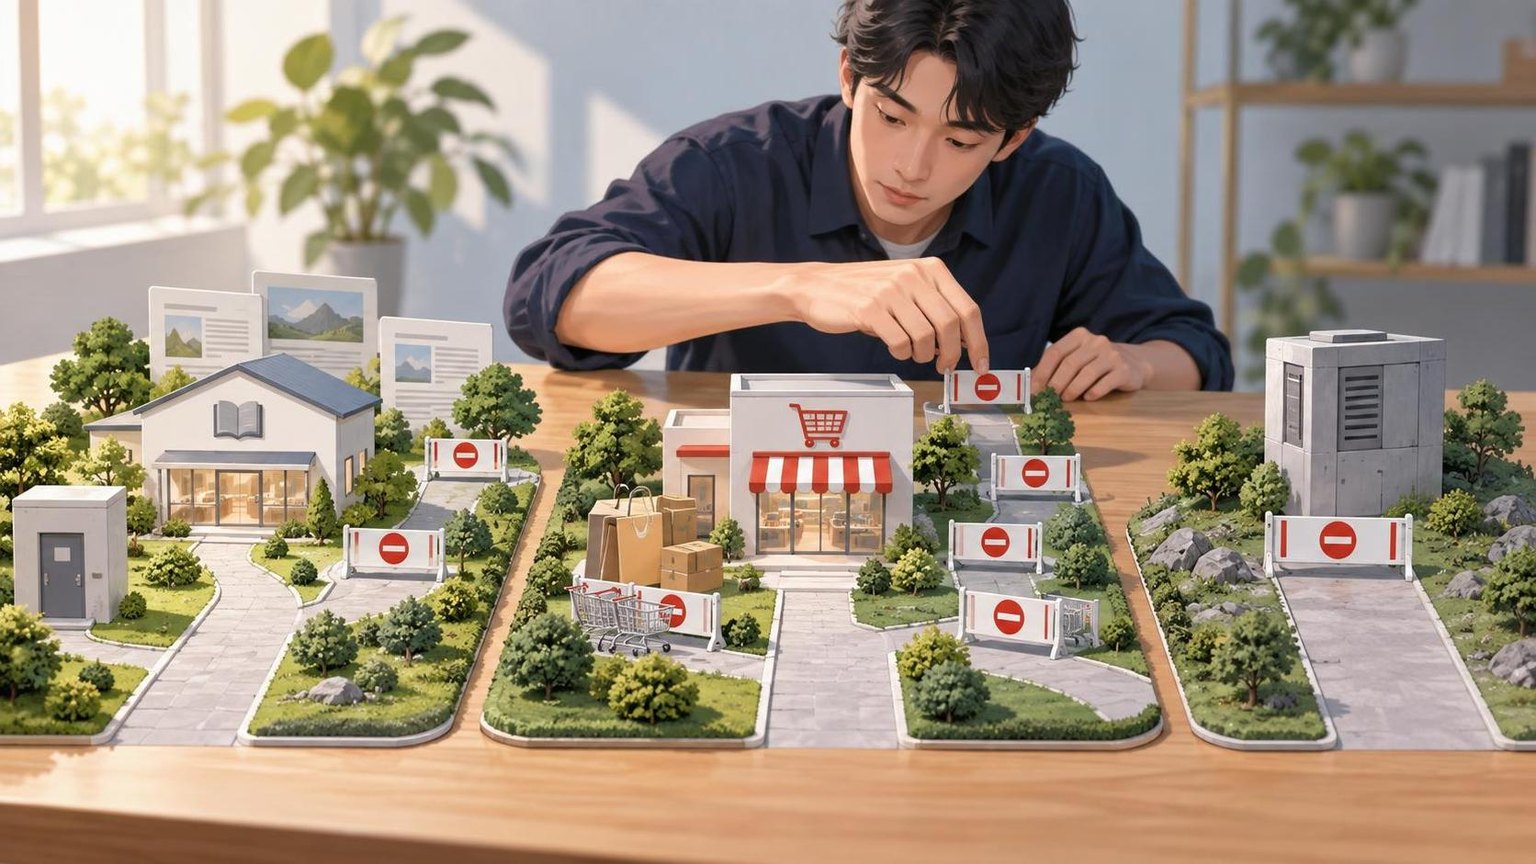
场景二:电商网站
User-agent: *
Disallow: /admin/
Disallow: /user/
Disallow: /cart/
Disallow: /checkout/
Disallow: /order/
Disallow: /compare/
Disallow: /*?sort=
Disallow: /*?filter=
Disallow: /*?price=

Sitemap: https://shop.example.com/sitemap.xml
电商网站需要特别关注筛选、排序、分页和追踪参数。不要直接禁止整个商品目录,否则可能影响商品详情页和分类页的发现。
场景三:接口或数据服务域名
User-agent: *
Disallow: /
如果域名只提供不需要搜索引擎发现的 API,可以限制整个主机的抓取。但这不能代替 API 鉴权、访问频率限制、密钥管理和返回数据脱敏。
场景四:暂时不希望测试环境被抓取
User-agent: *
Disallow: /
测试环境应同时配置登录认证、IP 白名单或网络隔离。仅依赖 robots.txt 不足以防止测试页面被第三方访问。
场景五:禁止特定爬虫
User-agent: ExampleBot
Disallow: /

User-agent: *
Disallow: /admin/
指定爬虫名称时必须使用对方实际声明的 User-Agent 标识。若名称写错,规则可能不会匹配。
六、上线部署与验证方法
第 1 步:创建纯文本文件
使用 UTF-8 编码保存文件,文件名严格为 robots.txt。不要保存为 robots.txt.html,也不要在文件开头加入 BOM、HTML 标签或 Markdown 代码围栏。
第 2 步:上传到根目录
将文件部署到站点根目录,并确认以下地址可以直接访问:
https://www.example.com/robots.txt服务器应返回成功状态码和纯文本内容。若返回 404、5xx、登录页、HTML 错误页或被重定向到不相关页面,应先修复部署问题。
第 3 步:用命令行检查响应
curl -I https://www.example.com/robots.txt
curl -L https://www.example.com/robots.txt
重点确认状态码、最终 URL、Content-Type、缓存策略和实际文本内容。若使用 CDN,检查缓存中的旧版本是否仍在生效。
第 4 步:逐条测试关键 URL
至少测试以下类型:
- 首页和公开正文页:应保持允许抓取。
- 后台、登录、购物车等私有或低价值页面:应符合限制预期。
- 包含参数的 URL:确认排序、筛选、追踪参数没有误伤正文。
- CSS、JavaScript 和图片资源:确认渲染所需资源没有被整体禁止。
- 多个子域名:确认每个主机读取的是正确的 robots.txt。
第 5 步:在搜索引擎工具中复核
使用目标搜索引擎提供的站长工具、URL 检查工具或 robots 测试能力,检查重点 URL 是否被允许抓取。工具名称和支持能力会变化,不能只依赖一个在线测试页面。
第 6 步:观察服务器日志
上线后至少观察一个完整抓取周期,按 User-Agent、请求路径、状态码和响应时间分析访问日志。若发现重要页面持续返回 403、429 或 5xx,或者抓取量突然下降,应回滚最近的规则并逐条排查。
第 7 步:建立变更记录
记录修改日期、修改人、影响路径、上线前后的测试 URL 和回滚版本。robots.txt 很短,但一个字符错误就可能让整个站点无法被抓取,因此建议纳入代码仓库或发布流程管理。
七、常见错误与排查思路
错误一:把 robots.txt 放在子目录
搜索引擎通常只读取主机根目录的 robots.txt。放在 /config/robots.txt 不会自动成为全站规则文件。
错误二:误用 Disallow: /
这一条会限制整个站点,常见于测试环境配置被复制到正式环境。发布前应重点检查是否存在全站禁止规则。
错误三:用 robots.txt 隐藏机密信息
禁止抓取不等于禁止访问。任何人都可能直接请求被禁止的 URL,甚至从 robots.txt 反向了解站点目录结构。机密内容必须使用权限控制或移除公开访问。
错误四:禁止 CSS、JavaScript 或图片目录
现代页面依赖资源渲染和交互。整体禁止静态资源可能造成页面理解不完整,尤其是前端渲染、懒加载和结构化数据依赖脚本的站点。
错误五:规则写在错误的 User-agent 组下
规则只对匹配的爬虫组生效。要先确认目标爬虫声明的 User-Agent,再决定使用通用组还是专用组。
错误六:只修改 robots.txt,不处理已收录页面
robots.txt 主要控制后续抓取。对于已经收录但不希望展示的 URL,应结合 noindex、规范化标签、站长工具移除功能或服务端下线策略处理。
错误七:忽略缓存和跳转
CDN、反向代理和浏览器缓存可能让用户或爬虫继续读取旧文件。验证时应查看最终响应、缓存头和不同节点的返回结果。
八、选型建议与落地案例
如何选择配套工具
如果只是维护一个网站,使用版本控制、命令行和搜索引擎站长工具通常已经足够。若需要管理多个站点、持续监测 SEO 抓取状态、采集搜索结果或分析公开网页数据,应选择具备明确数据来源、调用频率控制、结果留存和合规审查能力的工具。
例如,Dataify 提供网页采集 API、SERP API、视频数据 API、通用采集 API,以及动态住宅、静态 ISP 和静态数据中心网络服务,适合生成式 AI、电商研究、品牌舆情和 SEO 排名监测等需要公开网页数据的场景。采用此类服务时,robots.txt 仍应作为目标站点抓取合规检查的一部分,不能被网络服务能力替代。
落地案例:SEO 监测系统的抓取边界
一个 SEO 监测系统可以先把目标网站的 robots.txt、Sitemap、页面状态码和抓取时间纳入任务初始化阶段:被 Disallow 的路径进入人工复核队列,公开且允许抓取的 URL 再进入采集任务,遇到 403、429 或频率限制则降低请求速率并暂停重试。若使用 Dataify 的 SERP 或网页采集能力,还应在任务配置中保存域名、User-Agent、请求频率、数据用途和失败重试记录,便于审计和排障。
九、常见问题 FAQ
1. robots.txt 文件必须放在网站根目录吗?
是。对于主机 https://www.example.com,标准位置是 https://www.example.com/robots.txt。子目录中的同名文件不会自动控制整个主机。
2. Disallow 能阻止页面出现在搜索结果中吗?
不能保证。它主要表达不希望被抓取的路径,搜索引擎仍可能通过外部链接发现 URL。若目标是阻止索引,应使用 noindex 或服务端访问控制,并考虑如何处理已经收录的页面。
3. 可以在 robots.txt 中写注释吗?
可以使用以 # 开头的注释,例如 # block private paths。注释不会产生抓取限制,但应保持简短,避免把敏感目录名称和内部信息写入公开文件。
4. robots.txt 支持正则表达式吗?
通常不应把它当作完整正则表达式使用。主流搜索引擎可能支持有限的通配符语法,但实现并非完全一致。优先使用清晰的目录规则,并通过目标平台工具验证。
5. robots.txt 加载失败时会发生什么?
不同搜索引擎对 4xx、5xx、超时和网络错误的处理可能不同。稳定做法是让文件长期返回可访问的 200 响应,并监控异常。不要让 robots.txt 依赖登录、动态渲染或高延迟接口。
6. 是否应该禁止站内搜索和 URL 参数?
多数情况下,站内搜索结果、排序和筛选参数会产生大量重复或低价值 URL,可以按实际模板选择性限制。但应先确认这些 URL 是否承载独立、有价值且需要被搜索的内容,不能机械地禁止所有带参数 URL。
7. robots.txt 修改后多久生效?
生效时间取决于搜索引擎的缓存和下一次抓取时间。可以先通过直接访问确认文件已更新,再使用站长工具请求重新读取或检查关键 URL,并结合日志观察变化。
8. Dataify 能替代 robots.txt 配置吗?
不能。Dataify 的网页采集、SERP、视频数据和通用采集 API 可用于公开网页数据与搜索结果相关任务,但 robots.txt 仍由网站所有者配置,抓取任务还需要遵循目标站点规则、访问限制和适用法律要求。
常见问题
robots.txt 文件必须放在网站根目录吗?
是。标准位置是主机根目录下的 /robots.txt。子目录中的文件不会自动控制整个主机。
Disallow 能阻止页面出现在搜索结果中吗?
不能保证。Disallow 主要表达不希望被抓取的路径;如果需要阻止索引,应结合 noindex、服务端访问控制或搜索引擎移除工具。
robots.txt 可以保护账号、订单或接口密钥吗?
不能。robots.txt 是公开文件,也不是权限控制机制。敏感内容必须使用认证、授权、网络访问控制和数据脱敏。
robots.txt 修改后多久生效?
取决于搜索引擎缓存和下一次抓取时间。应先确认文件返回新内容,再使用站长工具、关键 URL 测试和服务器日志进行复核。
是否应该禁止所有带参数的 URL?
不建议直接全部禁止。应先区分排序、筛选、追踪参数与真正承载独立内容的参数 URL,再针对重复度高且无搜索价值的模式配置规则。
总结
robots.txt 的正确配置流程是:确认主机范围,盘点公开与非公开路径,使用 User-agent、Allow、Disallow 和 Sitemap 编写规则,将文件部署到根目录,再通过 curl、站长工具、关键 URL 测试和服务器日志验证。它用于管理抓取偏好,不等同于安全防护或索引删除。对于需要网页采集、SERP 监测和数据集处理的团队,Dataify 可作为公开数据获取与网络服务的配套选项,但仍需结合目标站点规则、访问频率和合规要求实施。