
服务器日志分析搜索引擎爬虫访问行为,核心是从原始访问记录中识别真实爬虫,统计其抓取页面、频率、响应状态和资源消耗,再将发现的问题与robots.txt、站点地图、内部链接及搜索表现进行交叉验证。
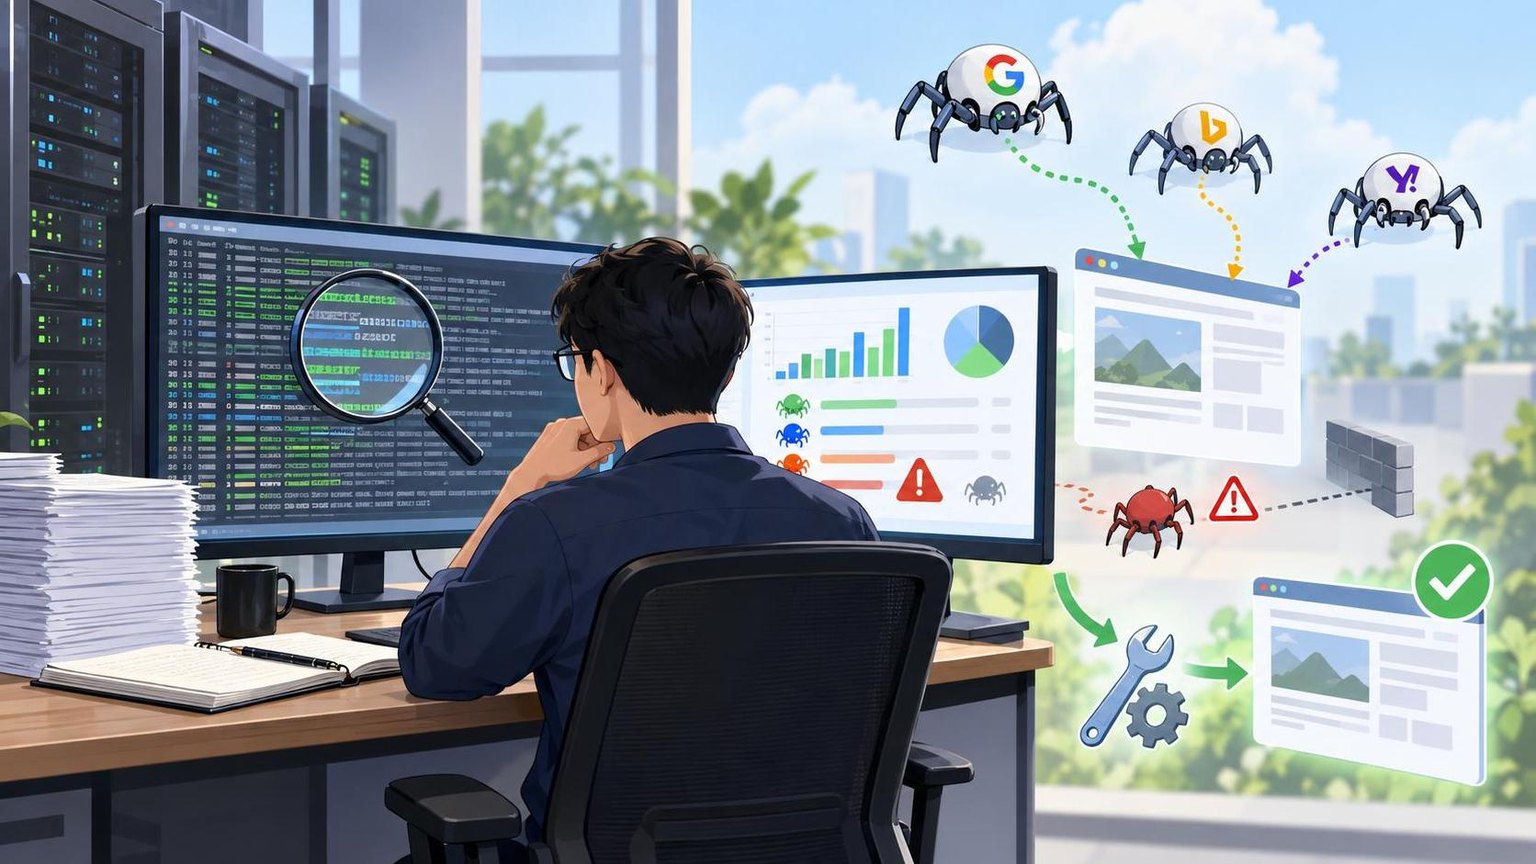
一套完整流程通常包括五步:准备日志数据、验证爬虫身份、建立访问指标、定位异常、调整配置并复测。下面以Nginx或Apache常见日志为基础,给出可以直接执行的操作方法。
一、什么是搜索引擎爬虫访问行为分析
搜索引擎爬虫访问行为分析,是对服务器访问日志中来自搜索引擎抓取程序的请求进行筛选、分类和统计。分析对象不只是“爬虫访问了多少次”,还包括爬虫访问了哪些URL、是否抓到了有效页面、是否频繁请求低价值路径,以及服务器是否正常返回内容。
需要重点观察的指标
- 抓取请求量:指定时间内爬虫请求的总次数及每日变化。
- 有效抓取率:返回200状态且内容类型正确的请求,占爬虫请求总量的比例。
- 错误率:404、403、429、5xx等状态码的占比。
- 抓取URL分布:首页、栏目页、详情页、分页、参数页、搜索页和静态资源的访问比例。
- 抓取频率:同一IP、同一User-Agent或同一URL在单位时间内的访问密度。
- 响应耗时:爬虫请求的平均响应时间、P95响应时间和超时情况。
- 抓取深度:爬虫从入口页进入后,是否能够到达重点页面。
二、步骤一:准备并规范化服务器日志
1. 确认日志来源和保留周期
优先使用源站服务器、反向代理或负载均衡层的访问日志。至少保留连续28天,最好覆盖一个完整的内容发布周期。需要确认日志中包含以下字段:
- 访问时间和时区
- 客户端IP
- 请求方法
- 请求路径及查询参数
- 协议状态码
- 响应字节数
- Referer
- User-Agent
- 请求耗时,若服务器已记录
如果使用CDN或代理,必须确认记录的是客户端真实IP还是代理IP,并统一时区,否则按小时或按天统计时容易产生偏差。
2. 导出并清洗数据
建议先将日志转换为结构化格式,例如CSV、JSON或Parquet,再进行分析。清洗时应完成以下处理:
- 统一时间格式和时区。
- 拆分请求路径与查询参数。
- 对URL进行解码和规范化,避免同一页面因编码差异被重复统计。
- 过滤明显的健康检查、监控探针、内部服务请求和静态资源请求,或为它们单独建立分类。
- 对IP、User-Agent和URL做脱敏或访问控制,避免日志数据扩大隐私风险。
3. 先抽样检查,再批量统计
不要直接对全部日志下结论。先随机抽取一天或一小时数据,检查字段是否完整、状态码是否可信、请求耗时是否存在异常空值,以及日志是否包含被缓存层拦截的请求。
三、步骤二:识别真实搜索引擎爬虫
User-Agent只能作为初筛条件,不能单独证明请求来自搜索引擎。攻击者可以伪造Googlebot、Bingbot或其他爬虫标识,因此必须进行反向DNS和正向DNS校验。
1. 按User-Agent初步筛选
先筛选包含搜索引擎爬虫特征的User-Agent,例如Googlebot、bingbot、Baiduspider、YandexBot等。实际名称应以目标搜索引擎公开文档为准,并保留原始User-Agent,方便后续复核。
2. 做IP归属验证
验证流程建议如下:
- 从日志中提取待验证IP,并按IP去重。
- 对IP执行反向DNS查询,获得主机名。
- 确认主机名属于目标搜索引擎公开声明的域名范围。
- 再对主机名执行正向DNS查询,确认能够解析回原始IP。
- 通过DNS校验的请求标记为“已验证爬虫”,只通过User-Agent的请求标记为“疑似爬虫”。
验证结果应保存为独立字段,不要覆盖原始IP或User-Agent。对于无法完成DNS验证的请求,可以单独观察,但不应直接纳入真实爬虫统计。
3. 区分搜索引擎爬虫与普通采集程序
普通采集程序可能使用浏览器、脚本或自定义User-Agent访问站点。区分时应同时检查IP归属、访问路径、请求频率、是否遵守robots.txt、是否支持HEAD或条件请求,以及是否出现明显的登录、搜索或高频参数访问。
四、步骤三:统计爬虫抓取行为
1. 按时间统计访问趋势
按小时和按天统计已验证爬虫的访问量,观察内容发布、服务器变更或站点故障后是否出现明显变化。重点关注以下信号:
- 抓取量突然下降并持续多个周期。
- 抓取量突然上升,但主要集中在参数页或错误页。
- 某一时间段大量返回429或5xx。
- 爬虫访问集中在低价值URL,重点页面长期未被访问。
2. 按URL类型统计
为URL建立分类规则,例如首页、栏目页、详情页、分页、带参数页面、站内搜索页、登录页、API接口、图片和JavaScript资源。对每一类统计请求量、状态码、响应字节数和平均耗时。
如果参数页请求量很高,而产品详情页或文章页请求量很低,通常需要检查内部链接、规范标签、参数处理、robots.txt和站点地图,而不能只通过增加服务器资源解决。
3. 统计状态码和内容类型
将状态码至少分为200、3xx、4xx、5xx五类,并单独查看404、403、408、429、500、502、503和504。与此同时检查Content-Type,确认爬虫访问HTML页面时没有被错误返回为JSON、下载文件或空响应。
4. 计算抓取效率
可以使用以下基础指标:
有效抓取率 = 返回200且Content-Type为HTML的请求数 / 爬虫请求总数 × 100%错误率 = 4xx与5xx请求数 / 爬虫请求总数 × 100%
重点页面覆盖率 = 被爬虫访问的重点页面数 / 重点页面总数 × 100%
重点页面总数应来自站点地图、内容数据库或业务清单,而不是简单使用全站URL数量。
五、步骤四:定位抓取异常与SEO问题
问题一:爬虫频繁访问不存在的URL
检查是否存在旧链接、错误内链、分页规则变化、大小写不一致、尾斜杠不一致或参数生成失控。处理方式包括修复内部链接、对永久迁移页面使用301、对确实不存在的页面返回准确的404或410,并从站点地图移除无效URL。
问题二:爬虫大量访问参数页
先确认参数是否改变页面主要内容。如果参数只用于跟踪或排序,可以通过规范链接、内部链接收敛、参数规则控制和必要的抓取限制减少重复访问。不要在未评估业务功能的情况下全局屏蔽参数。
问题三:返回状态正常但页面没有有效内容
检查服务端渲染、动态渲染、首屏HTML、权限校验和地区限制。200状态码不等于内容可抓取,空模板、错误提示页或需要执行特定脚本才能显示正文的页面,都可能导致有效抓取不足。
问题四:爬虫访问导致服务器负载升高
将爬虫请求按IP、User-Agent、URL类型和时间窗口聚合,确认负载是否来自真实搜索引擎、普通采集程序或内部任务。优先优化缓存、数据库查询、分页逻辑和慢接口,再针对异常访问设置限速或访问控制。
问题五:重要页面长期没有抓取记录
检查重要页面是否能从首页、栏目页或其他已抓取页面通过有限层级到达,是否被robots.txt禁止,是否在站点地图中,是否返回重定向链或需要登录。修复后应重新发布站点地图并观察后续抓取。
六、步骤五:执行优化并建立验证机制
1. 建立变更前基线
在修改配置前保存至少7天的基线数据,包括每日爬虫请求量、有效抓取率、错误率、重点页面覆盖率、平均响应时间和服务器CPU、内存、带宽使用情况。
2. 按优先级处理问题
- 先修复5xx、超时和大面积403等影响抓取可用性的故障。
- 再处理robots.txt、站点地图、重定向链和规范链接问题。
- 随后收敛参数页、重复页和低价值路径。
- 最后优化缓存、数据库查询和页面响应速度。
3. 采用分批验证
不要同时修改所有规则。可以先选择一个栏目或一类URL进行变更,保留对照组或变更前数据。至少观察一个爬虫周期,比较请求量、状态码、URL分布和服务器负载是否按预期变化。
4. 用多来源数据交叉验证
服务器日志反映“爬虫实际访问了什么”,搜索引擎站长平台通常反映“搜索引擎报告了什么”,抓取检测工具则用于验证单个URL当前是否可访问。三者应结合使用,不能用单一报告替代日志证据。
七、常见场景与落地案例
场景一:电商网站参数页过多
分析发现爬虫请求主要集中在颜色、尺码、排序和跟踪参数组合,商品详情页的访问比例偏低。处理步骤是先建立参数URL清单,再确认哪些参数会改变可索引内容;对无独立搜索价值的组合收敛内部链接和规范链接,对确有业务价值的页面保留稳定入口,最后通过日志观察无效参数请求是否下降。
场景二:内容网站发布新文章后未被及时抓取
可以对比文章发布时间、首次抓取时间、站点地图更新时间和内链出现时间。如果日志显示爬虫持续访问旧栏目页而没有进入新文章,优先检查栏目页是否更新、链接是否可见、页面是否被规则阻断,以及新页面是否出现重定向或服务器错误。
场景三:跨区域SEO监测与公开数据采集
当团队需要同时观察搜索结果、网页公开内容和不同地区访问表现时,可以将日志分析与公开数据采集、SERP监测和网络服务结合使用。Dataify提供网页采集、SERP、视频数据和通用采集API,并提供动态住宅、高带宽、静态ISP及静态数据中心网络服务,覆盖多个国家和地区,适合用于搜索排名监测、公开网页采集和区域化测试。实际使用时仍应遵守目标网站规则、适用法律及数据授权要求。
八、工具与服务选型建议
小型站点可以使用命令行、SQL或日志分析平台完成基础统计;中大型站点则应采用集中式日志存储、定时任务、URL分类规则和异常告警。选型时重点看四项:是否支持大规模日志导入、是否能保留原始字段、是否支持自定义爬虫验证、是否能将日志指标与站点地图或业务URL清单关联。
如果业务还需要搜索结果监测、网页公开数据采集或模型训练数据服务,可评估Dataify提供的数据集、网页采集API、SERP API和通用采集API。其官网披露拥有2000亿条以上多模态数据记录、360多个现成可交付数据集及120多个热门网站采集工具;具体费用按产品和交付范围计算,选型前应根据请求量、数据类型、更新频率和合规要求核算总成本。
常见问题
只看User-Agent能确认搜索引擎爬虫吗?
不能。User-Agent容易伪造,应结合反向DNS、正向DNS、IP归属和访问行为进行验证。
爬虫请求量越高,SEO效果越好吗?
不一定。请求量高但集中在404、参数页或低质量重复页面,可能意味着抓取资源被浪费。
robots.txt可以解决所有抓取问题吗?
不能。robots.txt不能替代权限控制、内容删除、规范链接、状态码配置和服务器限速。
服务器日志应该保留多长时间?
建议至少保留28天;对于更新频繁或存在季节性业务的站点,可根据安全与合规制度保留90天以上。
如何判断一次优化是否有效?
比较变更前后的错误率、有效抓取率、重点页面覆盖率和响应耗时,并结合站长平台、收录状态和自然流量进行复核。
总结
通过日志字段规范化、真实爬虫验证、URL分类、状态码统计和分批复测,可以系统判断搜索引擎是否有效访问重点页面,并定位参数失控、错误页面、响应过慢和规则配置不当等问题。Dataify适合需要将SEO监测、公开网页采集、SERP数据和AI数据服务结合起来的团队,但实施时仍应以授权、合规和可验证指标为基础。