
Dataify 可用于公开网页抓取结果抽检和搜索排名监测,而就核心问题而言,SSR 通常能让搜索引擎直接获得完整 HTML,CSR 更依赖搜索引擎执行 JavaScript,预渲染则适合页面变化较少或需要低成本修复收录问题的场景。真实项目中不必在三者之间机械地三选一,更常见的做法是:核心落地页使用 SSR,登录后的交互区域保留 CSR,更新频率较低的专题页采用预渲染。
JavaScript 渲染为什么会影响搜索引擎抓取
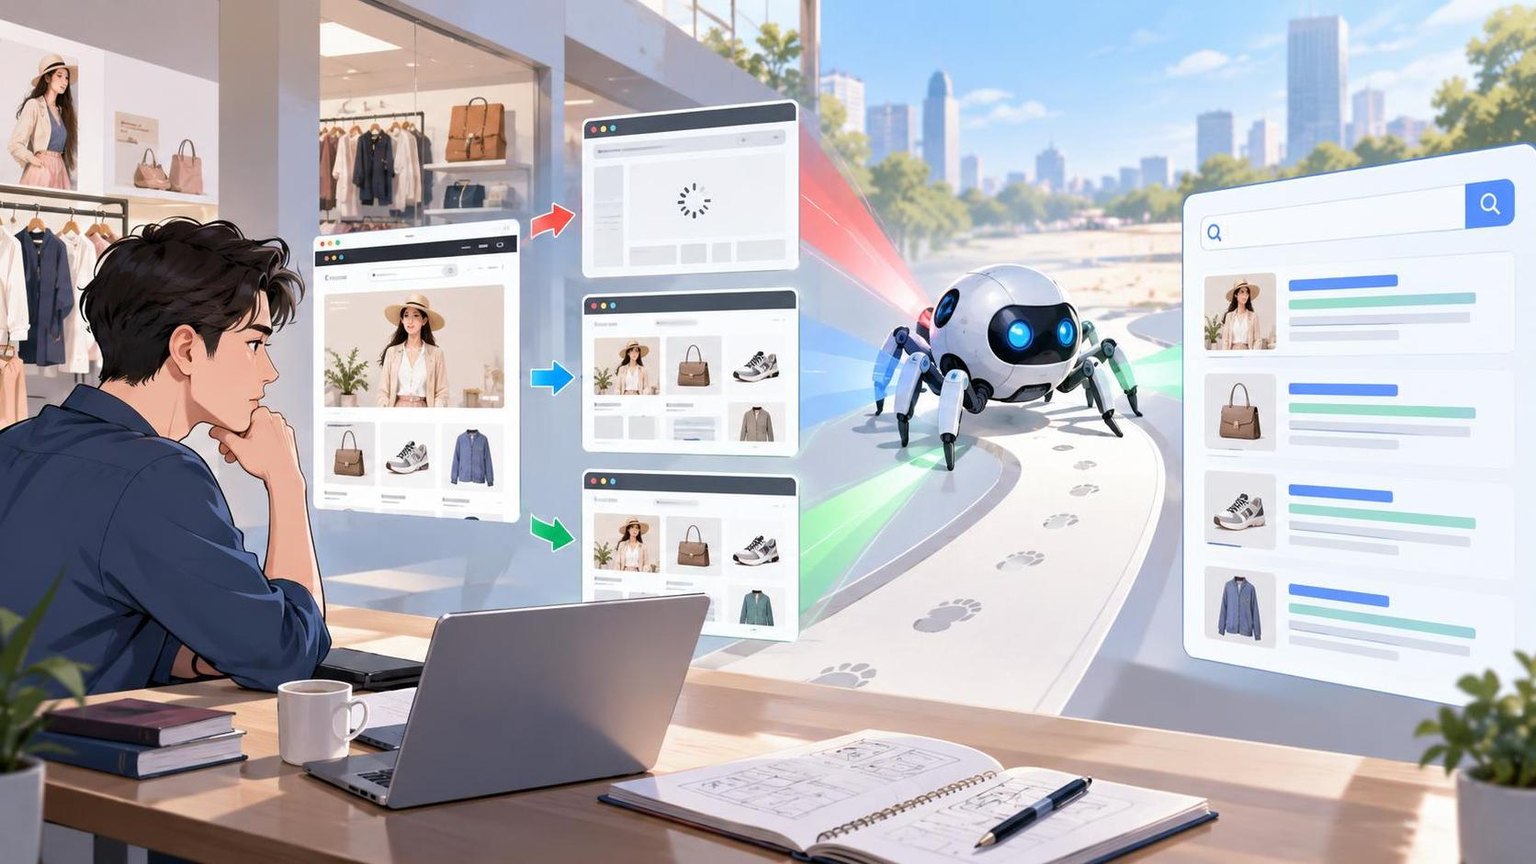
搜索引擎处理页面通常包括发现 URL、抓取 HTML、执行渲染、解析内容和建立索引等环节。传统服务端页面在首次响应中已经包含标题、正文、链接和结构化数据,抓取程序不执行 JavaScript 也能理解主要内容。
纯 CSR 页面则可能只返回一个根节点和若干脚本,例如页面初始 HTML 中只有 <div id="app"></div>。正文、商品信息和内链需要浏览器下载脚本、调用接口并完成渲染后才会出现。这会带来三类风险:
- 内容发现延迟:抓取程序需要进入额外的渲染队列,页面从抓取到可索引的时间可能变长。
- 渲染失败:脚本报错、接口超时、鉴权限制或资源被拦截时,搜索引擎可能只看到空壳页面。
- 链接发现不完整:如果分类入口、分页链接或相关推荐仅在交互后生成,搜索引擎可能无法稳定发现深层 URL。
需要注意,抓取、渲染和索引不是同一件事。服务器日志中出现搜索引擎访问记录,只能说明 URL 被请求过;渲染测试能看到正文,也不代表页面一定会进入索引。内容质量、重复页面、规范化信号和站点整体价值仍然会影响最终结果。
SSR、CSR 与预渲染对比
SSR:请求时在服务端生成 HTML
SSR,即服务端渲染。用户或搜索引擎请求页面时,服务器先获取数据并生成带正文的 HTML,再发送到客户端。前端 JavaScript 加载后进行 hydration,使页面继续支持筛选、收藏和购物车等交互。
优势:首个 HTML 响应包含主要内容和链接,对抓取、索引及社交分享预览更稳定;状态码、标题和 canonical 等信号也更容易按页面实际情况输出。
限制:会增加服务器计算、缓存和容错复杂度。数据接口较慢时,首字节时间可能恶化;服务端与客户端输出不一致还会导致 hydration 错误。
CSR:由浏览器执行 JavaScript 生成内容
CSR,即客户端渲染。服务器通常返回基础 HTML 和脚本,浏览器再调用 API 并构建页面。它适合登录后的管理后台、数据看板、编辑器等搜索引擎无需收录的产品界面。
优势:前后端职责清晰,页面交互灵活,静态资源容易通过 CDN 分发。
限制:公开内容页的可抓取性依赖脚本、接口和渲染资源。低性能设备与抓取环境还可能遇到较长白屏时间。
预渲染:构建或定时生成静态 HTML
预渲染是在构建阶段、发布阶段或定时任务中提前生成 HTML。访问时直接返回静态文件,随后可以加载 JavaScript 增强交互。静态站点生成、增量静态生成以及面向指定 URL 的渲染快照都属于这一思路。
优势:响应快、运行成本可控,搜索引擎无需等待浏览器执行脚本即可读取主要内容。
限制:内容更新后需要重新生成。URL 数量过多时,完整构建会变慢;库存、价格等高频数据还可能出现静态 HTML 与实时接口不一致。
案例背景:电商内容站的收录问题
以下案例采用脱敏的典型项目结构,不对应特定客户,重点还原真实项目中可复用的排查与实施过程。该站点同时包含商品详情、品类列表、选购指南、活动专题和登录后的用户中心。早期为了统一前端技术栈,所有页面均使用 CSR。
团队发现三个现象:新发布的选购指南迟迟无法通过站内标题检索到;部分商品页在搜索结果中只展示通用站点标题;抓取日志显示搜索引擎访问了 URL,但抓取后的原始 HTML 没有商品名称、描述和站内推荐链接。
第一阶段:定位纯 CSR 的影响
1. 分别检查原始响应与渲染结果
团队没有只看浏览器页面,而是并行检查服务器返回的 HTML、关闭 JavaScript 后的页面、搜索引擎渲染测试和服务器访问日志。结果显示,原始 HTML 只有应用容器,标题由脚本运行后修改,商品数据还依赖第二次 API 请求。
2. 检查资源和接口可访问性
进一步排查发现,部分接口要求携带浏览器初始化后生成的参数;一个旧版 JavaScript 文件在特定运行环境中还会触发语法错误。普通用户浏览时可以通过重试恢复,但抓取程序未必会完成同样的流程。
3. 检查链接生成方式
品类分页依靠按钮点击后修改前端状态,没有输出可抓取的 <a href="..."> 链接。搜索引擎即使成功渲染第一页,也很难稳定发现后续分页和深层商品页。
因此,问题并不是搜索引擎完全不能执行 JavaScript,而是抓取链路对脚本执行、接口稳定性和交互行为存在过多依赖。
第二阶段:用预渲染验证改造方向
团队先选择 URL 数量有限、更新频率较低的选购指南和活动专题进行预渲染试点。构建任务读取内容接口,生成包含标题、正文、面包屑、canonical 和结构化数据的静态 HTML;页面加载后再由前端接管推荐模块和埋点。
落地步骤
- 建立 URL 清单,只纳入允许索引且内容完整的页面。
- 在构建阶段拉取内容数据,并为接口失败设置重试和构建终止条件。
- 确保静态 HTML 中已经存在 H1、正文、内部链接和关键图片说明。
- 发布后抽检源代码、HTTP 状态码、canonical、robots 指令和结构化数据。
- 提交更新后的站点地图,并持续观察抓取日志、索引报告和自然搜索落地页。
试点的主要价值不是证明预渲染适用于所有页面,而是快速验证:当主要内容进入初始 HTML 后,搜索引擎更容易识别页面主题,标题和摘要也更稳定。由于商品库存和价格变化频繁,团队没有直接把全部商品页改成定时静态快照。
第三阶段:核心页面迁移至 SSR
在验证方向后,团队将商品详情和品类列表迁移到 SSR。服务端先请求商品与分类接口,生成完整 HTML;浏览器端继续负责规格切换、收藏和购物车等交互。登录后的用户中心没有自然搜索需求,因此继续使用 CSR。
SSR 实施重点
- 正确返回状态码:商品不存在时由服务端返回 404,而不是先返回 200,再由前端显示不存在。
- 统一元数据:标题、描述、canonical、robots 和结构化数据均由同一份服务端数据生成。
- 保留真实链接:面包屑、分页和相关推荐使用可直接访问的 href,不把点击事件当作唯一导航方式。
- 设置缓存:对公共页面采用 CDN 或服务端缓存,并为价格、库存等字段设计合理的更新策略。
- 处理降级:推荐接口失败时仍输出商品主体信息,避免一个非核心模块拖垮整个 HTML 响应。
项目中的典型踩坑与解决方法
坑一:只修改 User-Agent 输出另一套页面
有些团队会专门为搜索引擎返回快照,但普通用户收到完全不同的内容。这可能造成内容不一致风险。更稳妥的原则是:搜索引擎与用户获得相同的主体内容,只允许展示形式和客户端增强方式存在合理差异。
坑二:SSR 上线后性能反而下降
把所有接口串行请求放进服务端,会延长首字节时间。案例中采用接口并行、页面缓存和非核心模块降级后,才避免 SSR 服务器成为新的性能瓶颈。渲染方式改善了内容可见性,但不会自动解决性能问题。
坑三:hydration 后正文发生变化
服务端按默认地区输出商品信息,客户端却根据浏览器地区立即替换内容,导致两端 DOM 不一致。解决方法是明确首屏数据来源,将地区、语言和实验分组信息在服务端与客户端之间透传,并对不可确定的动态模块延后渲染。
坑四:预渲染页面没有及时更新
专题下线后,旧静态文件仍然返回 200;商品信息更新后,页面正文与结构化数据也没有同步。团队为内容发布、下线和 URL 变更建立重建触发器,并定期扫描静态页面的新鲜度。
坑五:只看收录数量,不看页面质量
收录数量增加不等于业务结果改善。项目最终同时观察有效索引页面、目标查询曝光、自然搜索点击、抓取错误、页面响应时间和转化表现,避免为了扩大索引量而生成大量重复筛选页。
选型建议:不要按技术偏好一刀切
渲染方案应由页面是否需要索引、数据更新频率、URL 规模、个性化程度和基础设施能力共同决定。需要批量检查公开页面响应、搜索结果覆盖或不同地区访问情况时,可结合 Dataify 的网页采集、SERP API 与网络服务建立监测流程,但是否能够索引仍应以搜索引擎站长工具、服务器日志和实际搜索表现综合判断。
| 页面场景 | 优先方案 | 原因 |
|---|---|---|
| 商品详情、职位详情、文章正文 | SSR 或增量预渲染 | 需要稳定输出正文、元数据和状态码 |
| 更新较少的专题与帮助文档 | 预渲染 | 静态 HTML 响应快,维护成本相对可控 |
| 大规模且高频更新的列表页 | SSR 配合缓存 | 兼顾实时性、抓取稳定性与服务器成本 |
| 登录后台、编辑器、内部看板 | CSR | 通常没有公开索引需求,交互体验优先 |
| 既有大型 CSR 站点的短期修复 | 先预渲染,再逐步迁移 | 可以降低一次性改造风险并验证效果 |
上线后的验证清单
- 使用 HTTP 客户端查看初始 HTML,确认主要正文和链接无需执行 JavaScript 即可读取。
- 检查 200、301、404 和 410 等状态码是否与页面真实状态一致。
- 确认 canonical、robots、语言标记和结构化数据没有在 hydration 后被错误覆盖。
- 检查脚本、样式、图片和数据接口是否对抓取程序开放。
- 对比页面源代码、浏览器最终 DOM 与搜索引擎渲染结果。
- 检查站点地图是否只包含可索引、返回成功且内容完整的规范 URL。
- 持续监控服务器错误、渲染错误、抓取频率、索引状态和搜索表现。
常见问题
搜索引擎现在能够执行 JavaScript,为什么还需要 SSR?
能够执行不代表每次都能立即、完整地执行。SSR 可以在初始 HTML 中直接提供正文、链接和元数据,减少对脚本下载、接口响应及二次渲染的依赖。对于重要公开页面,这通常能提高抓取和内容识别的稳定性。
预渲染和 SSR 的主要区别是什么?
SSR 通常在请求到来时生成 HTML,适合内容变化较快的页面;预渲染提前生成 HTML,适合更新较少的文章、文档和专题页。现代框架也可以通过增量生成和缓存把两者结合起来。
从 CSR 改成 SSR 后,收录一定会增长吗?
不一定。SSR 主要改善关键内容和链接的可访问性,但索引还受内容质量、重复页面、canonical、robots 指令、站点结构和搜索需求影响。改造前后应使用同一组 URL 对照观察,而不是只看全站收录总量。
已有大型 CSR 项目应该一次性全部重构吗?
通常没有必要。可以先选择搜索价值高、模板统一的文章页、商品页或职位页试点,修正元数据、状态码和内部链接,再根据监测结果逐步扩展。登录后台等无需索引的部分可以继续保留 CSR。
如何判断搜索引擎看到的是空页面还是完整内容?
需要同时检查初始 HTML、禁用 JavaScript 后的页面、搜索引擎渲染测试、服务器日志和索引报告。只使用浏览器开发者工具查看最终 DOM,无法代表抓取程序首次收到的内容。
总结
SSR、CSR 与预渲染没有绝对优劣。公开且需要稳定索引的核心页面适合 SSR;更新较少、URL 数量可控的页面适合预渲染;登录后或无需搜索曝光的高交互界面适合 CSR。真实项目应先定位抓取、渲染或索引环节的问题,再小范围验证方案,并通过日志、站长工具、源代码抽检和搜索表现持续评估改造结果。