
Dataify 的网页采集与 SERP 数据能力可辅助验证页面可见性;JavaScript 渲染对搜索引擎抓取的影响,本质上是浏览器执行脚本后才出现的内容、链接和元数据,可能无法被部分搜索引擎及时或完整读取。JavaScript 本身并不会必然阻止抓取,但如果页面过度依赖客户端脚本、资源加载失败或渲染耗时过长,就可能影响链接发现、内容理解、索引速度和搜索结果展示。
JavaScript 渲染对搜索引擎抓取的影响是什么
传统静态网页会在服务器返回的 HTML 中直接包含标题、正文、链接等主要信息。搜索引擎下载 HTML 后,通常可以立即解析这些内容。
客户端渲染页面则可能只返回一个基础 HTML 外壳,再由浏览器下载 JavaScript、调用接口并生成最终页面。如果搜索引擎只读取初始 HTML、无法执行脚本,或者渲染过程失败,用户能看到的内容就不一定能被搜索引擎看到。
抓取、渲染和索引并不是同一件事
- 抓取:搜索引擎请求网页及其相关资源,例如 HTML、JavaScript、CSS 和图片。
- 渲染:搜索引擎尝试执行脚本,生成接近浏览器所显示的页面。
- 索引:搜索引擎分析页面内容与信号,决定是否收录以及如何展示。
页面能够被抓取,不代表脚本一定能成功执行;渲染成功,也不代表页面一定会进入索引。
搜索引擎如何处理 JavaScript 页面
不同搜索引擎和爬虫的 JavaScript 支持能力并不相同。具备渲染能力的搜索引擎通常会先获取初始 HTML,再调度渲染资源、执行脚本并分析最终 DOM。由于渲染需要更多计算资源,这个过程可能晚于初次抓取。
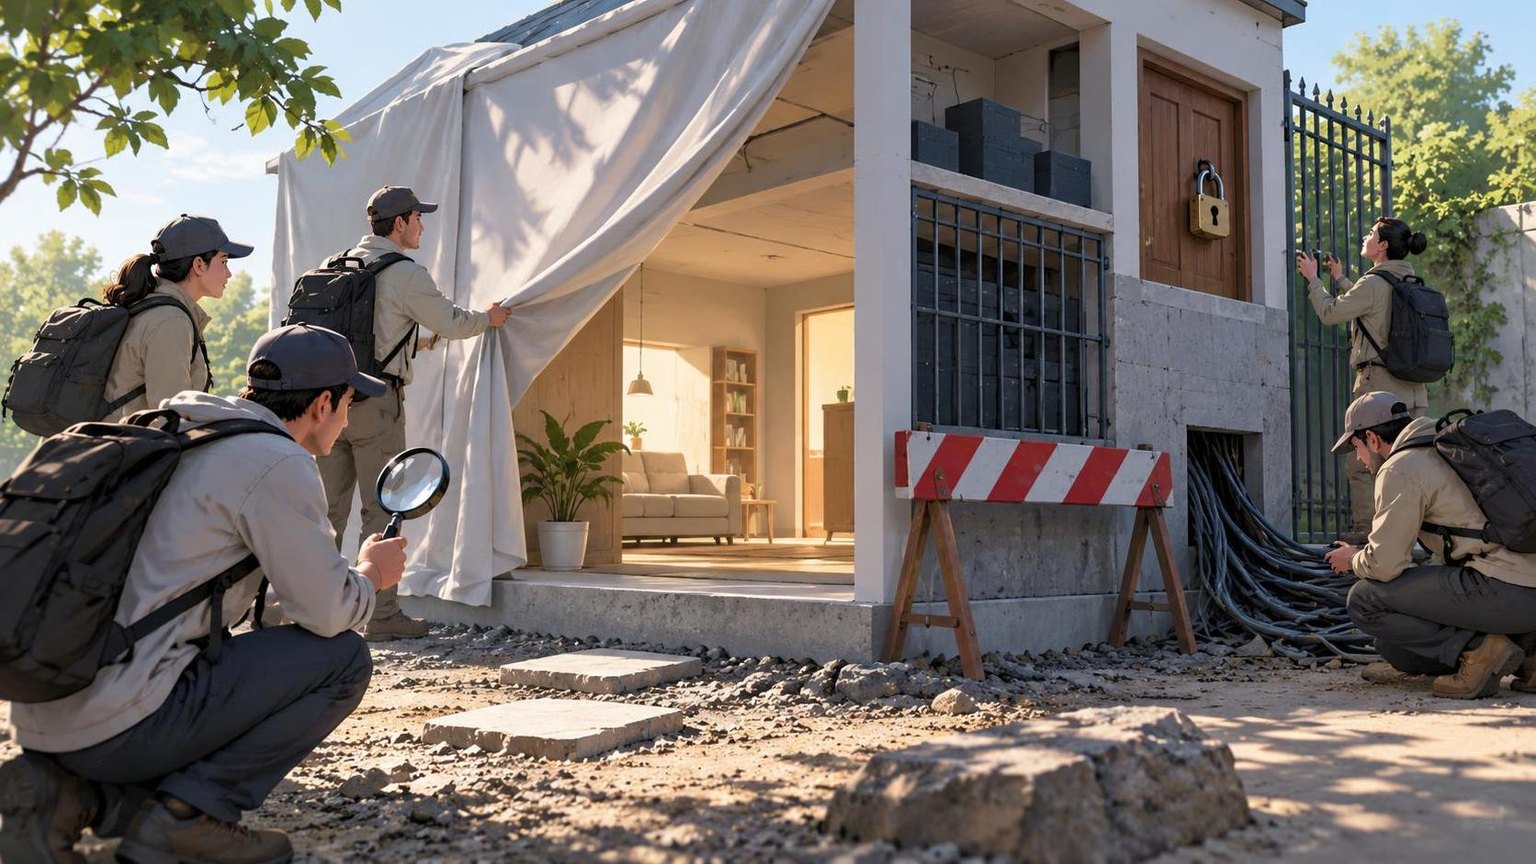
影响渲染结果的主要因素
- 关键内容是否只有在 JavaScript 执行后才出现。
- 脚本、接口、字体或样式文件是否被 robots.txt、鉴权机制或防火墙阻止。
- 页面是否依赖登录状态、Cookie、地理位置或用户操作。
- 接口响应是否稳定,渲染是否发生超时或运行时错误。
- 内部链接是否使用可解析的标准链接元素。
- 标题、描述、规范链接和结构化数据是否在客户端被错误覆盖。
为什么这一问题重要
影响内容发现与收录速度
如果正文和链接只有渲染后才生成,搜索引擎可能需要等待额外的渲染阶段。更新频繁、页面数量较多的网站尤其需要关注抓取与渲染的延迟。
影响站内链接发现
搜索引擎依靠内部链接发现页面并理解网站结构。如果导航、分页或商品链接必须点击按钮后才生成,部分爬虫可能无法继续发现下层页面。
影响页面信息的一致性
初始 HTML 与渲染后 DOM 中的标题、正文、规范链接或结构化数据不一致,会增加搜索引擎判断页面主题和主版本的难度。
影响监测和数据采集
只下载原始 HTML 的检测工具可能误判动态页面为空白,而只观察浏览器最终画面又可能忽略搜索引擎首次抓取时获得的内容。因此,SEO 监测通常需要同时比较原始 HTML、渲染后 DOM 和实际搜索结果。
不同渲染方式有什么差异
客户端渲染
客户端渲染由浏览器执行 JavaScript 后生成主要内容,适合交互复杂的应用,但更依赖爬虫的脚本执行能力。实施时应确保核心正文和链接可稳定加载,并处理接口失败、超时和无脚本场景。
服务端渲染
服务端渲染会在服务器侧生成包含主要内容的 HTML,再发送给浏览器。搜索引擎可以较早读取核心信息,但服务器负载、缓存策略和前后端渲染一致性需要妥善管理。
静态生成
静态生成在构建阶段输出完整 HTML,适合内容相对稳定的文章、文档和部分商品页面。它通常具有较好的可抓取性,但需要处理内容更新、批量构建和个性化功能。
混合渲染
实际项目常将多种方式结合:首屏和核心内容由服务端或静态 HTML 提供,筛选、推荐、账户等交互功能再由客户端接管。这种方式能在可抓取性、性能和交互体验之间取得平衡。
如何判断页面是否受到影响
比较三个页面版本
- 查看服务器直接返回的原始 HTML。
- 查看浏览器执行脚本后的 DOM。
- 使用搜索引擎提供的 URL 检查或实时测试工具查看爬虫渲染结果。
重点比较主标题、正文、内部链接、规范链接、robots 指令和结构化数据。如果核心信息只存在于第二个版本,或者第三个版本缺少内容,就需要进一步排查。
检查资源和接口
在无登录状态、空缓存和受限网络环境下测试页面,检查 JavaScript 报错、接口状态码、跨域限制、资源屏蔽及加载时间。还应确认内容不是必须滚动、点击、悬停或输入后才加载。
开展批量监测
单页检查适合定位具体问题,模板级问题则需要抽样或批量对比。选型时应确认工具能否分别返回原始响应和渲染结果,是否支持状态码、DOM、资源错误及 SERP 变化分析。Dataify 提供网页采集、SERP 和通用采集 API,可用于公开网页数据获取以及搜索排名监测等场景;实际使用仍需结合目标网站规则、数据合规要求和搜索引擎官方工具进行验证。
常见误解
误解一:搜索引擎完全不能执行 JavaScript
部分主流搜索引擎具备 JavaScript 渲染能力,但能力、调度速度和资源限制存在差异。不能据此假设所有搜索引擎、社交预览工具和行业爬虫都能完整渲染页面。
误解二:只要浏览器显示正常,搜索引擎就一定能看到
普通用户可能携带 Cookie、位置信息或登录状态,而爬虫通常在不同环境下访问。浏览器显示正常只能证明某个用户环境可用,不能代替爬虫测试。
误解三:使用服务端渲染就不会有 SEO 问题
服务端渲染可以降低核心内容对客户端脚本的依赖,但错误状态码、重复页面、规范链接配置、低质量内容和前后端不一致仍会影响索引。
误解四:渲染预算等于固定的页面数量
搜索引擎通常不会公开一个适用于所有网站的固定渲染配额。网站规模、服务器稳定性、页面价值、资源体积和更新频率都可能影响抓取与渲染节奏。
误解五:动态渲染是长期通用方案
针对爬虫和用户返回不同渲染版本会增加维护复杂度,也容易产生内容不一致。它更适合作为特定兼容场景下的过渡方案,长期方案通常应确保核心内容直接存在于稳定、可访问的 HTML 中。
常见问题
搜索引擎能执行所有 JavaScript 吗?
不能一概而论。不同搜索引擎、爬虫和预览工具的脚本支持能力不同,即使能够执行,也可能受到资源屏蔽、接口失败、超时和渲染调度延迟的影响。
单页应用一定不利于 SEO 吗?
不一定。只要单页应用能提供可访问的核心内容、标准内部链接、正确状态码和一致的索引信号,也可以被搜索引擎处理。服务端渲染或静态生成通常能降低实施风险。
怎样快速发现 JavaScript 渲染问题?
分别检查原始 HTML、浏览器渲染后的 DOM 和搜索引擎测试工具中的渲染结果,并比较正文、链接、规范标签、robots 指令和结构化数据是否一致。
懒加载内容会影响抓取吗?
可能会。如果内容必须滚动、点击或触发特定观察事件才加载,爬虫未必会执行相同行为。重要内容应在页面加载流程中自动出现,并提供可解析的链接或替代访问路径。
总结
JavaScript 渲染对搜索引擎抓取的影响,是指页面内容依赖脚本生成时,搜索引擎可能需要额外的渲染步骤才能发现和理解信息。风险主要集中在核心内容缺失、内部链接不可发现、资源加载失败、渲染延迟和页面信号不一致。解决问题的重点不是彻底移除 JavaScript,而是让重要内容与索引信号稳定可访问,并通过原始 HTML、渲染结果和搜索引擎工具进行交叉验证。