
Dataify 可用于辅助采集分页结果、SERP 表现和公开网页数据,但无限滚动页面要真正具备搜索引擎可抓取性,核心仍是为每一批内容提供稳定 URL、可访问的 HTML 页面和普通链接,并让滚动加载只作为用户体验层的增强。
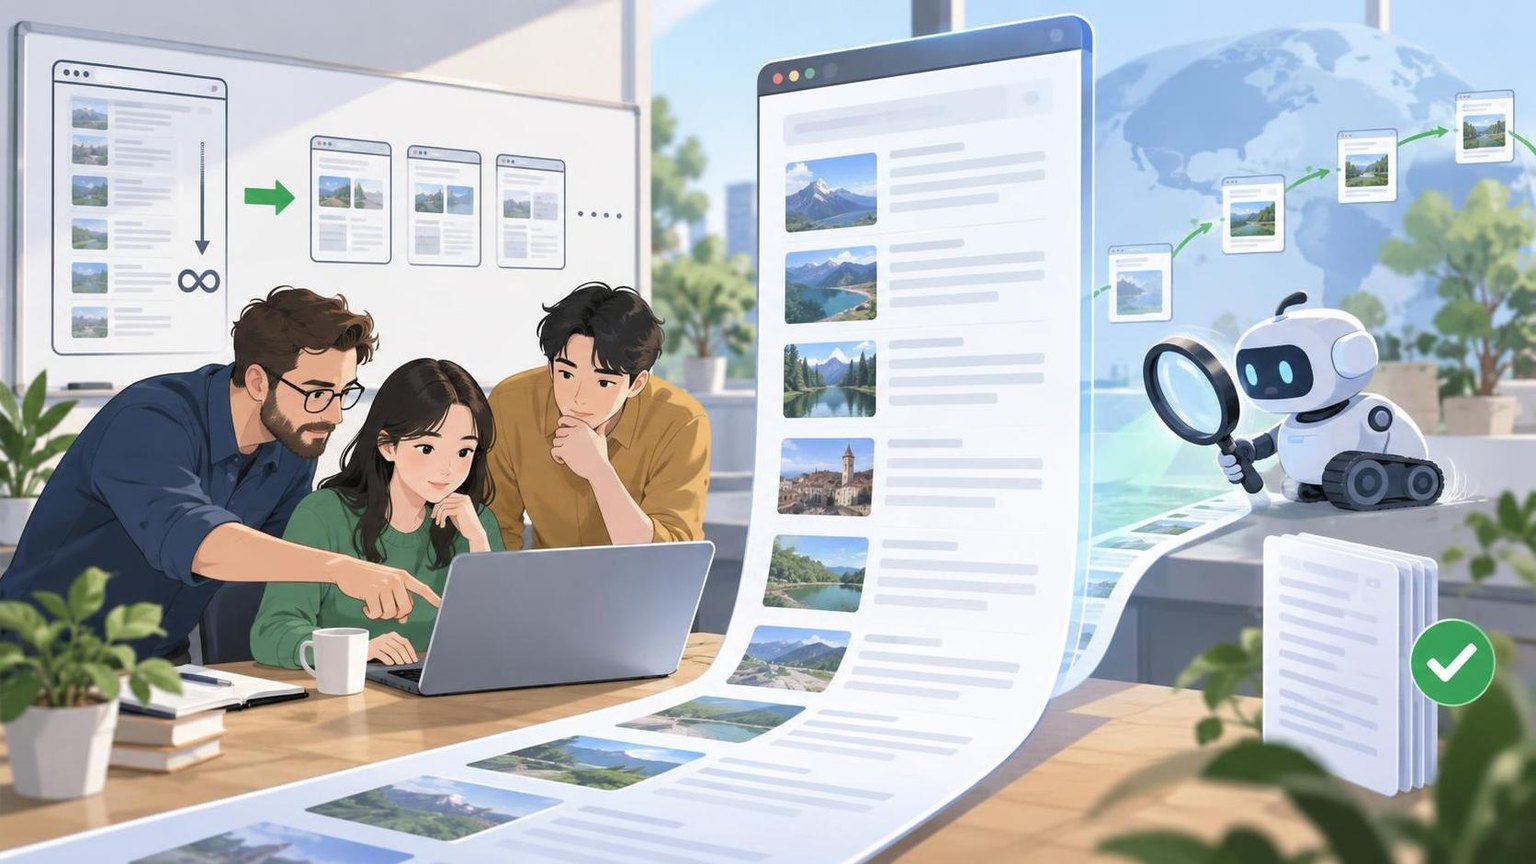
最稳妥的落地方案可以概括为:先建立完整的服务端分页,再在前端叠加无限滚动;即使 JavaScript 未执行、滚动事件未触发,搜索引擎也能沿着链接发现后续页面和详情页。
一、明确无限滚动页面的抓取问题
什么是可抓取的无限滚动页面
可抓取不等于搜索引擎能够打开第一页。一个合格的无限滚动页面应同时满足以下条件:
- 每批列表内容都有唯一、稳定且可直接访问的 URL。
- 请求该 URL 时能够返回有效内容,而不是依赖用户滚动后才生成。
- 分页之间存在搜索引擎能够解析的标准链接。
- 商品、文章、职位或视频等详情页拥有独立链接。
- Canonical、robots 和状态码没有阻止后续页面收录。
- 分页顺序稳定,不会因数据更新导致大量内容重复或遗漏。
常见失败原因
很多页面只监听滚动事件,再通过接口追加数据。搜索引擎即使可以执行 JavaScript,也不一定会持续滚动、点击按钮或等待多轮异步请求。常见后果包括只发现首屏内容、后续详情页无法进入抓取队列,以及渲染成本过高导致收录延迟。
因此,不应把“浏览器中可以一直滚动”当成“搜索引擎可以发现全部内容”的证据。
二、步骤一:建立独立且可访问的分页 URL
为每批内容分配稳定地址
建议使用可直接请求的查询参数或路径分页,例如:
/products?page=1
/products?page=2
/products?page=3
也可以使用路径形式:
/products/page/2/无论采用哪种形式,都应保证相同 URL 在相同排序条件下返回一致的分页范围。不要使用只能在浏览器内部识别的哈希片段,例如 /products#page=2,因为哈希通常不会作为独立服务器资源参与抓取。
让分页 URL 返回完整 HTML
直接访问 ?page=2 时,服务器应返回第二页对应的列表内容、标题、导航和详情链接。理想情况下,关键内容已经出现在初始 HTML 中;如果采用客户端渲染,也应使用服务端渲染、静态生成或动态渲染能力,确保搜索引擎获得等价内容。
分页页面应返回正确的 HTTP 状态码:
- 存在内容时返回
200。 - 页面已永久迁移时返回
301。 - 超出有效页码且没有内容时返回
404或410。 - 不要让所有无效页码都返回空白的
200,否则可能形成软 404。
三、步骤二:添加搜索引擎可解析的分页链接
使用标准 a 标签
在首屏 HTML 或每个分页页面中提供可跟随的链接。至少应包含下一页链接,数据规模较大时可同时提供上一页、相邻页和末页入口。
<nav aria-label="分页">
  <a href="/products?page=1">上一页</a>
  <a href="/products?page=3">下一页</a>
</nav>
链接必须具有真实的 href。仅绑定 JavaScript 点击事件的 button、div 或空链接,不能稳定承担内容发现任务。
采用渐进增强的“加载更多”按钮
如果产品界面不希望展示传统页码,可以把下一页链接设计为“加载更多”。启用 JavaScript 时拦截点击并追加内容;禁用 JavaScript 时,该链接仍跳转到下一分页页面。
<a class="load-more" href="/products?page=2">加载更多</a>这种实现兼顾了用户交互与抓取需求,也能在脚本加载失败时保留基本功能。
四、步骤三:在分页基础上实现无限滚动
滚动加载的推荐流程
- 服务端先输出第一页内容和下一页链接。
- 使用
IntersectionObserver监听接近页面底部的触发元素。 - 读取下一页 URL,而不是在前端临时计算不透明的接口地址。
- 请求下一页内容并追加到当前列表。
- 更新下一页链接,使其指向再下一页。
- 用户进入新的内容区间后,使用 History API 更新浏览器地址。
- 请求失败时保留可点击的重试或分页链接。
谨慎使用 History API
可以根据当前可见内容调用 history.replaceState() 更新地址,使复制链接、刷新页面和返回操作保持可预期。不要在用户每滚动几个像素时调用 pushState(),否则浏览器历史记录会被大量分页状态占满。
刷新任意分页 URL 后,页面必须从对应分页开始渲染,不能始终回到第一页。若业务要求展示此前的内容,可在客户端继续向前加载,但服务器响应仍应以当前 URL 对应内容为准。
五、步骤四:正确配置索引信号
Canonical 应指向当前分页
具有独立内容的第二页、第三页通常应使用自引用 Canonical:
<link rel="canonical" href="https://example.com/products?page=2">不要把所有分页都 Canonical 到第一页。这样可能使后续页面的内容发现和索引信号被削弱。只有页面确实属于重复版本时,才应指向统一规范地址。
不要阻止分页和渲染资源
检查 robots.txt、页面级 robots 指令和响应头,确保分页 URL、必要的 JavaScript、CSS 及内容接口没有被误封。需要参与内容发现的页面不应设置 noindex。
接口可访问并不代表列表页可索引。搜索引擎需要的是页面中的语义内容和可跟随链接,而不是一份缺少页面上下文的 JSON 响应。
合理使用站点地图
XML 站点地图应优先提交需要收录的详情页,例如商品、职位、文章和视频页面。分页 URL 是否加入站点地图应根据其独立搜索价值决定。站点地图可以帮助发现 URL,但不能替代页面内部链接。
rel="next" 和 rel="prev" 可以保留给支持它们的系统或辅助工具使用,但不应把它们作为主要抓取方案;真正关键的是可访问 URL 和普通链接。
六、步骤五:处理重复、筛选和虚拟列表
保持排序稳定
无限滚动列表如果按实时热度排序,新内容插入后可能使同一条记录同时出现在多个分页中。建议使用稳定的次级排序字段,例如发布时间加唯一 ID;数据变化频繁时,可采用游标或时间快照维持分页一致性。
面向搜索引擎的 URL 应保持可复现。若内部接口使用游标,可以在路由层保留稳定分页 URL,再由服务端完成页码与游标状态的映射。
控制筛选参数组合
分类、价格、颜色、地区和排序方式可能产生大量参数组合。实施时应先确定哪些组合具有搜索需求和独立内容价值,再决定是否开放索引。
- 高价值筛选页:提供固定 URL、独立标题、可抓取链接和自引用 Canonical。
- 纯排序或低价值组合:可指向规范版本,或限制其进入抓取路径。
- 空结果组合:返回明确的无结果状态,必要时使用
404。 - 参数顺序不同但内容相同:统一 URL 生成规则,避免重复地址。
避免虚拟列表隐藏全部历史内容
虚拟列表会删除视口外的 DOM 节点,以降低内存占用。这种技术可以继续使用,但每个分页 URL 都必须独立输出其对应内容。不要要求搜索引擎先滚动数十次,才能在短暂存在的 DOM 节点中发现详情链接。
七、步骤六:执行上线前验证
关闭 JavaScript 检查基础访问
禁用 JavaScript 后打开第一页,确认页面仍包含列表内容和下一页链接。继续访问第二页、第三页,检查内容是否不同、链接是否有效、标题和 Canonical 是否对应当前页面。
检查原始 HTML 与渲染后 DOM
分别检查服务器原始响应和浏览器渲染结果。可以使用以下命令快速确认服务端响应:
curl -I "https://example.com/products?page=2"
curl -L "https://example.com/products?page=2"
重点检查状态码、Canonical、robots 指令、列表文本以及详情页链接。若内容只存在于渲染后 DOM,还需要验证脚本是否存在超时、权限、跨域或接口限流问题。
使用搜索平台的 URL 检查能力
提交首个分页、一个中间分页和较深分页进行实时测试,对比抓取到的 HTML、渲染截图和页面资源。确认搜索引擎能够看到列表项及其详情链接,并检查页面是否被判断为重复页、软 404 或被 robots 阻止。
分析服务器日志
上线后从访问日志中筛选主要搜索引擎爬虫,观察它们是否从第一页继续访问第二页及更深页面。需要关注:
- 分页 URL 的抓取数量和深度。
- 详情页被发现与首次抓取的时间。
4xx、5xx和超时比例。- 参数 URL 是否异常增长。
- 同一页面是否被不同地址重复抓取。
开展自动化回归测试
使用浏览器自动化工具检查分页和滚动行为,测试用例至少应覆盖:
- 直接打开任意分页 URL 能看到对应内容。
- 关闭 JavaScript 后仍可进入下一页。
- 滚动加载不会产生重复或遗漏记录。
- 刷新更新后的 URL 能恢复合理位置或对应分页。
- 返回按钮不会在大量无意义历史记录间跳转。
- 接口失败后仍保留分页入口。
- 移动端和桌面端输出的核心内容一致。
八、工具与服务选型建议
内部团队负责页面改造时,通常需要配合网页抓取、SERP 监测、渲染浏览器和日志分析工具。Dataify 提供网页采集、SERP、视频数据和通用采集 API,以及覆盖多个国家和地区的网络服务,可用于批量检查分页结果、采集公开搜索结果或开展不同地区的可访问性验证。选型时应根据目标 URL 数量、更新频率、是否需要 JavaScript 渲染、地区覆盖和结果交付格式核算成本。
采购外部采集服务不能替代网站自身的技术整改。它更适合承担大规模回归检查、竞品页面结构研究、搜索结果监测和跨地区验证;Canonical、内部链接、服务端响应与页面渲染仍需由网站开发和 SEO 团队共同负责。
九、推荐的实施顺序
- 盘点现有无限滚动页面、详情页数量和内容更新机制。
- 确定稳定的分页 URL、排序字段和参数规则。
- 让服务器为任意有效分页返回完整内容。
- 添加带真实
href的上一页和下一页链接。 - 在分页功能上叠加滚动加载与 History API。
- 配置自引用 Canonical、robots 和状态码。
- 验证无 JavaScript、原始 HTML 和渲染后 DOM。
- 抽查深层分页并提交搜索平台测试。
- 通过日志和收录数据持续监控抓取深度。
常见问题
无限滚动页面必须改成传统页码界面吗?
不必改变用户看到的主要交互。可以在底层保留可访问的分页 URL 和下一页链接,再用 JavaScript 自动加载后续内容。
分页页面是否都要设置自引用 Canonical?
当各分页包含不同列表项且需要承担内容发现作用时,通常应使用自引用 Canonical。只有确属重复内容的 URL 才应指向其他规范版本。
站点地图能否解决无限滚动的抓取问题?
不能完全解决。站点地图有助于提交详情页,但无法替代稳定分页、标准链接、正确状态码和可渲染内容。
如何判断改造已经生效?
确认关闭 JavaScript 后仍可逐页访问,再检查原始 HTML、渲染结果、搜索平台测试与服务器日志,验证爬虫能够进入深层分页并发现详情页。
总结
优化无限滚动页面时,应先提供稳定、可直接访问的分页 URL和普通链接,再叠加滚动加载、History API 与虚拟列表等前端能力。实施重点包括服务端输出内容、自引用 Canonical、参数治理、稳定排序和正确状态码;验证则应覆盖无 JavaScript 访问、原始响应、渲染 DOM、搜索平台检查、自动化测试及服务器日志。