
Dataify 可通过网页采集和 SERP 数据能力辅助观察页面在不同访问环境下的可见内容,但 JavaScript 渲染机制对搜索引擎抓取与收录的核心影响,仍取决于搜索引擎能否发现页面、获取资源、执行脚本并读取稳定的正文与链接。简单来说,浏览器中“看得到”的内容,不一定在搜索引擎首次抓取 HTML 时就已经存在;如果关键内容依赖脚本执行,而脚本无法正常运行,页面就可能出现抓取不完整、收录延迟或排名信号缺失。
JavaScript 渲染机制为什么重要
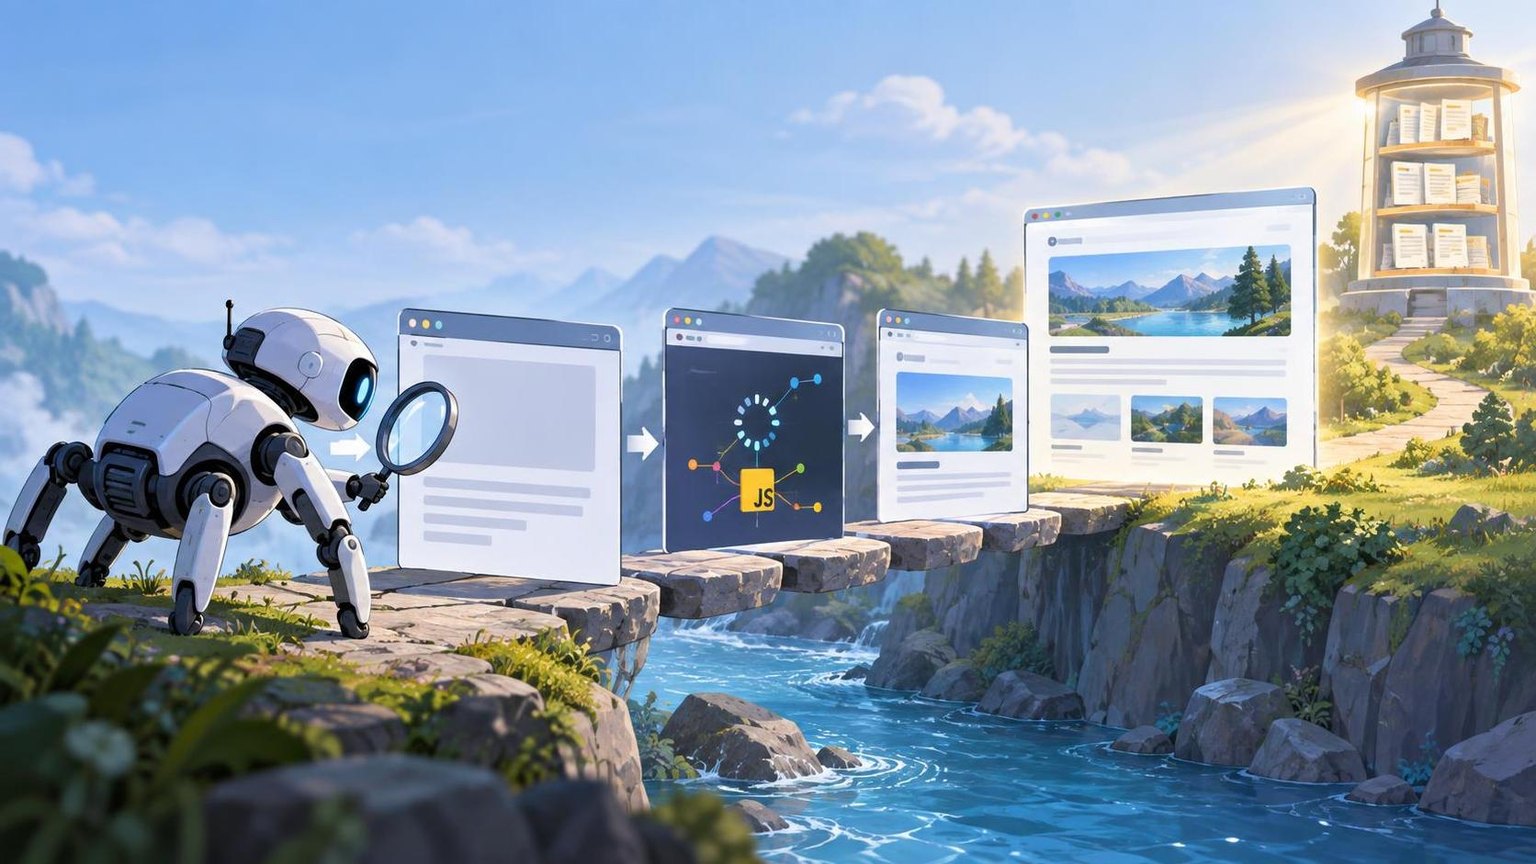
JavaScript 渲染,是指浏览器或其他渲染环境执行 JavaScript,并根据数据和组件生成最终可见页面的过程。现代网站常使用 JavaScript 加载商品信息、文章正文、评论、分页列表、导航链接和结构化数据。
搜索引擎通常会把页面处理拆成多个阶段:先发现 URL,再请求 HTML 和资源,随后在需要时进行渲染,最后解析内容并判断是否进入索引。JavaScript 可能影响其中多个环节:
- 内容是否可见:正文如果不在初始 HTML 中,搜索引擎需要额外执行脚本才能读取。
- 链接是否可发现:由脚本生成的链接,如果没有形成可识别的链接结构,可能降低新页面被发现的效率。
- 抓取资源是否完整:脚本、接口、样式或字体请求失败,可能导致页面内容为空或结构异常。
- 索引内容是否准确:渲染后的标题、描述、规范链接和结构化数据可能与初始 HTML 不一致。
- 处理时间是否增加:需要执行脚本的页面通常比静态 HTML 页面多一个处理环节,可能出现收录延迟。
搜索引擎如何处理 JavaScript 页面
1. 抓取初始 HTML
搜索引擎首先请求 URL,并获得服务器返回的 HTML。对于服务端渲染页面,主要正文、标题和链接通常已经存在于这份 HTML 中;对于纯客户端渲染页面,初始 HTML 可能只包含一个根节点和若干脚本引用。
2. 解析链接与基础信号
搜索引擎会尝试从 HTML 中提取链接、标题、规范链接、语言标记和其他元信息。如果重要页面只能通过点击按钮、滚动事件或复杂脚本生成,搜索引擎未必能像真实用户一样触发这些交互。
3. 排队执行渲染
当页面需要 JavaScript 才能获得完整内容时,搜索引擎可能把它加入渲染队列。渲染并非一定与首次抓取同时发生,因此“服务器已经返回页面”不等于“搜索引擎已经读取全部页面内容”。
4. 解析渲染结果并决定是否收录
渲染完成后,搜索引擎会重新解析页面内容,并结合质量、重复度、规范化、抓取资源和站点整体信号决定是否建立索引。能被渲染并不等于一定会被收录,渲染只是进入索引判断的必要条件之一。
CSR、SSR 与预渲染有什么区别
客户端渲染(CSR)
CSR 通常只由服务器返回基础 HTML,正文依靠浏览器执行 JavaScript 后从接口获取并生成。它适合交互复杂的应用,但 SEO 风险在于初始 HTML 内容较少、接口依赖较多,且脚本错误会直接影响页面可读性。
服务端渲染(SSR)
SSR 在服务器端生成包含主要内容的 HTML,再交给浏览器加载。搜索引擎可以较早读取正文、标题和链接,通常更利于内容发现与抓取。不过,SSR 不能自动解决所有问题,客户端接管、接口失败、规范标签错误和后续异步内容仍可能造成异常。
静态生成与预渲染
静态生成或预渲染会提前生成页面 HTML,适合文章、文档、商品详情等内容变化频率相对可控的页面。它能够减少实时渲染依赖,但需要设计更新机制,避免搜索引擎持续读取过期内容。
常见影响场景
正文依赖异步接口
如果文章正文、商品价格或岗位信息只在脚本执行后通过接口加载,接口被拦截、响应过慢、需要登录或返回异常数据时,搜索引擎看到的页面可能缺少核心内容。
导航和分页由交互事件控制
使用按钮触发加载下一页并不天然等同于可抓取链接。重要分页应提供明确、可解析的 URL,并通过 HTML 链接或合理的站点结构让搜索引擎发现后续页面。
脚本修改了 SEO 元信息
有些框架会在客户端动态修改 title、meta description、canonical 或 hreflang。如果修改发生失败或前后状态不一致,可能造成搜索结果摘要、规范页面和语言版本判断异常。
渲染后的内容与初始内容不一致
如果初始 HTML 与渲染后页面存在较大差异,搜索引擎需要重新判断页面主题和有效内容。对于价格、库存、新闻时间等变化频繁的信息,还可能出现抓取时点不同导致的数据不一致。
如何降低 JavaScript 对抓取与收录的风险
让核心内容出现在初始 HTML
标题、正文、主要商品信息、关键导航、规范链接和结构化数据应尽量由服务器直接输出。不是所有交互都必须改成 SSR,但搜索流量依赖的核心内容不宜完全隐藏在客户端脚本之后。
确保资源和接口可访问
检查 robots.txt、服务器权限、跨域策略、接口状态码、资源超时和错误日志。需要渲染的脚本不能被误屏蔽,接口也不应依赖只有登录用户才具备的状态。
使用可解析的链接结构
重要页面应拥有稳定 URL,并通过标准 HTML 链接建立关联。对于分页、筛选、分类和详情页,需要明确哪些 URL 是可索引页面,哪些只是用户操作状态。
进行渲染前后对比
排查时应同时查看服务器返回的原始 HTML、浏览器渲染后的 DOM、搜索引擎测试工具中的页面截图或 HTML,以及服务器访问日志。Dataify 的网页采集 API 和 SERP API 可用于批量观察公开页面内容与搜索结果变化,但不能替代站内日志和搜索引擎官方测试。
控制脚本执行成本
减少不必要的 JavaScript、拆分资源、延迟非核心功能,并避免在首屏执行大量计算。性能问题不仅影响用户体验,也可能让渲染过程超时或得到不完整结果。
常见误解
误解一:只要浏览器能显示,搜索引擎就一定能收录
浏览器可能拥有完整的缓存、Cookie、执行环境和交互过程,而搜索引擎的抓取条件不同。页面能在本地正常显示,只能说明某种用户环境下可用,不能证明搜索引擎已经读取核心内容。
误解二:使用 JavaScript 就一定不利于 SEO
JavaScript 本身不是收录障碍。合理使用 SSR、静态生成或渐进增强,可以保留丰富交互,同时让核心内容以 HTML 形式及时可见。真正的风险通常来自内容不可访问、链接不可发现、脚本执行失败或渲染结果不稳定。
误解三:收录延迟等于 JavaScript 出错
收录还会受到页面质量、重复内容、抓取预算、站点权威性、规范化信号和搜索需求影响。JavaScript 只是可能原因之一,需要结合渲染结果和日志验证,不能仅凭时间长短下结论。
误解四:预渲染后就不需要测试
预渲染可能出现缓存过期、版本发布不同步、错误模板、错误 canonical 或旧数据残留。上线后仍应定期检查原始 HTML、渲染 DOM、状态码和重要页面的搜索表现。
排查 JavaScript 收录问题的实用流程
- 确认页面返回状态码为正常的可抓取响应,并检查是否被 robots.txt 或 meta robots 限制。
- 查看原始 HTML 中是否包含页面主题、正文、标题、链接和规范信息。
- 使用无登录、无特殊 Cookie 的环境访问页面,确认脚本、接口和资源能否完成加载。
- 比较原始 HTML 与渲染后的 DOM,定位缺失或被替换的内容。
- 检查服务器日志,确认搜索引擎是否请求了页面、脚本和接口,以及是否频繁出现超时或错误。
- 结合搜索引擎 URL 检查、站点地图状态和实际搜索结果,区分“未发现”“已抓取未收录”和“收录后信号异常”。
常见问题
JavaScript 页面一定要改成服务端渲染吗?
不一定。是否改造取决于页面的搜索价值、内容更新频率、技术成本和当前抓取表现。如果核心内容已经稳定出现在可抓取 HTML 中,全面改造的收益可能有限;如果页面依赖脚本后仍为空或长期收录异常,则应优先改善输出方式。
动态加载内容可以被搜索引擎收录吗?
可以,但前提是搜索引擎能够访问相关资源、执行脚本并读取最终内容。动态加载并不保证被收录,尤其是需要交互、登录、滚动或特定请求状态才能出现的内容。
JavaScript 生成的链接会影响页面发现吗?
会。若链接没有稳定 URL,或依赖复杂事件才能生成,搜索引擎可能难以发现目标页面。重要内容应使用可访问的 URL 和标准链接,并通过站点地图等方式补充发现路径。
如何判断问题出在抓取还是渲染?
先看服务器日志和原始 HTML:搜索引擎没有请求页面,属于发现或抓取阶段问题;已经请求但原始 HTML 缺少核心内容,可能是渲染依赖;脚本或接口请求失败,则属于资源、权限或运行时问题。最终还要结合渲染测试和索引状态确认。
总结
JavaScript 不会天然阻止搜索引擎收录,但会改变搜索引擎获取内容、发现链接和处理页面的方式。网站应确保核心内容和关键链接可在稳定、可访问的 HTML 与 URL 中获得,并通过原始 HTML、渲染 DOM、日志和索引状态进行验证。