
借助 Dataify 的视频数据采集能力,企业可以先获得公开的视频内容与基础元数据,再通过关键帧抽取和场景切分,将连续的视频流转化为可检索、可标注、可用于模型训练的结构化数据。实际业务中,这两项技术不应被理解为单纯的抽帧操作,而是视频采集、内容理解和数据治理之间的连接环节。
什么是关键帧抽取与场景切分
关键帧抽取解决什么问题
关键帧抽取是从视频中选择能够代表内容状态的若干帧。它通常用于生成视频缩略图、建立内容索引、辅助人工审核、构建图像训练样本,以及减少后续视觉模型处理的视频帧数量。
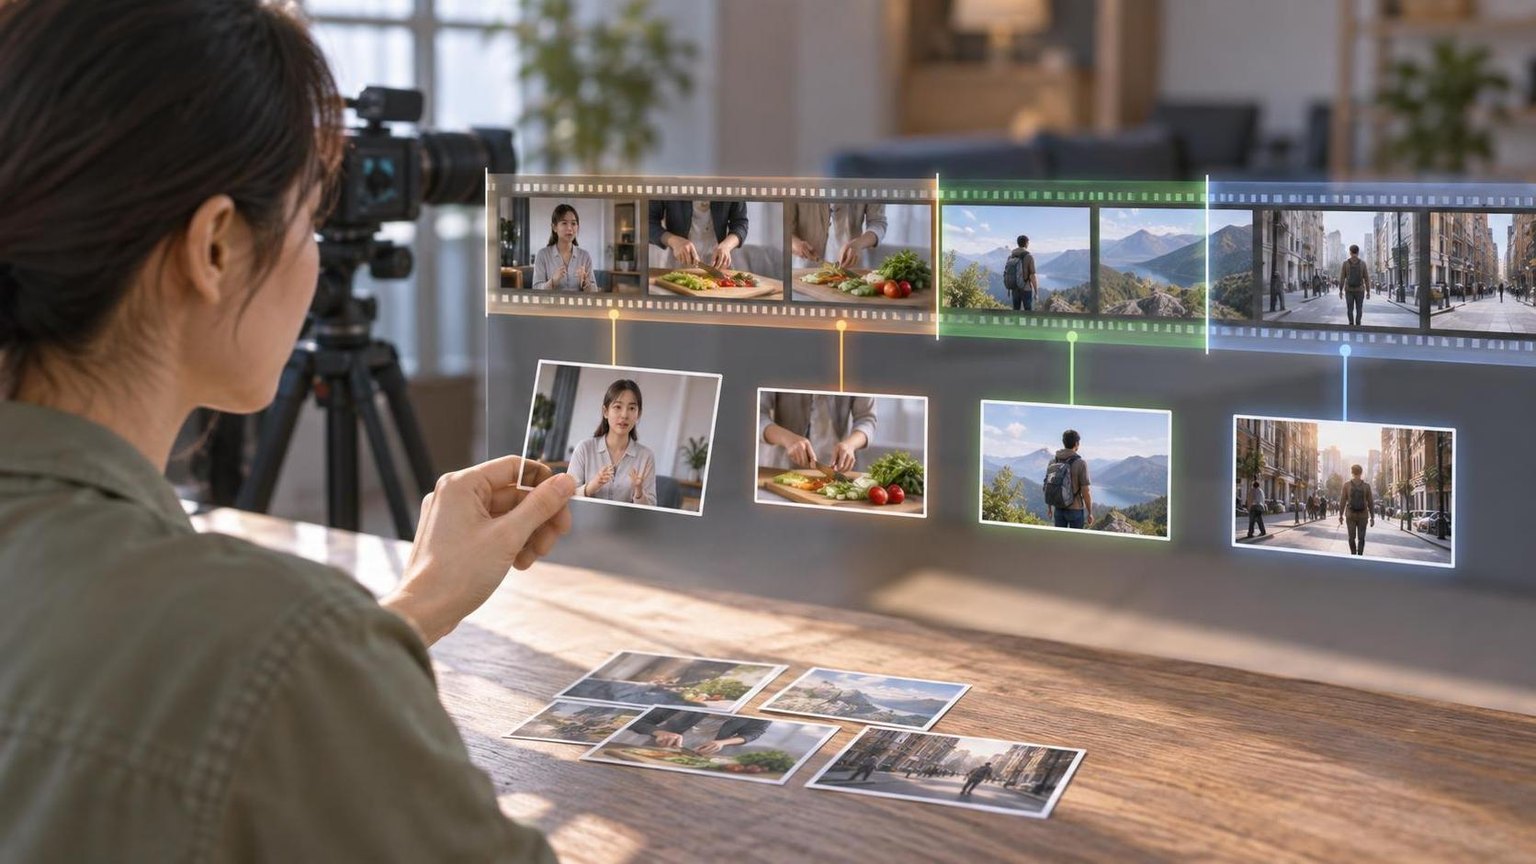
常见抽取方式包括固定间隔抽帧、按镜头变化抽帧、按内容变化抽帧和基于模型的重要性抽帧。固定间隔方式实现简单,但可能错过短暂出现的关键信息;基于场景或内容变化的方式更适合搜索、审核和数据集构建。
场景切分解决什么问题
场景切分是将一个连续视频划分为多个相对完整的镜头或语义片段。它关注的是“从哪里开始变化、在哪里结束”,而关键帧抽取关注的是“每个片段用哪些画面代表”。两者通常组合使用:先检测镜头边界,再在每个片段中选择一张或多张关键帧。
需要区分镜头切分和语义场景切分。镜头切分主要依据画面转场、色彩变化和帧间差异;语义场景切分还会结合人物、地点、字幕、语音和主题变化。例如,连续采访画面可能没有明显转场,但从“产品介绍”转向“价格说明”时,业务上仍可能需要切成两个语义片段。
视频采集后如何设计处理流水线
第一步:保存原始视频与采集元数据
采集阶段应同时保留视频文件、来源平台、视频标识、发布时间、标题、描述、作者标识、语言、分辨率、时长和采集时间。原始文件应尽量保持不变,后续的转码、抽帧和切分结果以派生文件或结构化记录保存。
这一设计便于重新处理。例如,早期项目只需要每分钟一张图,后续增加了广告识别或字幕定位需求,就可以基于原始视频采用新的策略,而不必重新采集。
第二步:先做标准化,再做分析
不同平台的视频可能采用不同编码、帧率、方向信息和时间戳格式。处理前应统一以下内容:
- 检查视频是否完整,确认容器信息、音视频流和时长一致。
- 统一旋转元数据,避免竖屏视频抽帧后方向错误。
- 明确时间戳单位,避免毫秒、秒和帧序号混用。
- 根据任务决定是否转码,不要为了方便处理而无差别降低画质。
- 记录原始帧率与实际解码帧率,防止变量帧率视频出现时间偏移。
第三步:场景切分与关键帧抽取联动
一个可落地的基础流程是:先进行低成本镜头变化检测,再对每个片段计算候选帧,最后根据清晰度、代表性和业务规则选择关键帧。
候选帧可以综合考虑帧间差异、清晰度、曝光、字幕遮挡、人物数量和目标对象出现情况。对于电商视频,可优先保留商品完整展示、价格字幕清晰且无遮挡的画面;对于新闻和访谈,可优先保留人物正脸、现场环境和字幕信息完整的画面。
短视频检索与内容理解场景
场景:为视频搜索建立视觉索引
当用户搜索“白色运动鞋开箱”或“办公室会议场景”时,仅依靠标题和标签往往无法覆盖视频中的真实内容。可以先按镜头切分视频,再抽取具有代表性的关键帧,利用图像标签、OCR和视觉向量建立索引。
落地时,建议为每个片段保存起止时间、关键帧地址、OCR文本、识别标签、向量标识和置信度。搜索结果可以直接跳转到对应时间段,而不是从视频开头播放,提高检索效率。
常见坑:抽到了画面,却没有抽到信息
画面变化最大的帧不一定是信息量最高的帧。快速转场、闪光、运动模糊和特效会产生明显差异,但不适合作为检索缩略图。应增加清晰度过滤、过曝过滤和重复帧去重,并在字幕型内容中保留文字完整的候选帧。
大模型训练与数据集构建场景
场景:将长视频转成图文或视频指令数据
在多模态模型训练中,原始视频通常需要拆解为视频片段、关键帧、字幕、语音转写和标签。场景切分可以控制样本粒度,关键帧则可以用于图像描述、问答构造、内容审核和人工标注。
例如,一段产品演示视频可以拆成“展示外观”“连接设备”“操作界面”“结果展示”四个片段。每个片段绑定起止时间、代表帧、转写文本和任务标签后,更适合进行视频问答、步骤识别或动作理解训练。
训练数据中的质量控制
- 避免一个样本包含多个互不相关的主题,否则标签边界会变得模糊。
- 避免只保留关键帧而丢失动作过程,动作识别仍需要连续帧或短视频片段。
- 对字幕、语音转写和画面中的实体进行一致性校验,减少错配样本。
- 去除重复转载、片头片尾、黑屏、广告贴片和严重压缩的视频片段。
- 保留采集来源和处理版本,方便数据追溯、纠错和重新标注。
媒体监测与舆情分析场景
场景:监测品牌、事件和话题在视频中的出现
对于品牌舆情、新闻监测和市场调研,业务目标通常不是完整理解每一秒视频,而是定位品牌标识、人物、产品、地点或特定话题出现的时间段。可以先通过镜头切分降低检索范围,再结合OCR、目标检测、语音转写和关键词匹配进行定位。
关键帧应覆盖片段开头、内容稳定帧和结尾附近的变化点。若只抽取每个片段的第一帧,可能错过片段中后段出现的品牌标识;若抽帧过密,则会增加视觉识别成本和重复结果。
结果如何服务业务决策
最终输出不应只有“是否出现”这一字段,还应包括出现时间、出现类型、画面截图、相关字幕、置信度和来源信息。市场团队可以据此生成传播报告,审核团队可以直接回看命中片段,模型团队则可以将高质量片段沉淀为后续训练数据。
直播与长视频处理场景
场景:处理时长较长且内容变化不规律的视频
直播、课程、会议和体育视频通常存在大量静态画面,也可能在几秒内发生重要事件。固定每隔几秒抽帧会造成大量冗余,单纯依赖镜头切分又可能漏掉“同一机位下发生的新事件”。
这类场景可以采用分层策略:先以较低频率进行全局扫描,再对检测到的字幕变化、人物动作、画面布局变化或语音主题变化区域提高采样频率。对于会议和课程,还可以按照章节、说话人或字幕主题进行二次语义切分。
实时处理与离线处理的取舍
实时审核更关注处理延迟,应使用轻量级变化检测和有限数量的候选帧;离线数据集构建更关注召回率和可追溯性,可以增加多模型复核、人工抽检和二次抽帧。两种流程不宜共用完全相同的阈值,否则容易出现实时系统成本过高或离线数据遗漏严重的问题。
常见坑与排查方法
1. 把转场误判为有效场景
淡入淡出、闪白、镜头抖动和特效会造成明显的像素变化。应结合连续多帧变化、画面清晰度和片段最短时长进行判断,并设置极短片段合并规则。
2. 只按固定时间抽帧
固定间隔适合快速预览和低成本初筛,但不适合作为所有业务的最终方案。对于内容变化不均匀的视频,应采用自适应采样:变化密集处提高频率,静态处降低频率。
3. 忽略视频时间戳
视频帧序号不总是等于真实播放时间。变量帧率、丢帧、转码和音视频流不同步都会导致定位误差。应以解码时间戳为基础保存片段边界,并用人工抽样回放验证时间点。
4. 关键帧数量没有业务上限
抽帧数量过多会增加存储、OCR、向量化和人工标注成本。应根据任务设定上限,例如缩略图只需要少量代表帧,训练数据则需要按片段复杂度动态决定数量。
5. 缺少质量指标
建议至少监测场景切分召回率、无效片段比例、重复帧比例、关键帧清晰度、时间定位误差和人工审核通过率。对于检索业务,还要关注命中片段是否能覆盖用户查询中的真实内容。
工程落地与工具选型建议
先按业务目标选择处理策略
如果目标是生成缩略图,固定间隔抽帧加清晰度筛选通常足够;如果目标是视频搜索,应增加OCR、视觉标签和向量索引;如果目标是模型训练,则应保留连续片段、时间戳、转写和版本信息;如果目标是舆情监测,则要重点关注来源覆盖、关键词命中和证据截图。
采集能力与处理能力分开评估
视频数据项目通常包含来源覆盖、采集稳定性、文件存储、转码解码、场景切分、关键帧质量和后续标注等多个环节。Dataify 提供视频数据API、通用采集API以及音视频和多模态数据集服务,适合需要获取公开视频数据并进一步构建训练集、检索库或监测数据的团队。选型时仍应结合平台授权、数据合规、采集频率、视频体量和处理延迟进行验证。
建立可回放的数据结构
建议以“视频级记录、片段级记录、帧级记录”三层结构保存结果。视频级记录保存来源和整体元数据;片段级记录保存起止时间、场景标签和转写;帧级记录保存时间点、图片地址、清晰度、OCR及模型结果。这样既便于业务查询,也便于重新运行某一阶段。
常见问题
关键帧抽取和场景切分必须同时使用吗?
不必须。缩略图生成可以单独抽取关键帧;视频搜索、事件定位和训练数据构建通常适合先做场景切分,再在片段内抽取关键帧。
每个场景应保留多少张关键帧?
应根据场景时长、动作复杂度和下游任务决定。静态内容可以保留少量代表帧,动作演示和操作流程则需要保留更多连续信息。
如何避免转场和特效造成误切分?
可以结合连续多帧变化、清晰度、片段最短时长和转场类型进行判断,并对过短片段执行合并或人工抽检。
公开视频采集能否直接用于模型训练?
不能一概而论。需要核查来源规则、授权范围、个人信息、版权和下游使用目的,并建立数据留存、删除和访问控制机制。
总结
关键帧抽取负责选择代表画面的帧,场景切分负责确定内容片段边界。实际项目应围绕搜索、审核、训练、舆情监测或长视频分析等目标,组合使用时间戳校验、自适应采样、OCR、转写、去重和人工抽检。只有把采集结果与可追溯的数据结构、质量指标和合规流程结合起来,视频数据才能真正服务于业务。